
本页内容
先识别内容,再选择导出格式
- 打开 PDF 与图片解析,上传文件;Office 文件先查看转换后的 PDF,确认页序和内容。
- 按当前界面选择用途、范围与解析方式,检查额度和消耗后确认;出现用途选择时,仅提取内容可选“仅解析提取”。
- 对照原页检查文字、公式、表格和图片;需要修订时,在任务支持的编辑方式中修改并保存。
- 导出时选择格式、表格与图片处理方式。下载后再检查完整文件,Markdown 图片要与正文一起保存。
先用一页代表性内容检查阅读顺序、符号和表格;解析方式、页数与额度以工作台为准。
同一份 PDF,核对 Markdown 与 Word 的实际结果
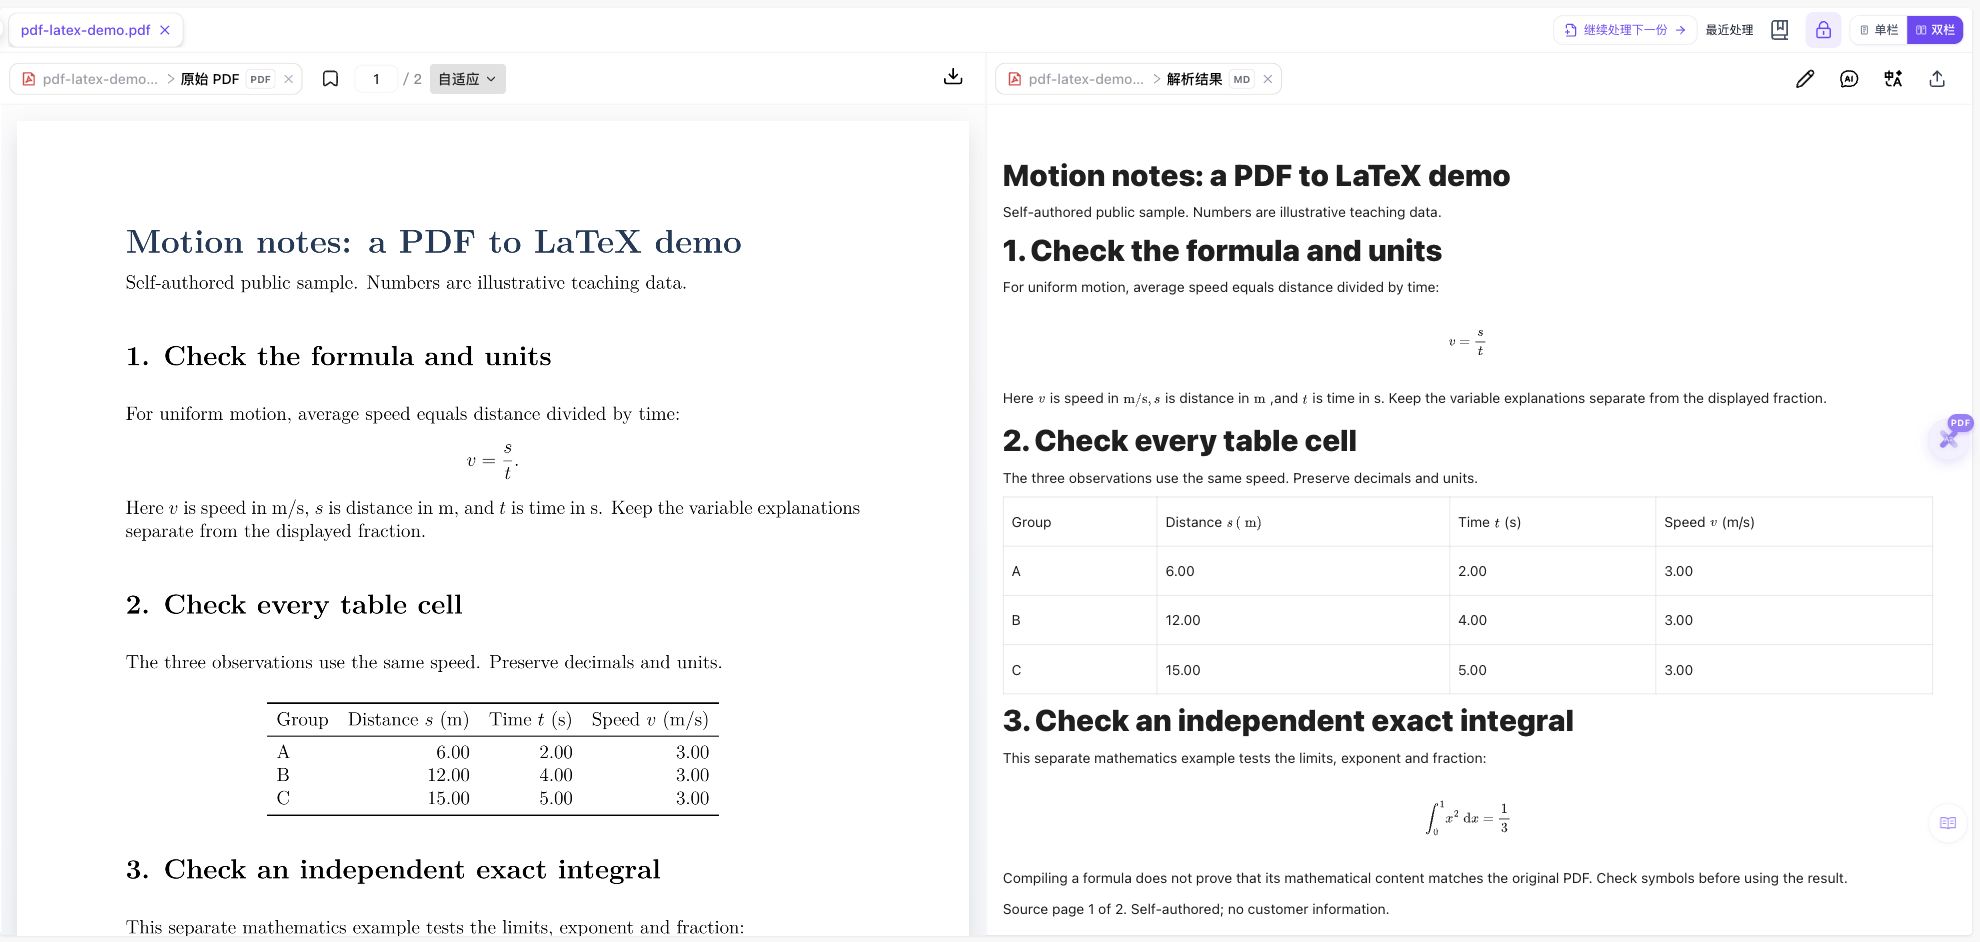
2026年10月11日,复用一份已完成解析的两页自编 PDF,实际导出 Markdown 和流式 Word。原稿标题仍为 “Motion notes: a PDF to LaTeX demo”,内容含两条独立公式、三行数据表和一张图;本次没有重新上传、识别或修改解析内容。
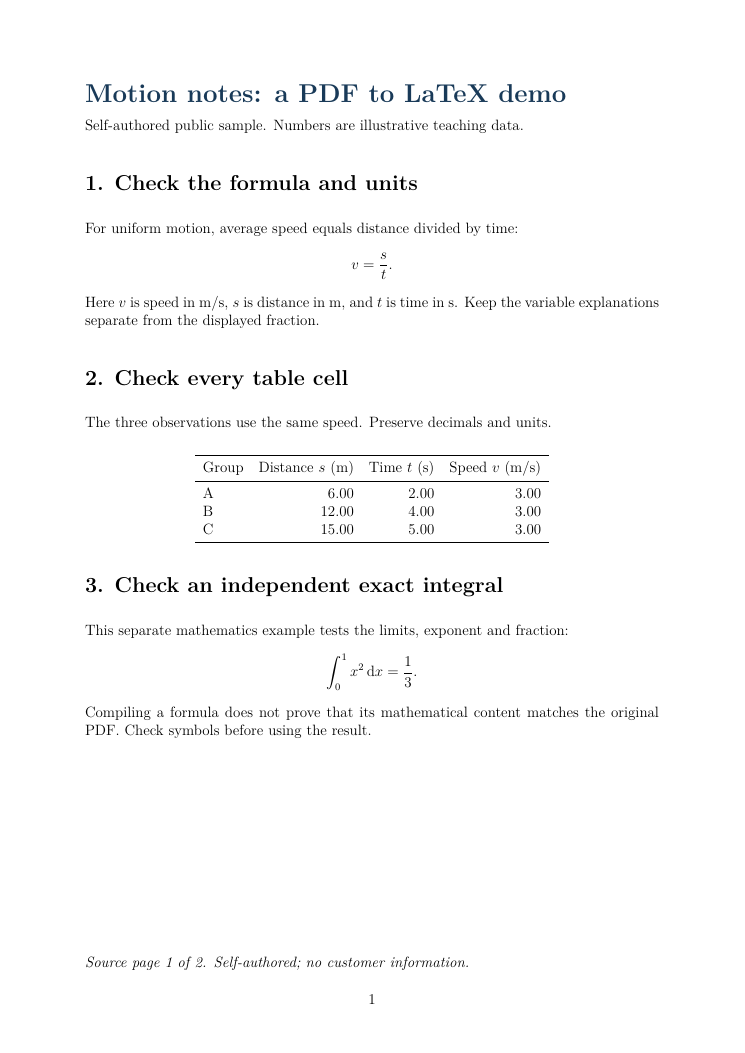
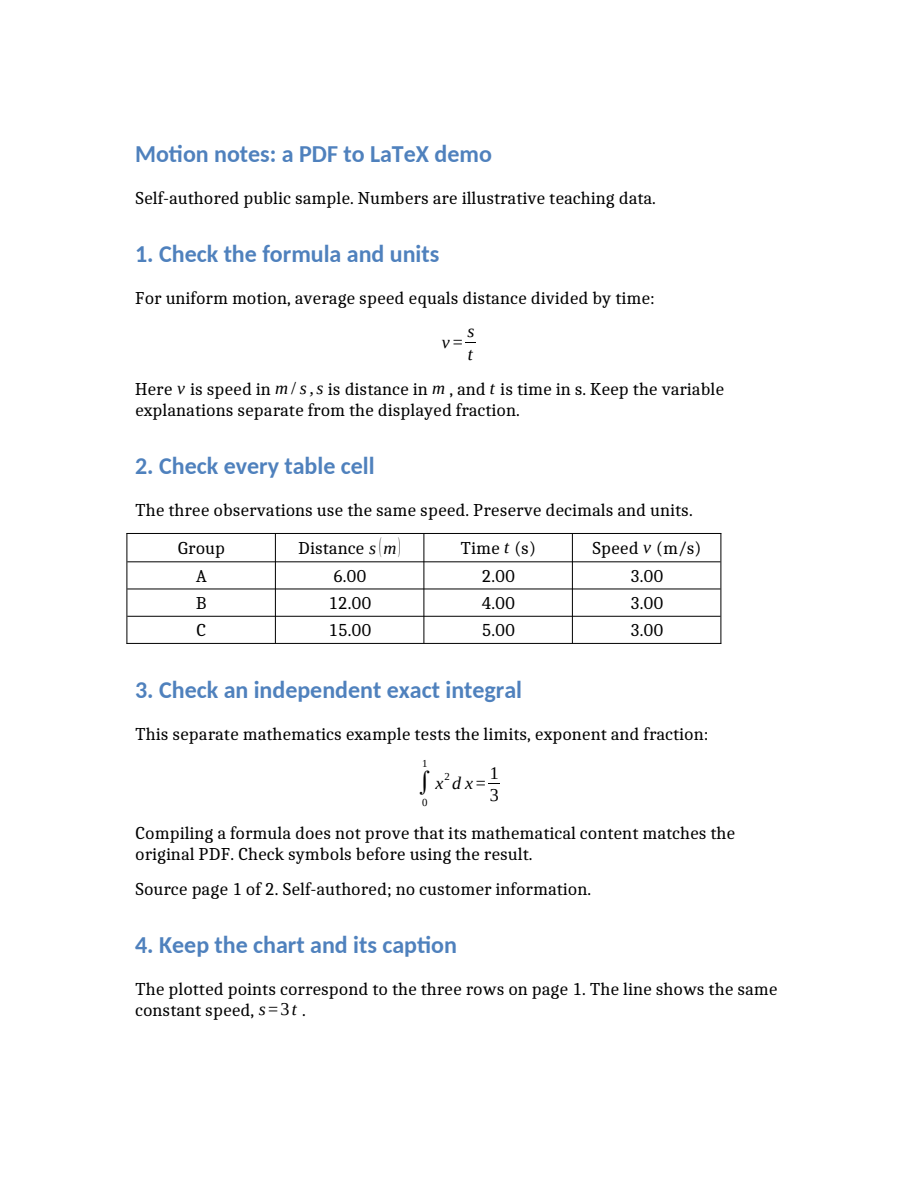
实际 Markdown 的两段原样摘录:分式与三行表格
\[
v = \frac{s}{t}
\]

| Group | Distance \( s\left( \mathrm{\;m}\right) \) | Time \( t \) (s) | Speed \( v \) (m/s) |
| --- | --- | --- | --- |
| A | 6.00 | 2.00 | 3.00 |
| B | 12.00 | 4.00 | 3.00 |
| C | 15.00 | 5.00 | 3.00 |- Markdown 含 6 个二级标题,文稿标题也导出成二级标题;有 2 处独立公式定界和 8 处行内定界,后者包括变量、单位和图表说明。
- Markdown 的三行四列表格与 Word 的原生表格数据一致:A 为 6.00、2.00、3.00;B 为 12.00、4.00、3.00;C 为 15.00、5.00、3.00。
- 普通 Word 含 10 个 Office Math 公式对象、1 张原生表格和 1 张嵌入图片。公式对象数量包含行内变量与单位,不等于十条独立公式。
- Markdown ZIP 的相对图片路径指向包内 images 文件夹;Word 嵌入的是同一张 JPEG。两者都保留解析时漏掉图表顶端说明的情况,可下载原稿第 2 页核对。
- Word 使用流式排版,页面尺寸由原稿 A4 变为 Letter。本地预览仍是 2 页,但第 4 节标题已移到第 1 页末,图表位于第 2 页。
Markdown ZIP 与 DOCX 保留实际下载内容。Word 预览 PDF 由本地 LibreOffice 生成,预览图直接渲染该 PDF;没有在 Microsoft Word 或 WPS 中实测编辑。核对 ZIP 为本地整理。本例是原生文字 PDF,不含扫描页、手写、多栏、代码或跨页表格;也没有导出 API JSON,不能据此推定这些输入与接口的结果。
先了解这几件事
文档解析先把页面内容组织成可核对的标题、正文、公式、表格与图片,再按用途导出文件。其中 OCR(光学字符识别)把图像里的文字识别成文本;格式转换则决定保存为什么文件。PDF、扫描件与图片可从解析入口开始;DOCX、PPTX 先转换成 PDF 预览,再确认解析。识别结构与保留原页排版需要分别判断。
- 输入
- PDF、扫描 PDF 与图片;DOCX、PPTX 先转为 PDF 预览。
- 先核对
- 看原页与解析正文,检查顺序、符号、行列和图表说明。
- 再导出
- 本例实际下载 Markdown 图片包与普通流式 Word。
- 开发接入
- Markdown 与结构化 JSON 的接口说明在开放平台;网页下载选项需分别确认。
按问题找指南
解析完成后,按结果问题继续
先定位问题发生在哪一步,保留已有结果,再决定如何处理。
OCR、文档解析和格式转换怎么选
| 你的任务 | 操作路径 | 先核对的内容 |
|---|---|---|
| 把扫描页或照片里的字变成文本 | 先识别文字,再对照原图核对 | 错字、漏字与段落;模糊或裁切问题先处理 |
| 整理 PDF 的正文、公式、表格与图片 | 解析内容和结构,再逐块检查 | 阅读顺序、公式分组、表格行列和图表说明 |
| 把已有解析结果保存为 Word 或 Markdown | 在结果页选择导出格式与设置 | 是否重排、公式对象及图片依赖 |
| 读取 DOCX 或 PPTX 内容 | 先转成 PDF 预览,再确认解析 | Office 字体、图表和分页是否正常 |
| 批量接入应用或知识库 | 查看开放平台解析与结果接口 | 任务状态、字段、资源链接和当前能力 |
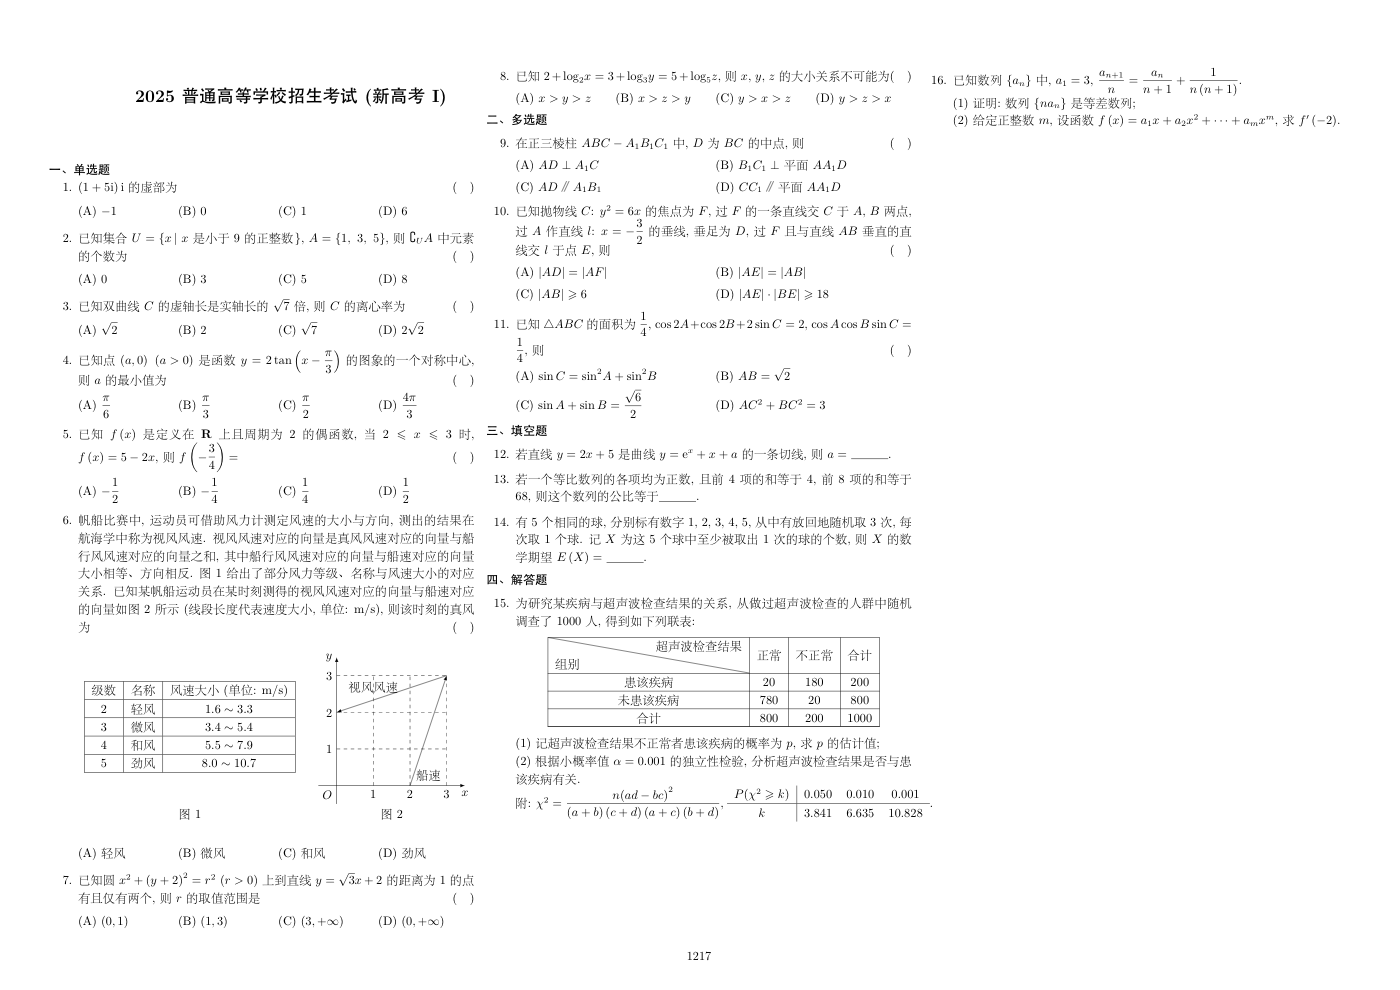
用同一页试卷,核对多栏、公式与表格
 查看原图 ↗
对照同一页的公开解析结果,逐项核对内容与结构
- 第 6 题:先核对风速单位 m/s,再看“2 级、轻风、1.6 ~ 3.3”是否仍对应同一行。表格与旁边的向量图应结合题干分别检查。
- 第 15 题:原表的斜线表头在识别结果中简化为换行文字。逐列核对“正常 / 不正常 / 合计”及其人数,不把内容可读当作原表头版式完全保留。
- 同页的两张主表以表格结构保留,但第 15 题下方的临界值小表被组织为数学矩阵。继续整理数据前,先判断每部分得到的是表格、公式还是图像,不能只按页面外观统计表格数量。
原页与结果来自已有公开解析样例,本次没有重新发起识别。三栏阅读顺序、公式和表格仍需逐项核对;本例不提供对应 Word 或 Excel 成品,也不证明原页排版完全保留或其他复杂文档的识别准确率。
图表核对:曲线在,顶部说明却少了一行
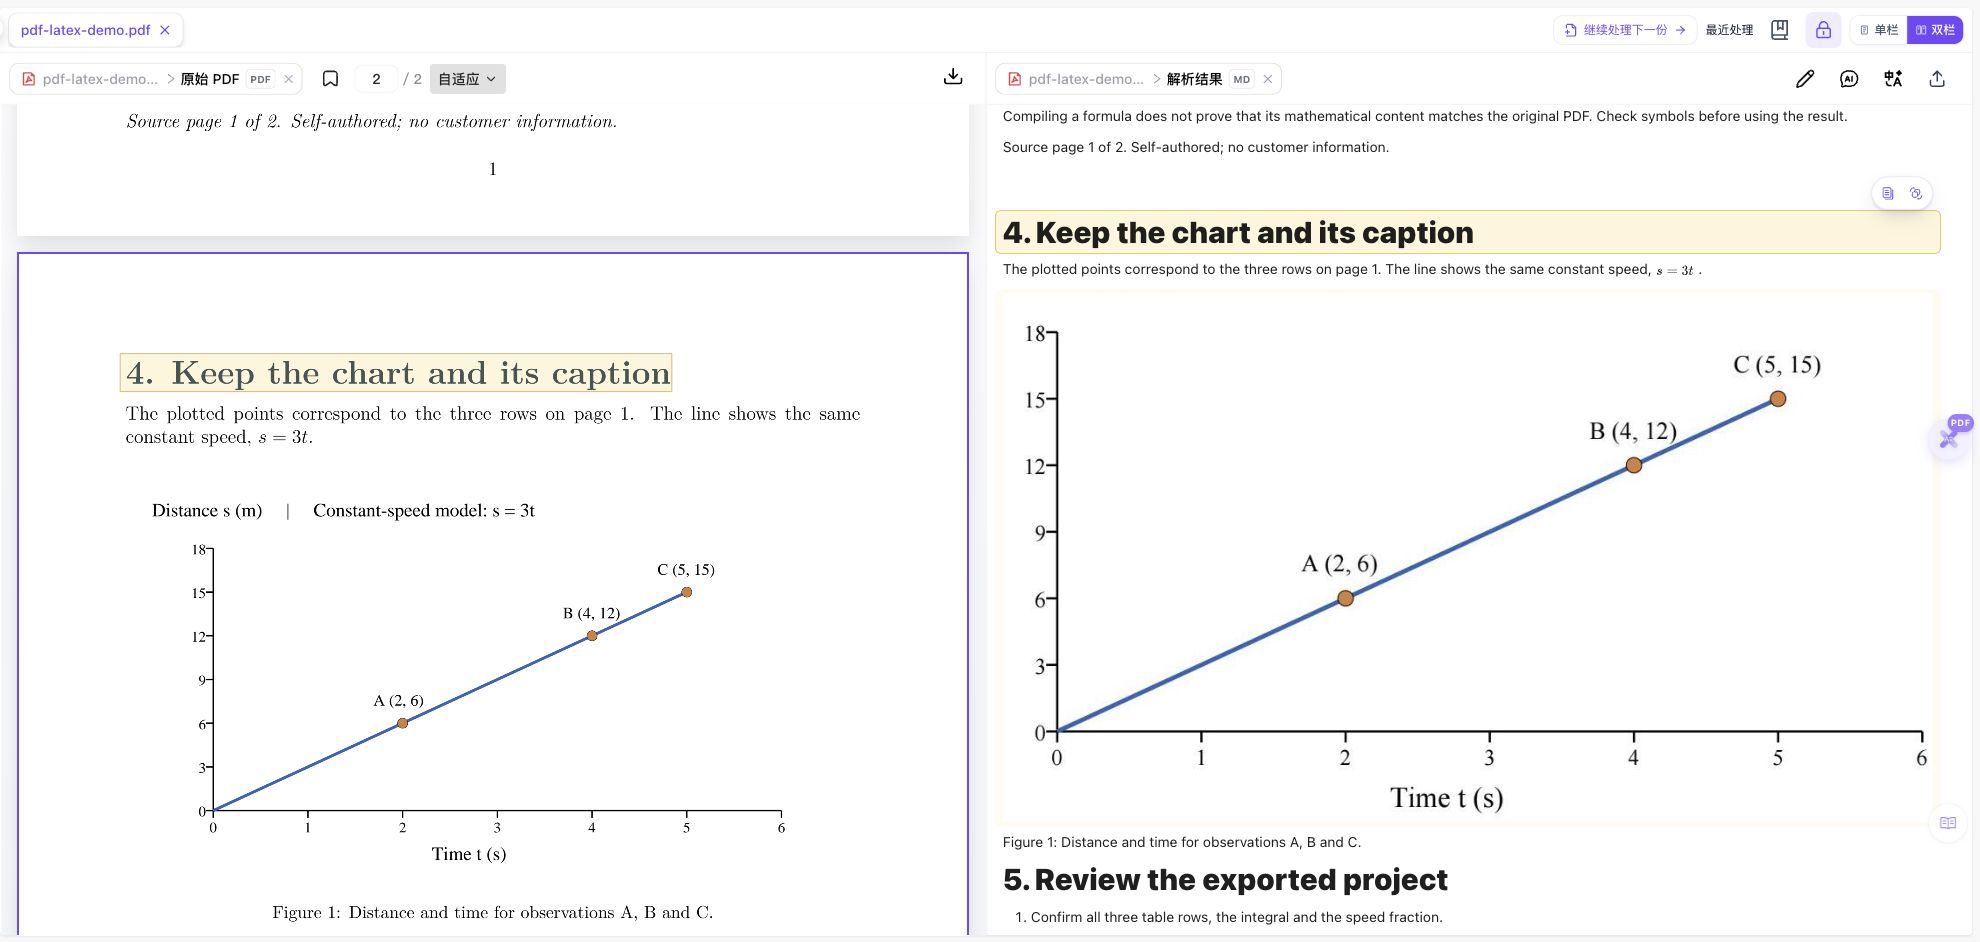
左侧原页图表顶端包含 “Distance s (m)” 和 “Constant-speed model: s = 3t”;右侧解析图片没有这行说明。正文与表格仍保留部分单位,三处信息应一起核对。导出 Markdown 或 Word 都使用同一张图片,不会自动补回遗漏。
PDF 解析先看内容,再看格式
本例将两页内容组织为六个标题、正文、公式、表格和一张图片。标题都成为二级标题,不能把标题存在理解成完整恢复原稿层级。多栏、脚注或跨页续表应另外检查阅读顺序和归属。
回到原页,核对具体内容块
本次点击解析结果里的第 4 节标题,左侧 PDF 从第 1 页跳到第 2 页并高亮对应标题。这有助于逐段校对;本例只核对了这个标题的定位,其他内容块仍以实际任务表现为准。
公式与表格,用数字和符号逐项比对
先核对速度分式 v = s/t 和定积分的上下限、平方及 1/3,再检查三行小数与表头单位。公式能显示、文件能下载,都不能代替和原页比较;有些行内单位也会作为公式对象导出。
图表变成图片后,检查边缘文字
同一图表在两份输出中使用相同 JPEG。A、B、C 三个点与坐标仍可见,但顶部的距离单位和模型说明被漏掉。正文和表格仍保留部分单位,不能只凭其中一处正确就判断图表完整。
扫描件和 Office 输入需要各自的预检
扫描或拍照材料先检查清晰度、裁边和页序,再识别文字;Office 文稿先检查转换预览的字体、公式与图表。当前公开样例是原生文字 PDF,这两类输入的示例可从下面关联页面继续查看。
接口结果与网页导出分别确认
需要程序读取坐标、类型或正文时,查看开放平台的解析结果说明。网页中的 Word、HTML 等导出选项,不能直接推定为同名 API 参数;本页下载材料只验证网页解析结果的两个输出格式。
OCR 是什么,和文档解析、格式转换有什么区别?
OCR 是 Optical Character Recognition(光学字符识别),把扫描页或照片中可见的文字识别成文本。文档解析还要组织标题、段落、公式、表格、图片及其顺序;格式转换则把核对后的内容保存为 Word、Markdown 等文件。三个环节关注的结果不同:能复制文字,不表示表格行列或阅读顺序正确;成功下载 Word,也不表示保留了原页排版。
17 类版面元素,保留文档结构
另有 attributes.is_boilerplate 标记,用于识别页眉、页脚、页码等样板文字。
相关官方说明
详细操作教程
选择上传用途与页码,开始解析后对照原文检查结果。
遇到这些情况
- 格式换了,漏掉的图表说明仍然没有
- 先回到解析内容和原页核对。两个输出可能共用同一份解析结果,换格式不会自动重新识别或修复漏行。
- Markdown 图片打不开
- 完整解压 ZIP,保留 Markdown 与 images 文件夹的相对位置;再检查编辑器对本地图片路径的支持。
- Word 页数相同,内容位置却变了
- 检查流式排版与页面尺寸。本例虽仍为两页,A4 已变成 Letter,第 4 节标题也前移。
- Office 预览已经缺字或错位
- 先处理源文件字体、图表或转换预览问题,确认中间 PDF 正常后再继续解析。
常见问题
OCR 是什么意思,和图片转 Word 一样吗?
OCR 是光学字符识别,把图像中的文字变成待核对的文本;图片转 Word 还需要组织内容并生成 DOCX。文字识别、公式与表格结构、Word 版式和实际可编辑性应分别检查。
文档解析和 OCR 有什么关系?
OCR 是文字识别环节;文档解析还组织标题、正文、公式、表格和图片等内容。扫描件需要识别图像文字,原生 PDF 也可能需要整理阅读顺序与内容归属。本页样例是原生文字 PDF,不是扫描或手写准确率测试。
电子 PDF 已经能复制文字,为什么还要解析?
能选中文字,不保证复制顺序、标题层级、公式表达和表格行列符合后续用途。本页原生文字 PDF 导出后,标题成为二级标题、Word 重新分页,两种输出还保留同一处图表说明缺漏。是否解析应按需要整理的内容和目标格式决定。
PDF 解析后可以下载什么?
按当前任务的导出选项选择。本页提供同一原稿的实际 Markdown 图片包和流式 Word;全部导出格式页说明其他格式及条件。
解析后能保留原 PDF 排版吗?
内容结构与原页位置分别处理。本例普通 Word 使用流式排版;需要保留 PDF 版式的 Word,应另查任务版本、格式选项和适用条件。
Word、PPT 能直接开始解析吗?
支持的 DOCX、PPTX 会先转换成 PDF 供预览,再确认继续解析。旧 DOC、PPT 等文件先另存为支持的格式,按当前入口提示处理。
同一文档导出多个格式就能补回漏字吗?
不能据此保证。本例 Markdown 和 Word 的图表缺少同一行说明,需回到原页核对解析内容。
内容核对:2026-10-16 · 功能条件与配额以当前产品界面为准