
本页内容
先对照原图确认自然段,再局部合并边界
- 上传清晰、完整的图片,在图片识别选项选择直接解析原图。对照原图查看标题、正文、列表和公式分别形成哪些内容块。
- 保存原始结果。本例从同一版本分别下载Markdown ZIP和普通流式Word,先看正文是否已经被分成独立段落。
- 在自己的副本里选出确认属于同一自然段的正文,仅合并这些段落之间的边界。本例只合并第一组三段,不改变其他内容。
- 保留标题、段落之间、列表条目和公式所需的分隔。中文标点与英文空格分别检查,不把整份文本拼成一行。
- 重新打开整理副本,检查正文、编号、公式与页脚。段落整理不等于修正错字、生成自动列表或转换公式对象。
本页原始文件来自一次真实识别;整理副本在本地制作,没有修改云端版本或再次识别。
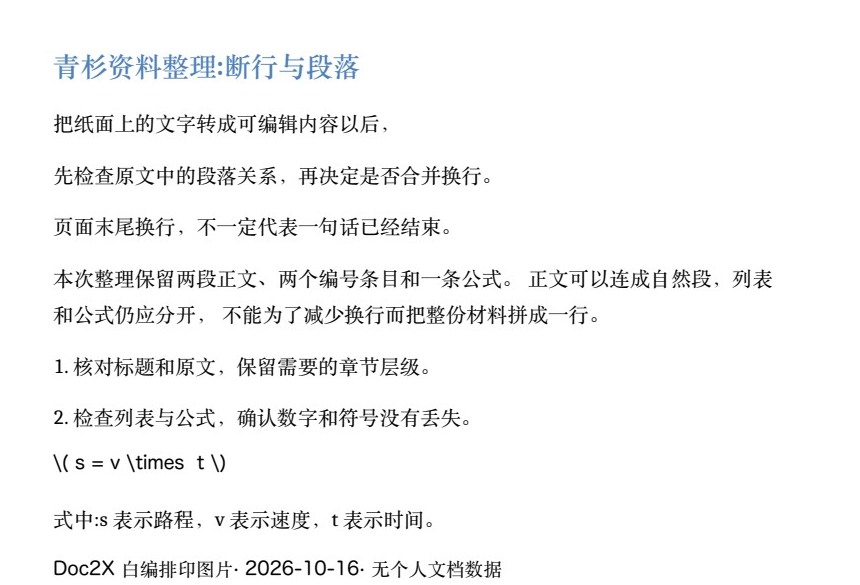
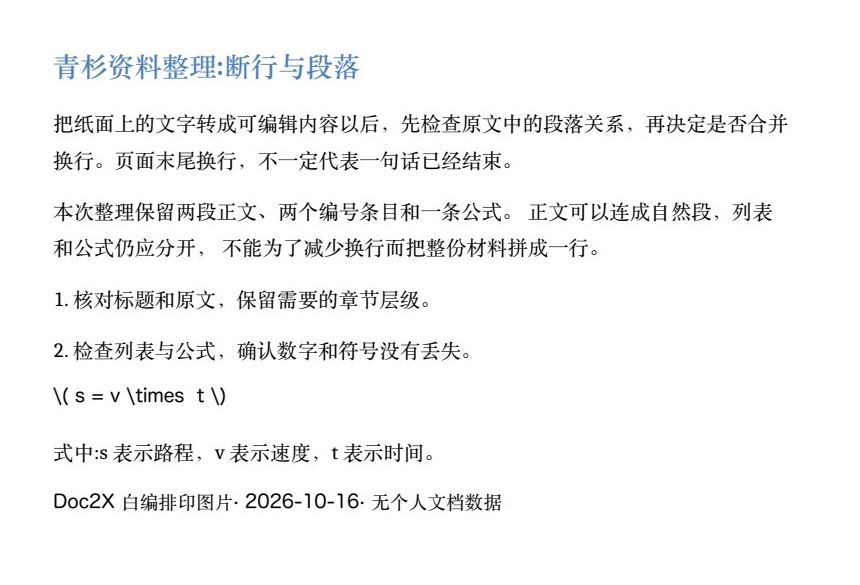
同一份原始Word:只合并前三个正文段落
2026年10月16日,实际上传一张自编中文排印图,以doc2x完成一次识别,保留版本0,再下载Markdown和普通流式Word。下面两张图分别来自原始Word与本地整理副本的LibreOffice预览,未在Microsoft Word或WPS内执行编辑。
| 检查项目 | 原始下载 | 本地整理副本 |
|---|---|---|
| 全部正文段落 | 10个 | 8个 |
| 第一组正文 | 3个独立段落 | 1个自然段 |
| 第二组正文 | 已经是1个段落 | 保持不变 |
| 手动换行 | 0个显式w:br | 仍为0 |
| 全部文字顺序 | 原始识别内容 | 字符顺序完全相同 |
| 列表与公式 | 编号是文字,公式是源码 | 保持原样,未转换对象 |
- 同样是原图里的三条视觉行,第一组识别成三段,第二组识别成一段。不能根据屏幕上有几行推断文档里有几个段落。
- 本地整理只合并第一组的两处段落边界;原DOCX里其他文件成员逐字节保持,全部文字没有改字或重排。
- 整理后一个自然段仍会随页面宽度自动折成多行。看到多行不等于仍有多余段落,需把视觉和文件结构分开检查。
- 两条1./2.编号在本次Word里是普通文字;公式是反斜杠源码,Office Math对象为0。它们与断行是不同问题,本页未顺手修复。
输入是清晰、自编的排印图片,不是手机照片、手写或复杂扫描准确率测试。原始下载未改写,云端保持版本0。两张预览由本地LibreOffice和PDFium生成,转换进程使用现有系统中文字体;不代表其他软件的显示或编辑验收。
先了解这几件事
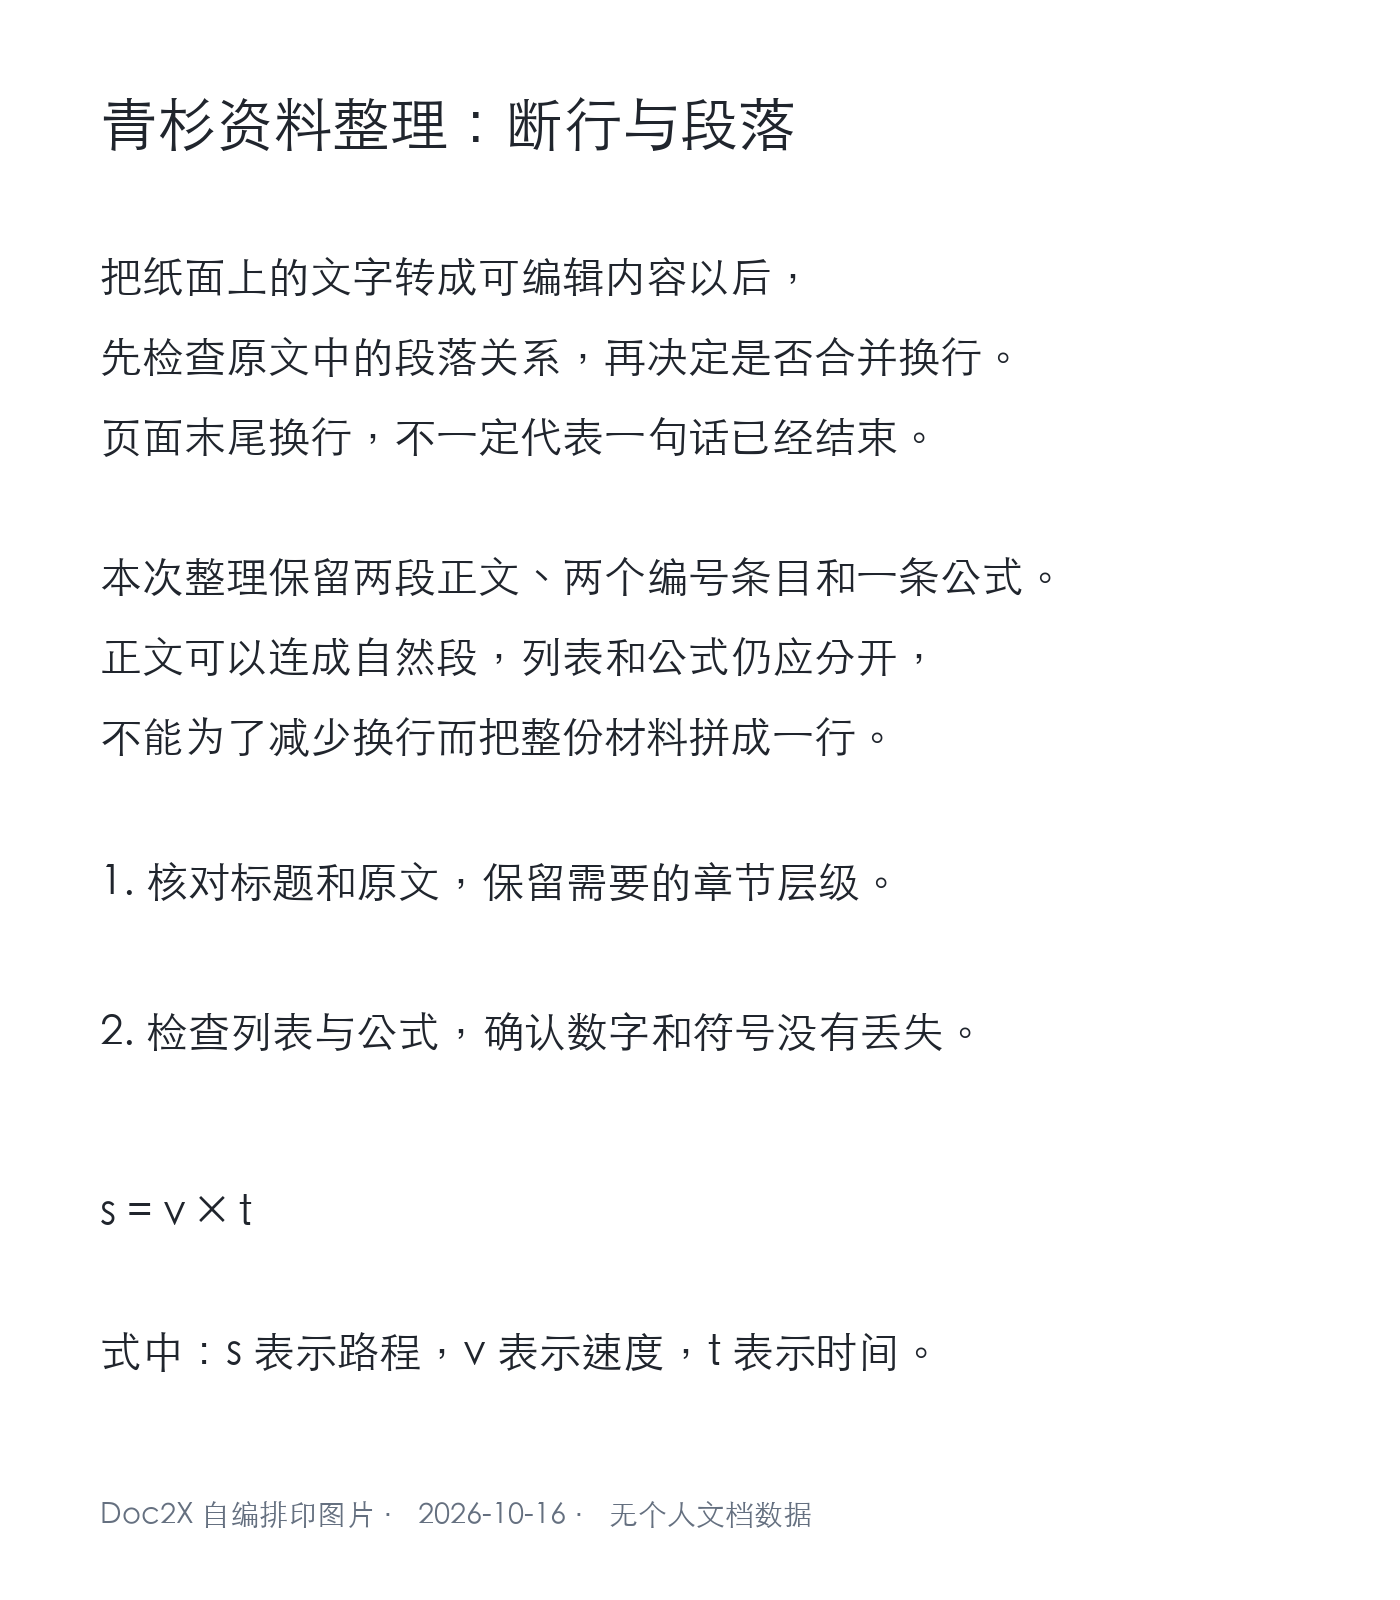
图片转Word后换行太多,先判断屏幕自动折行、手动换行和段落分隔。本例原图两段正文各有三条视觉行,识别后第一组是三个独立段落、第二组已合为一段;原Word的手动换行数为0。整理副本只把确认属于同一自然段的前三段合一,其他内容原样保留。不要对整份材料删除所有换行,标题、列表和公式仍需独立核对。
- 本例原图
- 1400×1600清晰排印图,两段正文、两个编号条目和一条公式。
- 实际Word
- 10个正文段落,第一组正文分成3段;没有显式手动换行。
- 局部整理
- 只把前三个正文段落合成1段,全部文字顺序保持,10段变8段。
- 分别检查
- 本次公式在Word中是源码文字,编号也不是自动列表;整理断行未改变它们。
回到识别结果:视觉行与内容块并不一一对应
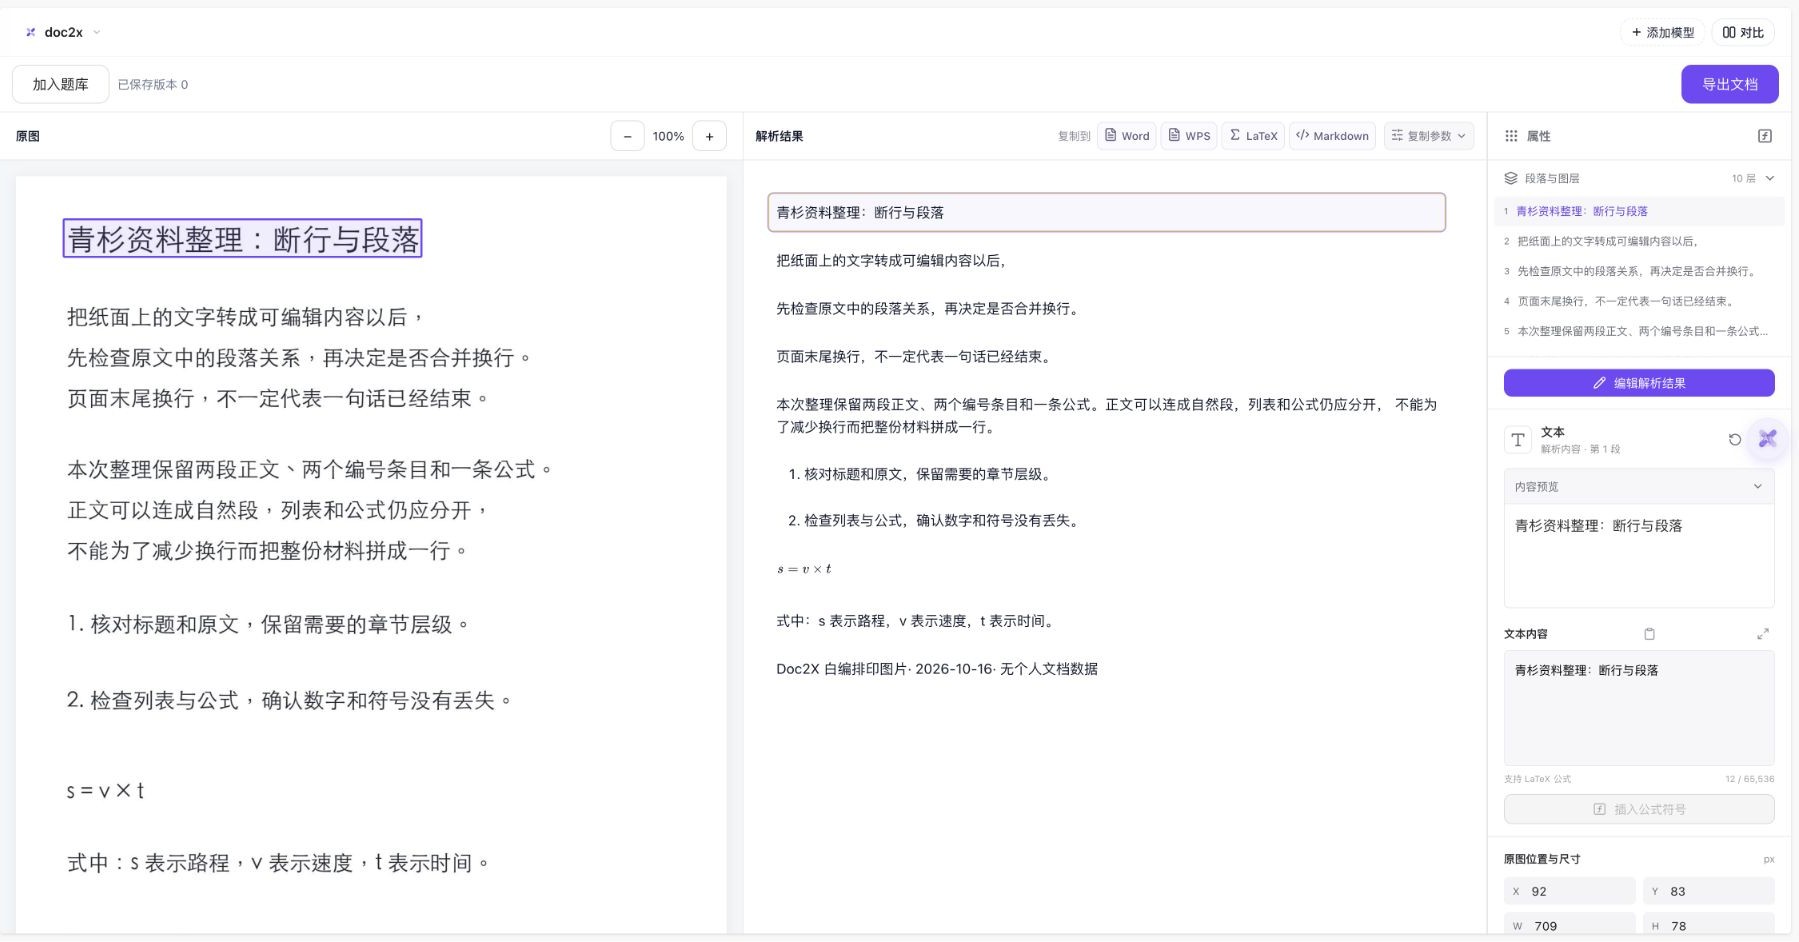
原图的第一组正文三行之间没有空白段落;实际结果却形成三个内容块。第二组同样三行,结果已合为一块。先对照原图中的语义、缩进和间距,再决定需要合并的位置。
 查看原图 ↗
- 没有对识别结果重新排版或修订。原始文件保留这次结构判断,作为整理前的对照。
- 页脚的“自编”被识别成“白编”。本地副本只处理段落边界,仍保留该错字;识别文字与段落结构分别校对。
- 本次Markdown导出把公式放在代码围栏中。原Word也保留源码文字,不能用工作台里公式能显示来推断导出对象。
截图直接裁切本次工作台画面,不是重绘UI。清晰样例的单次结果不能代表其他输入的准确率。
Markdown原文:只处理确认属于正文的空行
本例原始导出的前三个正文段落
把纸面上的文字转成可编辑内容以后,

先检查原文中的段落关系,再决定是否合并换行。

页面末尾换行,不一定代表一句话已经结束。
空行在这份原始MD中分隔段落;它不是一个自然段内部的普通屏幕折行。
本地整理后,只合并这一组正文
把纸面上的文字转成可编辑内容以后,先检查原文中的段落关系,再决定是否合并换行。页面末尾换行,不一定代表一句话已经结束。其他段落、列表、公式代码围栏和页脚原样保留。显示时仍会按窗口宽度自动折行。
先判断是哪一种换行,再选择处理范围
| 看到的现象 | 怎样判断 | 处理起点 |
|---|---|---|
| 窗口变窄,正文显示行数变多 | 可能只是同一段的自动折行 | 先看文档结构,不为屏幕换行删字符 |
| 每个原图行都成为独立段落 | 本例第一组在Word里是三个w:p | 只合并确认属于同一自然段的选区 |
| 段内有显式手动换行 | 应与段落边界分开检查 | 本例为0,不以本例证明其他文档也没有 |
| 标题、列表或公式各占一块 | 可能是需要保留的结构 | 按用途检查,不与正文全局拼接 |
| 公式导出后显示反斜杠代码 | 先检查输出格式与对象 | 另看公式导出选择与源码格式指南 |
图片转Word换行太多,先看独立段落
本例原图第一自然段画成三行,但三行属于同一段话。原Word把它们保存为三个段落,而不是用段内手动换行隔开。整理副本只把这三段合为一段,后面第二自然段和两条编号仍分开。自己的材料应结合上下文、标题、缩进和版面判断,不根据一处句号就批量合并全文。
自然段可以显示为多行
一个段落会随页面宽度、字号和边距自动折行。本地整理后的第一组正文仍可能显示两行或三行,但内部只剩一个段落。这种显示变化与是否存在多余回车、是否需要更改文字是不同的判断。
为什么不直接删除所有空行
原始Markdown的空行还用于分隔标题、正文、编号条目和代码围栏。把它们全部删去会改变这些部分之间的关系。本页只选择一组明确连续的正文,不把局部修改方法包装成适用于全部文档的自动清理。
段落整理以后,公式和错字仍要核对
本次Word里没有Office Math对象,公式仍为源码文字;编号也没有自动列表属性。页脚另有“自编”识别成“白编”的错字。局部合并段落没有解决这些问题,下载后按内容和目标输出分别处理。
常见问题
OCR后每行都变成一段,应该重新识别吗?
先看现有结果的内容是否完整、问题是否集中在段落边界。本例没有再次识别,而是在本地副本只合并确认属于同一自然段的三段;其他内容仍需核对。不能据此保证所有错段都可同样处理。
屏幕上的一行就是Word的一个段落吗?
不一定。自然段可以自动折成多行。本例用Word内部结构区分:第一组三个段落,第二组一个段落;局部整理后两组各一个段落。
删除手动换行就能解决所有OCR断行吗?
不能这样判断。本例原Word显式手动换行为0,多余分隔来自独立段落。先分清手动换行、段落边界和显示折行,再决定操作范围。
可以把整份Markdown的换行全部删掉吗?
不宜按本例这样推断。标题、列表、代码和公式需要各自的分隔;本地副本只修改第一组正文,保留其余结构。
局部整理副本是Doc2X自动修复的吗?
不是。原图、原始Markdown与Word来自实际产品操作;reviewed文件是本地明确选择正文后制作的整理示例,云端识别版本保持0。
内容核对:2026-10-16 · 功能条件与配额以当前产品界面为准