
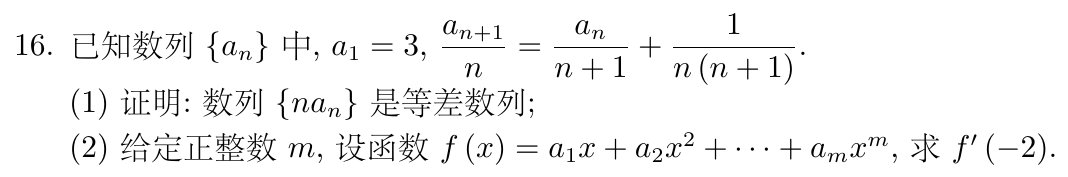
本页内容
一页定位问题,再处理其余内容
- 放大原图,检查文字本身是否清楚、方向正确、边缘完整。
- 对照同一区域的识别内容,记录具体字符或顺序差异。
- 分别检查网页结果、复制内容与下载文件,确定从哪一步开始变化。
- 先修正或重试一页,确认效果后再应用到其余内容,并保留原稿。
上传一页,定位识别问题
原图模糊、识别错字、编码与目标软件支持是不同问题,不要盲目重复整份任务。
先了解这几件事
先看原图,再看识别页面,最后检查复制和导出文件。原图已经模糊时应换清晰来源;识别页面就有错字时先校对;只在目标软件里乱码时检查字体、编码或数学格式。重复处理整份文件前,先用一页确定问题发生在哪一层。
- 相似字符
- 核对 0/O、1/l、负号、小数点与上下标。
- 版面顺序
- 多栏、页眉、脚注与图注可能影响连续阅读。
- 复制问题
- 富文本、纯文本与公式源码需要目标软件支持。
- 导出问题
- 在实际使用的软件检查字体、编码、图片与格式。
乱码、错字和漏字不是同一个问题
乱码可能来自编码或字体;错字可能是识别把相似字符混淆;漏字可能来自裁边、遮挡或内容范围选择。记录一段原文与结果,先判断现象,再选修复方式。
原图清楚,识别内容却不对
检查原页是否多栏、旋转或含复杂公式。先比较标题、普通段落与表格各一处;对公式要看字符位置和括号范围,而不只是字形。必要时在结果页按当前编辑功能校对,再导出。
网页正确,复制后出现变化
纯文本粘贴可能不携带数学对象、图片和格式;富文本剪贴板又受浏览器及目标软件支持影响。先核对复制方式和目标输入位置,再尝试文件导出。已有 LaTeX 源码时,检查是否需要数学定界。
下载文件中才出现乱码
先用适用软件打开,检查字体与编码。CSV 的字符编码与字段导入、Markdown 的图片路径与数学支持、DOCX 的公式对象是不同问题,不要用同一套替换规则处理所有格式。
用实际公式说明位置为什么重要
本页截图来自公开试卷:左侧分子的下标是 n+1,中间项下标为 n、分母为 n+1。相同字符放在不同位置会改变数学含义。相关公式页提供同源源码与复制入口,便于逐项比对。
详细操作教程
选择上传用途与页码,开始解析后对照原文检查结果。
遇到这些情况
- 只在一个软件打开时异常
- 检查该软件的字体、格式支持和导入设置,保留原始导出文件用于比较。
- 增强后识别反而少了字
- 回到未增强原图,检查清理、裁边是否影响细字和公式;不必要时跳过增强。
常见问题
换一个文件后缀可以修复乱码吗?
不能。后缀不能重建丢失的字符或改变实际编码和对象结构,应定位产生差异的阶段。
OCR 成功状态是否说明内容完全正确?
不是。成功表示任务完成,关键文字、数字、公式和表格仍需对照原稿核验。
内容核对:2026-10-09 · 功能条件与配额以当前产品界面为准