
本页内容
选定资料,再让每个结论回到出处
- 上传相关 PDF 并完成解析,或从已有记录中选取资料;核对文件名、版本和内容。
- 完成模型配置,围绕相同指标提问,要求注明每份资料的出处与缺失内容。
- 点击答案引用,检查对应文件、原页、单位和限定条件;计算结果单独核对算式。
- 在同一对话继续追问依据,分清原文明确陈述与后续推算,不补写资料缺失的结论。
- 导出上下文时选择需要的轮次与格式;需要来源摘录时勾选原文依据,并打开下载文件检查。
当前帮助支持选择 1–20 份已解析文档;自己的任务需要登录。模型、会员或试用以及 AI 积分条件以工作台为准。
两份 PDF:可以比较的记录,与不能推出的结论
2026年10月12日,实际上传这两份自编 Cedar 记录并分别完成解析,选用 Qwen 3.8 Flash,在同一对话提出两问。下图直接渲染自原 PDF;回答、引用画面与四份原生下载均来自这次任务。
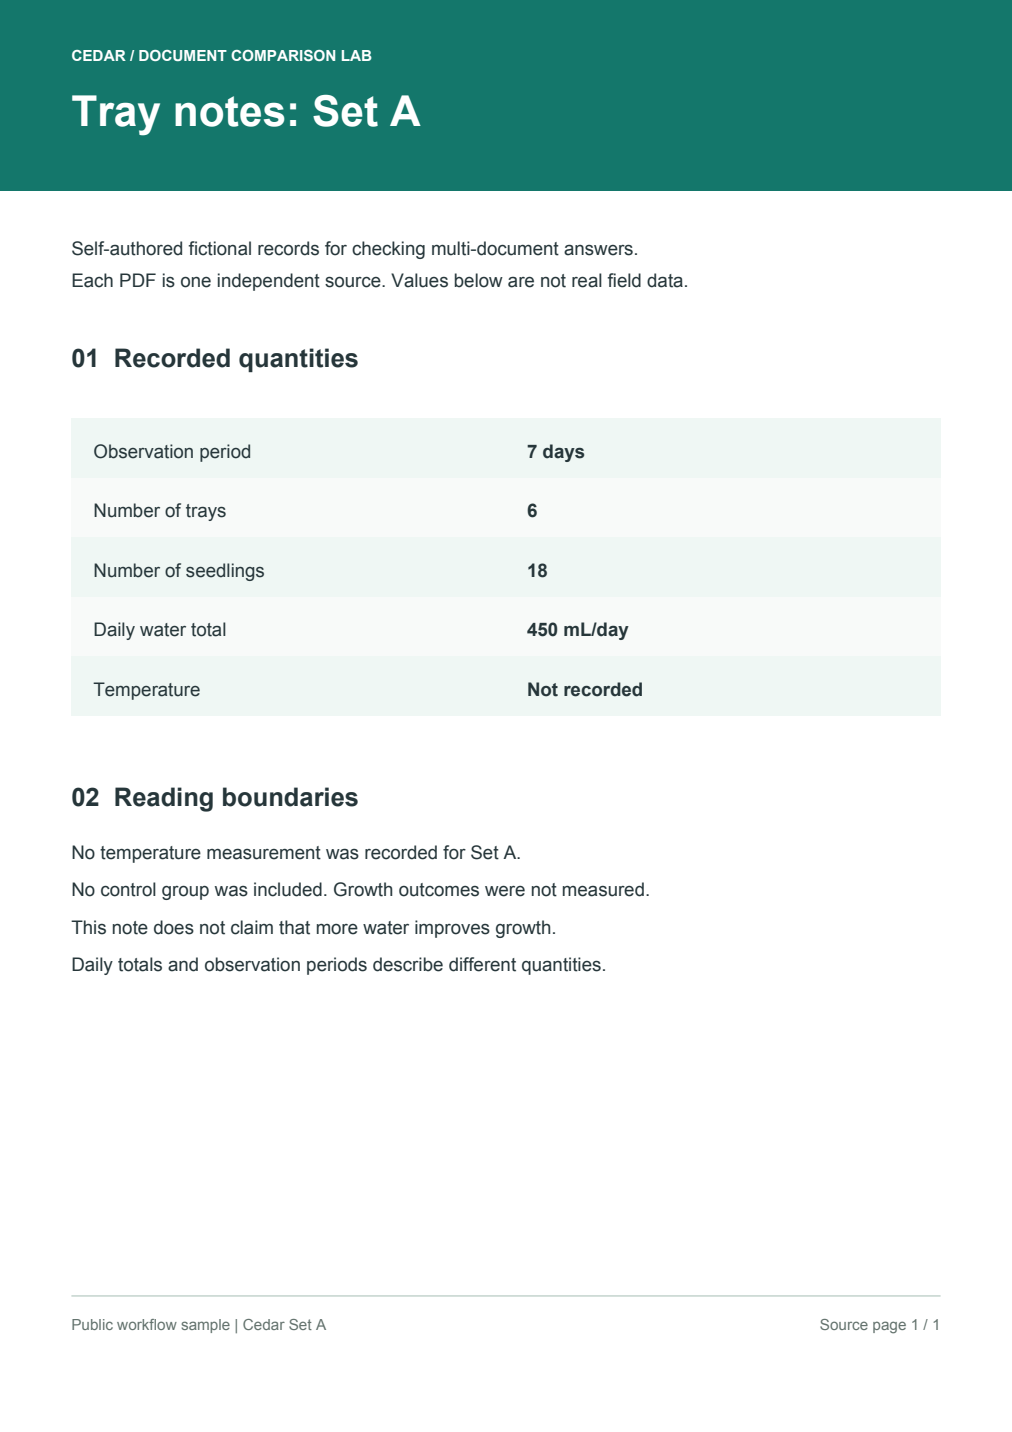
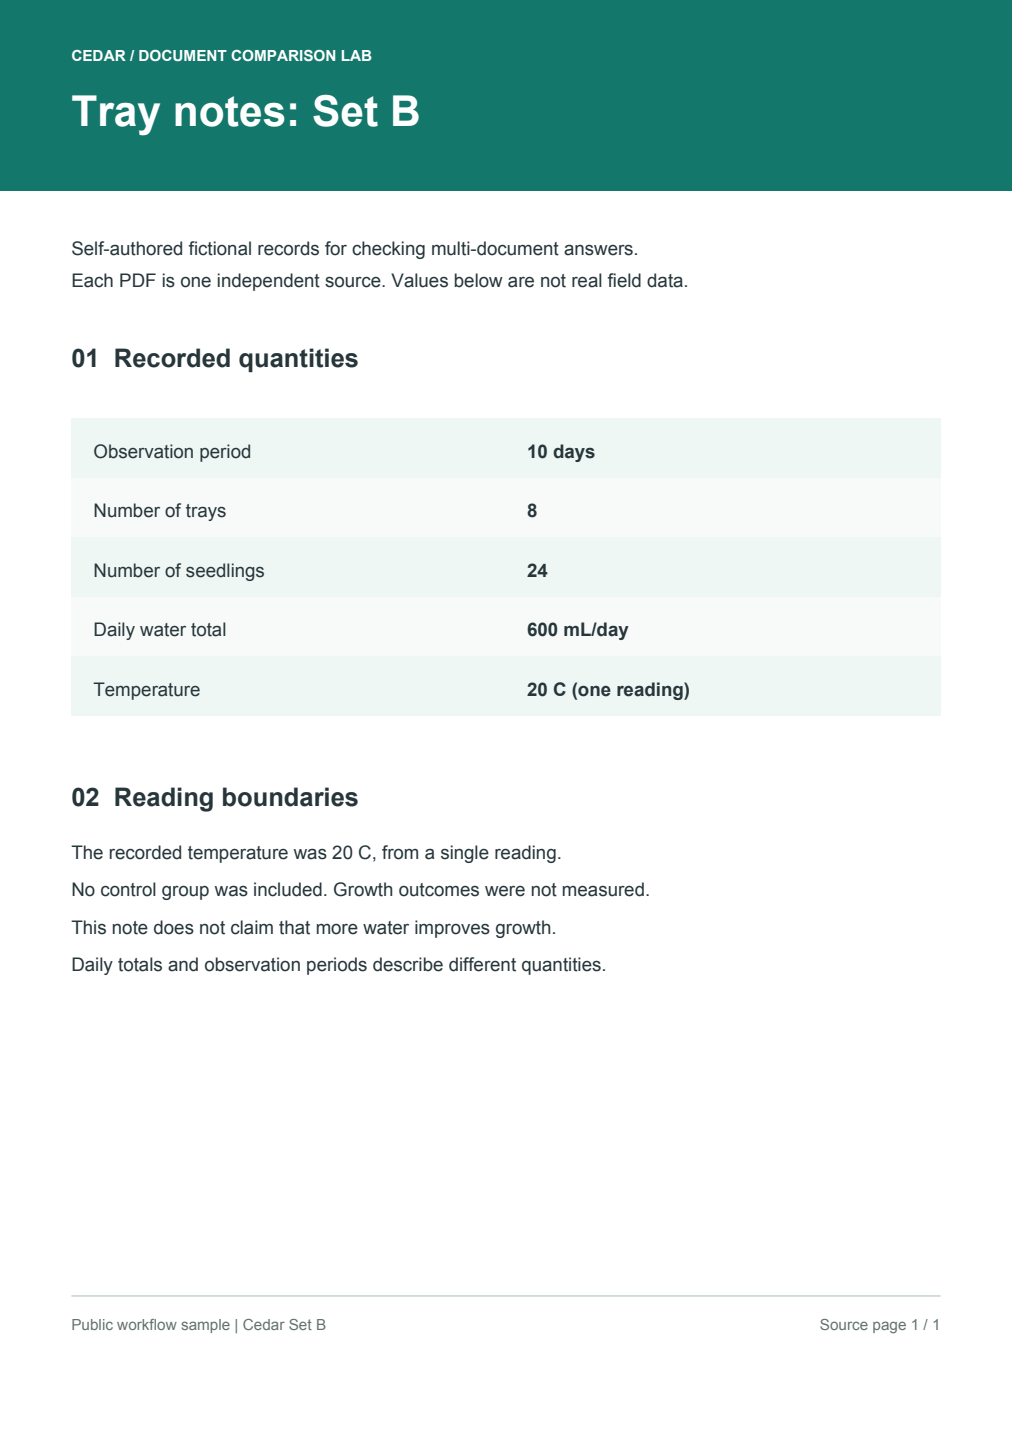
- 第一问对照表保留两份资料的五项记录,A 的温度为 Not recorded,B 为 20 C (one reading),没有把一次记录写成持续恒温。
- 450÷6 与 600÷8 都得到每托盘每日 75 mL;回答明确标为根据原文数字计算的结果。
- 两份原稿均注明没有测量生长结果、没有对照组。回答没有据每日水量较多就断言哪组生长更好。
- 追问得到的每株每日 25 mL 是总量除以株数的平均值;原稿没有写每株实际收到这些水,回答也保留这一限制。
本例使用两份自编虚构记录,只验证这次问答、引用与导出流程,不代表任意文档的回答准确率。ZIP 为本地整理的核对包,原生输出没有改写;原 PDF 需要另行保留。
先了解这几件事
多文档 AI 问答把选定的解析资料放在同一对话中,便于比较数据、整理要点和追问出处。新的文件先上传 PDF 并完成解析;回答有引用时可回到原文核对。本例比较两份一页资料,既找到各自数字,也明确区分原文数据、据此计算的平均值和资料没有证明的结论。
- 本次资料
- 两份自编 PDF,各一页;数字为虚构记录。
- 实际提问
- 同一组资料的对照问题,以及一次计算依据追问。
- 引用核对
- 点击 A、B 的引用,看到对应第 1 页及表格范围高亮。
- 实际导出
- 三份 Markdown 与一份含两轮问答的 Word。
同一组资料,三种不同的核对任务
| 要问什么 | 本例结果 | 回原文检查 |
|---|---|---|
| 两份记录有何不同 | 天数、数量、水量与温度对照 | 分别核对 A、B 的表格 |
| 平均每托盘用水多少 | 两组均为 75 mL/日 | 检查分子、分母和单位 |
| 哪组生长更好 | 资料不足,不能断定 | 是否测量结果、是否有对照 |
引用必须对应到这份资料的原页
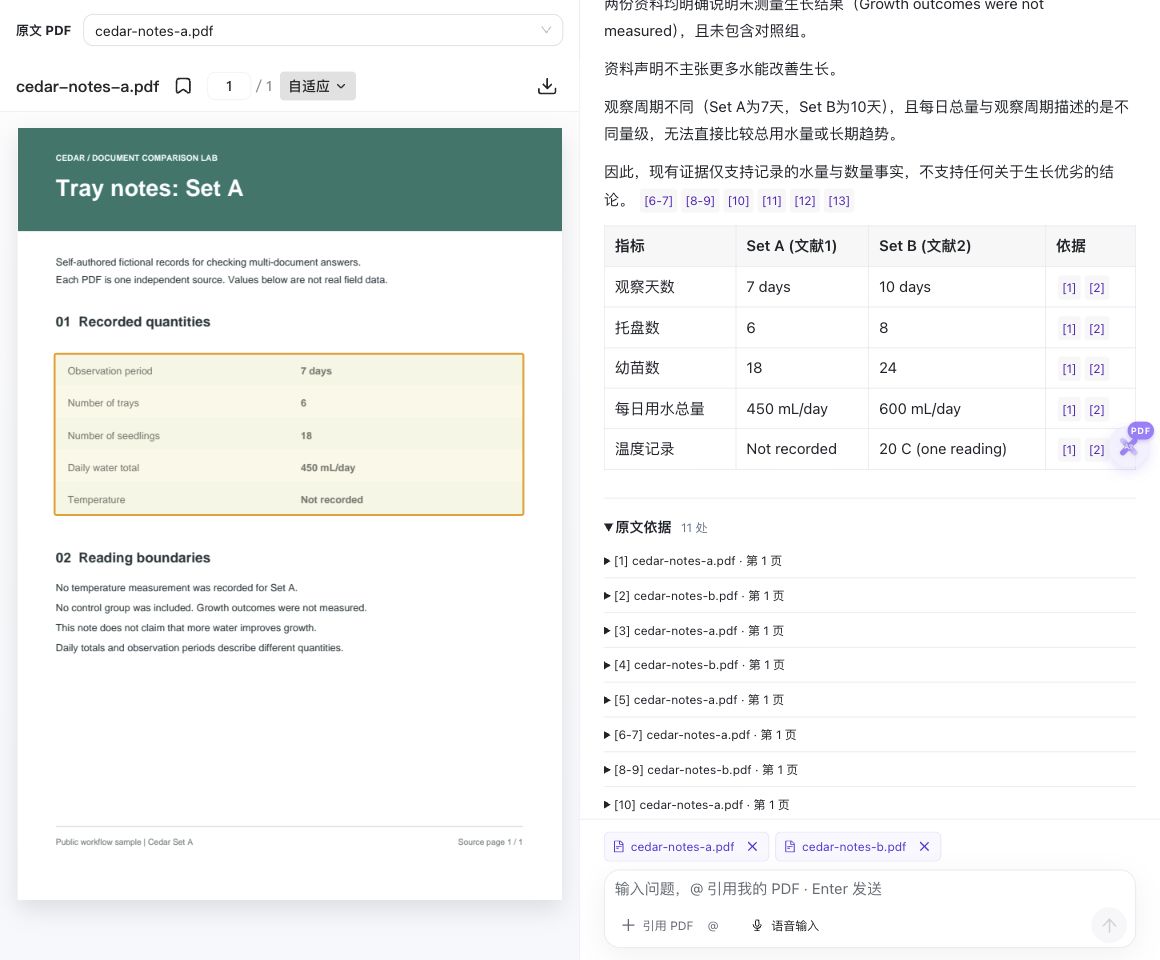
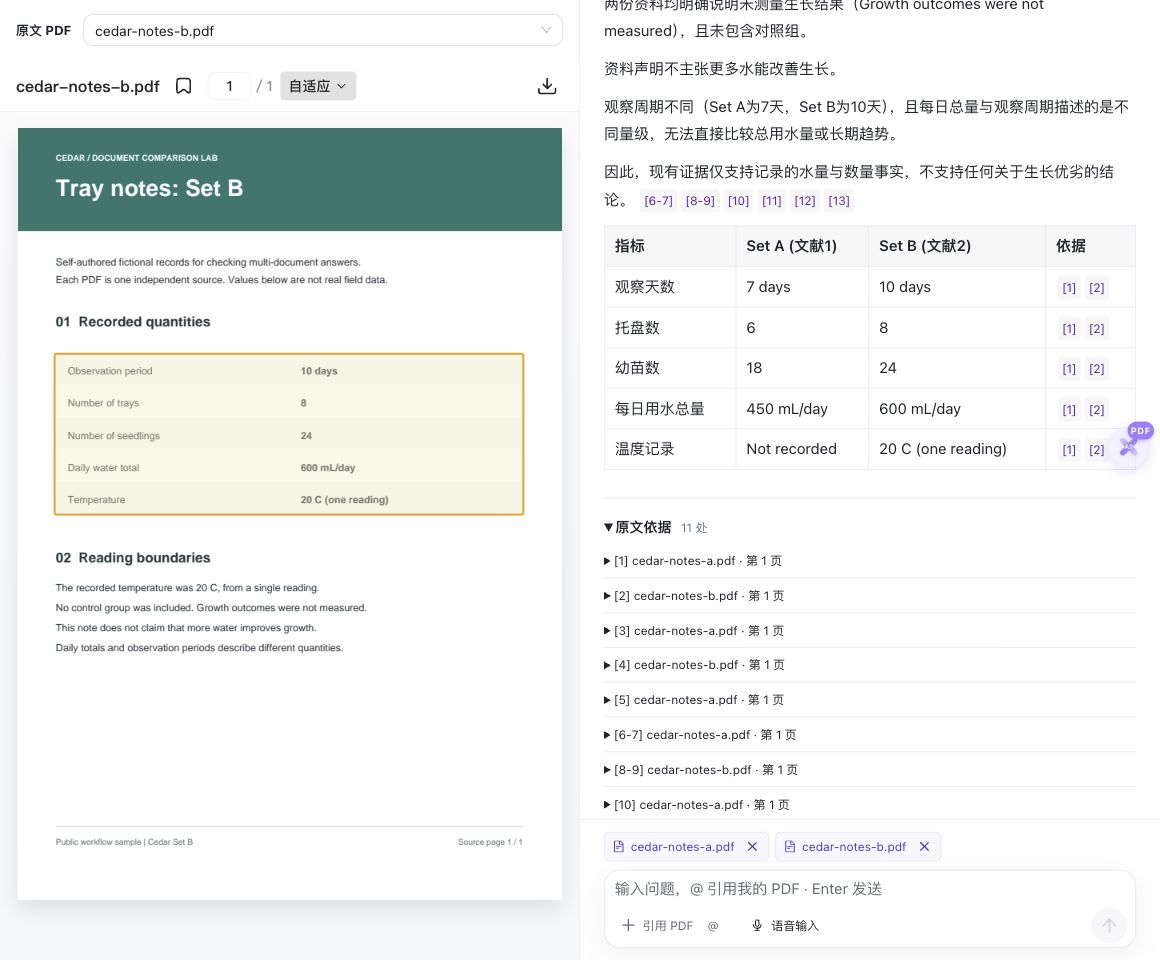
对照表中点击 B 的引用后,原文切换为 cedar-notes-b.pdf 第 1 页,表格范围高亮。每日 600 mL、24 株和一次 20 C 温度记录来自这一页;没有把 A 的缺失温度补成同样的数值。
按问题选择资料,先确认范围
本例只选 A 与 B 两份 PDF。论文、报告或项目资料可先核对题目、日期和版本,再围绕同一比较维度提问;同名指标也可能有不同定义。
新上传先用 PDF,Office 文稿先转换
当前文档问答的新上传入口接收 PDF。Word、PPT 先转换并完成解析,再从可用记录中选入;不要仅因为文件已上传就认为解析已经完成。
引用帮助找到原文,结论仍需核对
本例引用能展开原文并高亮表格范围。应继续检查数值、单位、否定词和限制条件;找到相同关键词,或看到引用编号,都不足以证明整段推论。
整理资料时,把原文与推算分别写清楚
本例每日 450 mL、18 株来自 A 的表格;每株平均 25 mL 来自除法。这个平均值不等于逐株实际分配记录,也不能推出生长效果。
把问答和来源一起保存下来
需要分享阅读笔记时,按轮次导出并勾选原文依据。本次 Word 包含问题、回答、文件名和摘录,没有嵌入两份原 PDF;需要的页码与原件另行保留。
单篇科研论文,也从具体问题与原页开始
新增一份24页开放论文的中文精读实测:第一问只部分完成,随后按Figure 3定向追问并回到第11页核对。科研阅读页提供原稿与三份原生成品,未确认项原样保留;总结不完整指南解释怎样继续核查。
相关官方说明
详细操作教程
核对文档、配置任务,再检查带原文依据的回答和整理结果。
遇到这些情况
- 找不到新上传的文件
- 确认该 PDF 已完成解析,再回到来源列表检查文件名与选择状态。
- 回答混用了版本或统计口径
- 回到来源范围,明确版本、期间、单位和需要比较的指标,再检查每条引用。
- 计算结果被当成原文结论
- 追问原文是否直接写出该值,并分别列出来源数字、算式和不能证明的含义。
常见问题
可以同时比较多份 PDF 吗?
当前帮助支持选择 1–20 份已解析文档。本页实际验证两份一页 PDF;更多、更长或不同内容的资料仍需检查各自引用。
文档问答就是企业共享知识库吗?
本页验证当前账号中的资料选择、问答与导出。没有据此承诺跨账号共享、团队权限、永久保存或企业部署能力。
可以直接上传 Word 或 PPT 提问吗?
这个新上传入口接收 PDF。Office 文档先按转换和解析流程处理,再选择对应记录。
没有温度记录,AI 会补上吗?
本例 A 的温度明确没有记录,回答保留了缺失。自己的材料也应要求缺少依据时说明,并回到原文确认。
网页版问答能直接通过解析 API 调用吗?
不能由网页版可用推定 API 已开放。需要自建 RAG 时可查看文档解析接口;完整问答接口以开放平台当前说明为准。
内容核对:2026-10-15 · 功能条件与配额以当前产品界面为准