
本页内容
先预览 Office 转换,再确认解析
- 准备 DOCX 或 PPTX;旧 DOC/PPT 先另存为新版格式或 PDF。
- 上传后等待转换,先预览并核对页面;仅需 PDF 时可下载后暂不继续。
- 确需识别时,查看当前页数与额度提示,确认开始解析。
- 解析完成后核对文字、公式与表格,再编辑、导出或选择其他后续功能。
先检查转换后的分页、字体和图表;Office 转换完成与后续解析是两个步骤。
同一份 DOCX:原文档与转换后的 PDF
2026年10月11日,上传这份自编六公式 DOCX,实际生成并下载 1 页 PDF,随后选择“暂不处理”。没有继续启动 OCR 或翻译。下面的 Word 图片是此前打开同一文件的实拍,右侧图片直接渲染自本次下载的 PDF。
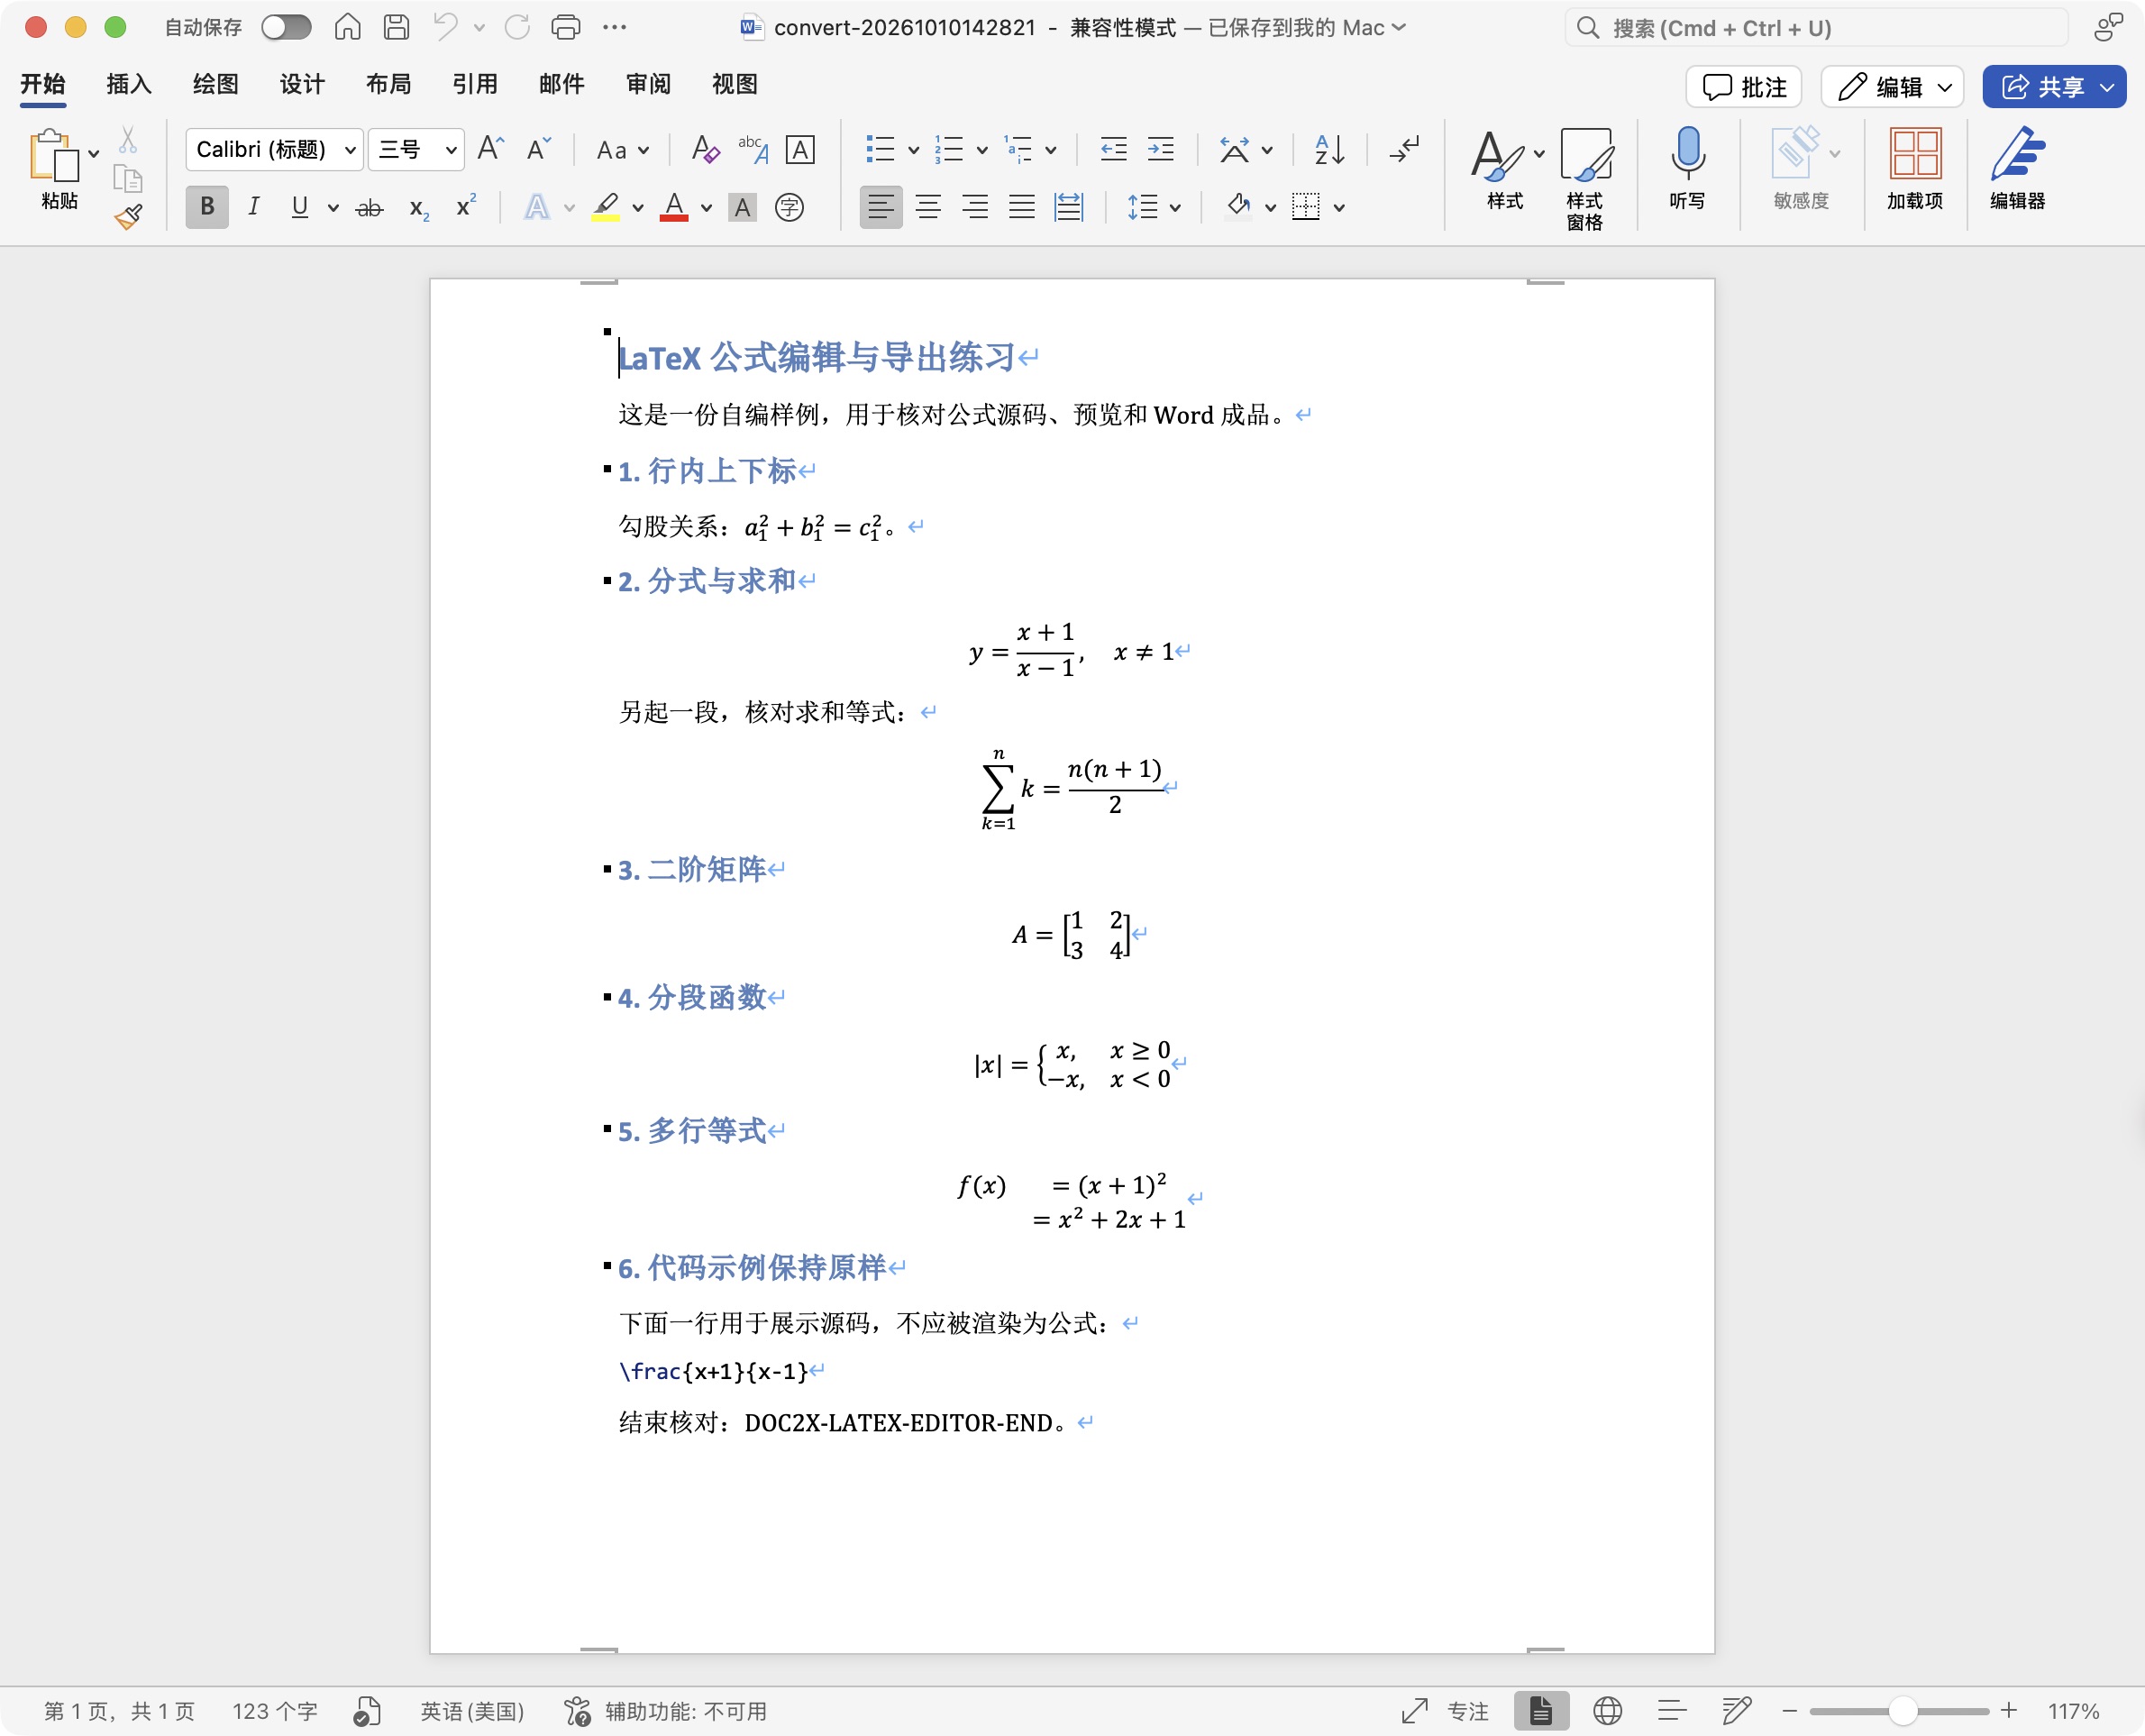
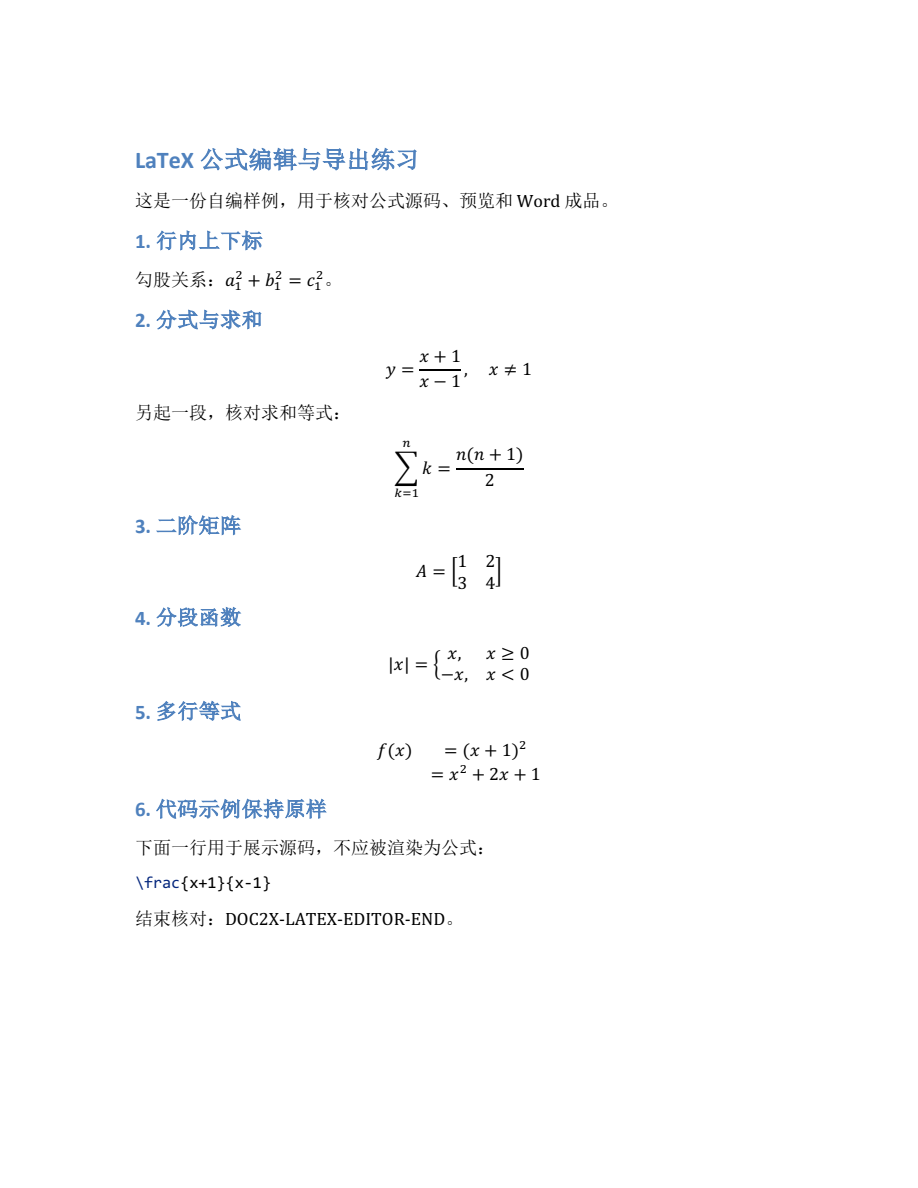
- 六条公式在 PDF 中均可见:矩阵为第一行 1、2,第二行 3、4;分段条件和两行等式完整显示。
- 中文正文、普通代码块与结尾 DOC2X-LATEX-EDITOR-END 标记可核对。原 DOCX 中有 6 个 Word 原生公式,PDF 是另一份用于阅读的文件。
- 显示正确与文本提取正确分别检查。本例的 PDF 文本层和独立提取结果存在数学符号、上下标及矩阵结构差异,不能直接作为准确公式源码。
样例不含表格、图片、修订、批注或加密内容,不能代表所有 DOCX。PDF 保留实际下载的原始字节,页面图是其本地 PDFium 渲染,非重新转换 DOCX。文本提取已核对,未测试实际剪贴板复制。核对 ZIP 为本地整理;本次未编辑原 DOCX。
先了解这几件事
Doc2X 处理 DOCX、PPTX 时,先转换为可预览和下载的 PDF,再由你确认是否开始解析。需要文字、公式和表格时继续识别;只要 PDF 时可下载后暂不继续,转换完成不等于已经提交 OCR 或翻译。
- 可用输入
- DOCX、PPTX;旧 DOC/PPT 先另存为新版格式或 PDF。
- 确认前
- 生成 PDF 后可先预览、下载,检查页面是否适合继续处理。
- 确认后
- 按所在入口启动解析或翻译,任务类型与设置应在确认时核对。
- 结果范围
- 提取页面中的文字、公式和表格,不承诺恢复原 Office 工程结构。
- 额度与接口
- 后续解析页数和翻译消耗按当前提示确认;公开 API 范围单独核实。
先分清要 PDF,还是要识别内容
只需要一份便于阅读和分享的 PDF,可在 Office 转换完成后下载并暂不继续。需要提取文字、公式、表格或进入后续文档流程时,再确认开始解析。两种任务共用前面的页面转换,但交付目标不同。
准备 DOCX 或 PPTX,检查转换后的页面
当前输入支持 DOCX 与 PPTX。旧版 DOC、PPT 请在对应办公软件中另存为新版格式或 PDF,不要只改文件后缀。转换预览中先检查字体、分页、表格和嵌入对象,再决定是否继续。
确认后才进入解析或翻译任务
在解析入口确认“开始解析”后,转换得到的 PDF 才提交后续识别;从翻译入口开始时,则按选定语言与设置确认翻译。关闭或选择“暂不处理”不会自动提交这些后续任务,但不代表已受理的 Office 转换在服务端被取消。
用识别结果继续编辑与整理
解析完成后,对照页面核对正文顺序、公式和表格,再按任务提供的方式编辑或导出。该流程围绕转换后的文档页面提取内容,不保证保留原 Office 文件的批注、修订记录或全部嵌入对象结构。
分别检查转换与识别阶段
PDF 转换成功与内容识别成功是两个阶段。若页面已经正确生成,后续识别出现问题时先检查对应解析任务;若转换页本身错位或缺内容,应先处理源文稿,必要时在原办公软件中另存为 PDF 后继续。
用同一份六公式 DOCX 分别核对两种结果
本页样例展示原 DOCX 与实际转换的单页 PDF。六条公式可见,PDF 文本提取仍有字符与结构差异。此轮只验证转换、下载和暂不处理;需要解析时,应另行核对 OCR 的正文与公式结果。
从Word原稿开始校对,先确认转换与解析
Word校对指南提供一份自编DOCX、实际转换PDF与修订Word。先预览转换稿并解析,再从当前结果进入AI校对;两处文字修订在实际Word中可核对,原稿保留,输出不等于Word审阅红线或全部原样式。
Word 表格要继续计算,先核对 Excel 类型
新增Word表格转Excel实测:同一DOCX先前转换PDF,本轮只解析PDF一次,下载原始与保存修正后的两份XLSX。编号0018保留,数量为数值,百分比仍是文本;横杠误识别为1的差异也保留在原始下载中,详见相关指南。
课件要转成Word讲义,先选编辑结构
新增PPT转Word实测提供同一三页课件的两份原始DOCX:流式有原生表格,保留版式是定位文本框,Word实际显示两页与三页。图表可见但没有原生数据工作簿,详见相关指南中的文件和实际Word截图。
相关官方说明
详细操作教程
从解析或翻译入口上传 DOCX/PPTX,检查转换后再提交任务。
遇到这些情况
- 文件提示加密、损坏或格式不匹配
- 先在原办公软件中确认文件可以正常打开,检查是否为真实 DOCX/PPTX;必要时另存可用新版文件或 PDF 后重试。
- 转换后的页面缺字、错位或嵌入对象异常
- 先对照源文件检查代表性页面。若页面转换未满足需要,可在原办公软件中另存为 PDF,再进入解析流程。
- PDF 已生成,但后续没有解析结果
- 确认是否确实点击开始解析,以及对应任务的额度和状态。仅下载 PDF 或关闭预览不会自动发起识别,不必把两个阶段混为一次成功或失败。
常见问题
为什么 DOC 或 PPT 不能直接上传处理?
当前直接输入支持 DOCX 与 PPTX。请用相应办公软件将旧文件另存为新版格式或 PDF,打开检查内容后再上传;仅改后缀不等于格式转换。
上传 Office 后会自动开始 OCR 和翻译吗?
Office 转换先生成 PDF 供预览和下载。后续解析或翻译需要相应确认;关闭或暂不处理不会自动提交后续任务,但已受理的转换可能仍在服务端继续。
解析后还是原来的 Word 或 PowerPoint 编辑结构吗?
不作这种保证。解析基于转换后的 PDF 页面提取内容,批注、修订、动画或嵌入对象不等于会按原 Office 结构保留。需要继续维护原工程时,请保留原稿。
需要自动解析 Office 文件,在哪里查看接口?
到开放平台核对实际开放的输入格式、解析接口与计费,再按需要接入自己的系统。网页和 API 的支持范围分别确认。
内容核对:2026-10-17 · 功能条件与配额以当前产品界面为准