
本页内容
先确认来源,再识别、核对与导出
- 保留原 DOCX。进入工作台选择 DOCX 时,先检查 Office 转换 PDF 的预览;本例沿用10月16日实际下载的转换 PDF,未重复上传 DOCX。
- 解析含表格的 PDF,并对照原页核对表头、行列、编号、数量与末行。本例范围1~2,两页中只识别出一张表。
- 打开导出文档,点击“表格 Excel”。该选项立即生成全部识别表格的 XLSX,每张表一个工作表,不是再次点击 Word 的开始导出。
- 发现错误时进入编辑解析结果。本例只把第4行第3列的1改回横杠,保存并返回后重新导出;原始下载另外保留。
- 核对实际 XLSX 的值与类型,再在目标软件检查计算。编号要保留前导零,百分比文本和数值百分比不能混用。
原生表格复制可先在目标办公软件尝试。本页实测的是经 PDF 的表格识别链路,没有宣称任意 Word 原生对象可直接转成 Excel。
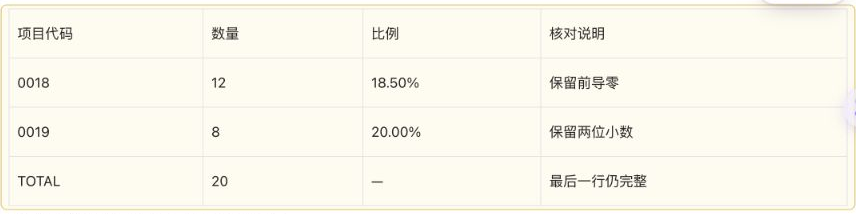
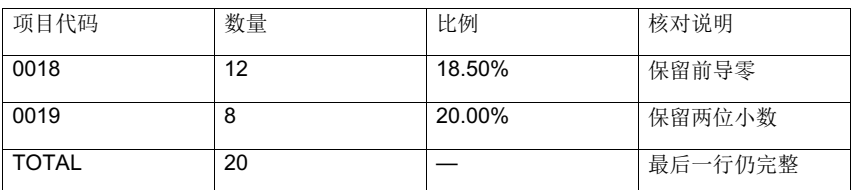
同一张 Word 表格:原 PDF 与保存修正后的结果
DOCX与实际Office PDF来自2026-10-16的自编样例;2026-10-17只上传这份两页PDF一次,分别下载未修正与保存修正后的Excel。图片展示原PDF表格局部和真实工作台修正后的表格;未修正文件中的C4数值1保留在原始XLSX中供核对。
| 位置 | 原稿 | 原始 XLSX | 保存修正后的 XLSX |
|---|---|---|---|
| A2/A3 编号 | 0018/0019 | 文本0018/0019 | 文本0018/0019,未改 |
| B2/B3/B4 数量 | 12/8/20 | 数值12/8/20 | 数值12/8/20,未改 |
| C2/C3 比例 | 18.50%/20.00% | 文本,不是0.185/0.2 | 仍为原文本,未自动转数值 |
| C4 末行比例 | — | 数值1,识别有误 | 文本—,在产品中修正后保存 |
- 两份Excel均只有一个工作表“第1页 表1”,16个单元格。第二页正文和分式没有变成另一个工作表。
- 解包核对两份真实XLSX,只有C4的值与类型改变,其余15格一致;下载文件没有在本地重存。
- 编号为文本,数量为数值,百分比为文本。B4的20是固定数值,文件没有Excel公式。
- 原生Word表格可先尝试复制;本例没有桌面Word→Excel复制实测,也没有复杂合并或跨页表格验证。
原PDF图是本地PDFium渲染裁切;结果图是真实工作台表格截图裁切,没有补字或增强,选择高亮来自界面。两者缩放、字体不同,不用于逐像素重合比较。本机未安装Excel,文件值和类型以公开XLSX结构核验,不声称完成桌面Excel计算或兼容性实测。
先了解这几件事
Word 里的原生表格可先尝试复制到 Excel 并核对格式;需要识别页面表格时,DOCX 先转 PDF,确认后解析并导出“表格 Excel”。本例沿用已转换的两页 PDF,首次把横杠识别成1;编辑保存后重新导出,编号前导零保留,百分比仍是文本。XLSX只包含识别出的表格,不包含整篇Word正文和公式版式。
- 本例来源
- 自编两页 DOCX;先前实际 Office 转换得到两页 PDF,本轮只上传该 PDF 一次。
- 实际成品
- 一个工作表、4行4列;原始与修正后 XLSX 分别为2,922和2,926字节。
- 识别差异
- 原稿末行横杠被识别为数值1,保存修正后再下载,只有C4改变。
- 类型核对
- 数量列为数值;0018、0019和18.50%、20.00%为文本。
先判断 Word 里的“表格”是什么
| 来源 | 可先尝试 | 继续核对 |
|---|---|---|
| 可逐格编辑的原生Word表格 | 在目标软件复制表格,检查粘贴结果 | 行列、编号前导零、数字与合并区域 |
| Word内的表格截图或需识别的页面 | 转PDF或保留清晰原图,再识别表格 | 识别错字、横杠、百分比和最后一行 |
| 需要整篇Word排版、正文和公式 | 继续使用Word/PDF等合适格式 | XLSX表格提取不会重建完整文稿 |
| 需要原来的公式或自动汇总逻辑 | 按业务规则在Excel中核对并建立计算 | 本例TOTAL为固定20,没有自动生成公式 |
Word 转 Excel,不一定都要做识别
原生Word表格可以逐格编辑时,可先尝试复制到Excel并核对粘贴类型。页面截图、复杂布局或需要识别的表格可以使用本页流程;没有必要为了一个原本可直接复制的表格额外创建识别任务。
DOCX 转 XLSX:本例经过了 PDF 中间文件
Word先转换为PDF供预览,之后解析页面并导出识别表格。原稿含两页正文、一张表和一个分式,实际XLSX只包含第一页的4×4表格。这是数据提取,不是将原Word对象、字体、分页和公式模板逐项搬到Excel。
Word 表格转 Excel 保留前导零,先确认编号是文本
本例A2、A3实际为文本0018、0019,前导零没有丢失。编号和数量用途不同,不能把整列都转成数值;后续复制、CSV导入或格式设置也可能再次改变编号,最终交付文件仍需核对。
Word 转 Excel 后百分比不能计算,先检查类型
C2、C3看起来是18.50%和20.00%,文件中却是文本。若业务需要计算,应先确认它们确实表示比例,再在副本中转换并检查预期0.185、0.2;不要只改显示格式就当作类型已变。本例没有在桌面Excel执行计算。
识别成功后,横杠也要和原稿逐格比较
原PDF末行比例为横杠,首次识别成数字1,实际Excel也下载了这个错误。我们在产品编辑器只改回这一格,保存后重新导出,原文件仍保留。下载成功、行列完整不代表每个值都正确。
Word 表格里的公式不会凭外观自动变为 Excel 公式
源表TOTAL行的20是固定文字,XLSX中为固定数值20,没有公式。第二页分式也没有成为表格单元格。需要自动汇总或其他计算时,应按原业务规则在目标软件另行建立并验算。
相关官方说明
遇到这些情况
- Word转Excel后只有一张表,没有正文
- 本例导出识别出的表格,每张表一个工作表;不承诺完整文稿的排版转换。
- 百分比显示正常却不能直接参与计算
- 核对单元格类型。本例18.50%和20.00%仍是文本,不能仅凭外观判断。
- 末行横杠变成数字
- 与原PDF逐格比较,在编辑器修正并保存后重新导出,保留未修正原件作对照。
- 修改了页面,却又用了旧Excel
- 已经下载的文件不会随页面编辑更新;确认保存完成,再重新导出并辨认版本。
常见问题
Word 表格怎么转 Excel?
原生表格可先尝试复制到Excel;需要识别时,DOCX先转换PDF并预览,再解析、核对表格,点击导出文档→表格Excel。本例提供原稿和两份真实XLSX。
DOCX转XLSX能保证整篇格式不变吗?
本页不作这个保证。两页Word只得到一个4×4工作表,正文和分式没有变成完整Excel版面。
Word表格转Excel会丢掉0018的零吗?
本例实际XLSX以文本保留0018和0019。其他来源、复制或CSV导入仍需核对,不能把编号盲目转成数值。
百分比为什么还是文本?
识别出的18.50%和20.00%在本例导出为文本。数量列则是数值;应按字段用途分别检查,不把表格导出当作自动业务类型推断。
修正后需要重新识别整个Word吗?
本例没有。只在编辑解析结果中把一格1改回横杠,保存并返回后重新导出。已经下载的原始Excel不会自动更新。
旧DOC和复杂合并表格也都验证了吗?
没有。本例是自编DOCX的一张简单表格;旧DOC可先另存DOCX或PDF,复杂合并、跨页和截图清晰度应单独验证。
内容核对:2026-10-17 · 功能条件与配额以当前产品界面为准