
本页内容
先确认来源,再组织切片
- 先上传一份代表性 PDF,或打开本页公开样例;比较解析正文与原页。
- 保存原件、实际结果和需要的图片,记录文件版本或哈希。
- 按内容边界选择片段,表格连同表头、单位、图注和必要正文保留。
- 把页码与来源位置写入自己的清单;本例可运行附带脚本检查两段记录。
- 接入自己的索引和检索后,用实际问题检查结果及原文依据,再扩大处理范围。
本例公开网页 JSON 不含 API 布局块;真实接口集成按实际模型与返回结构编写适配。
同一份两页 PDF,分别核对两段来源
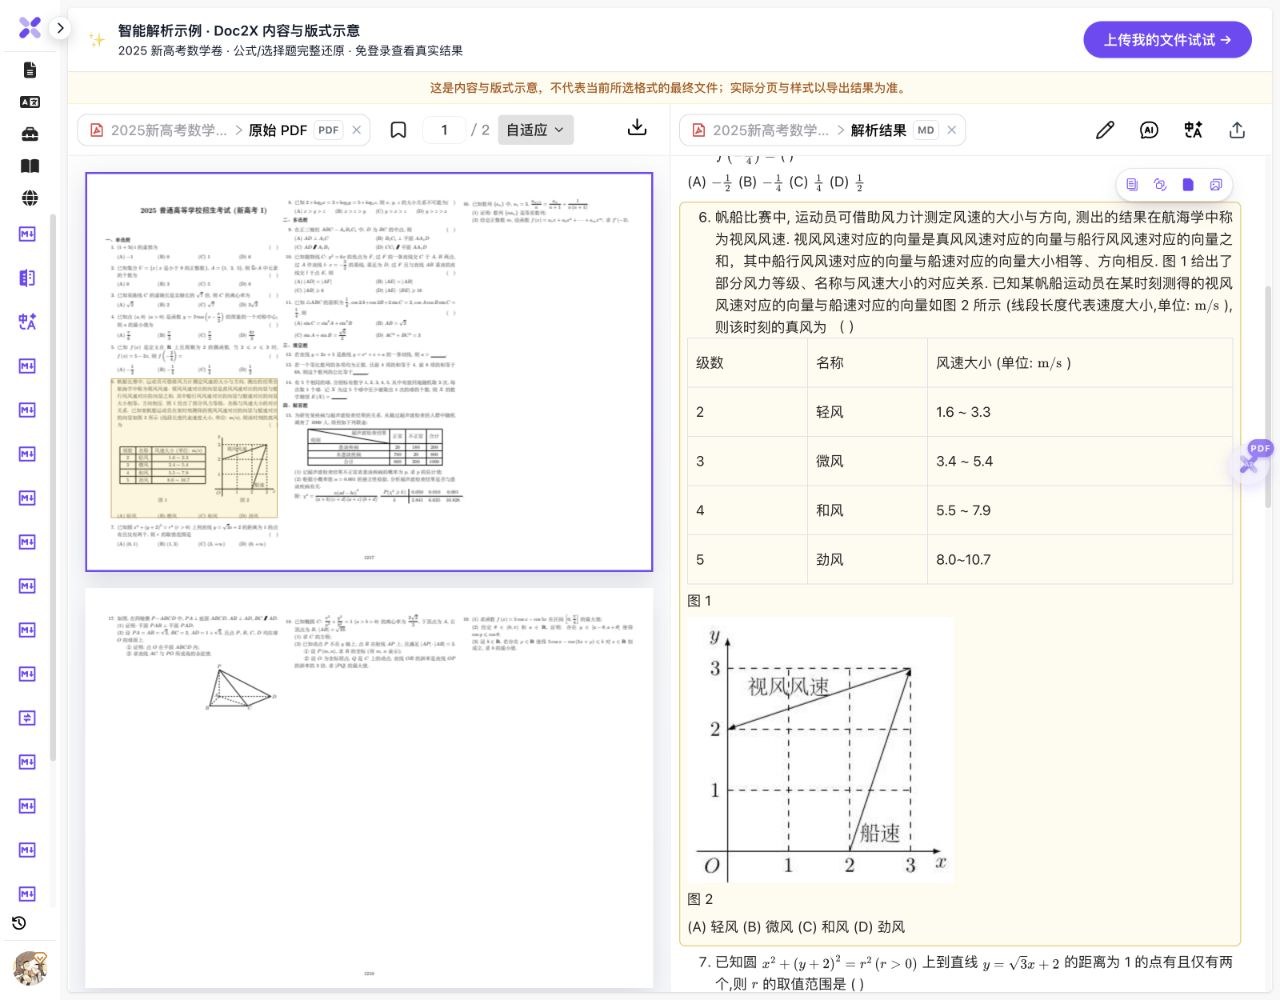
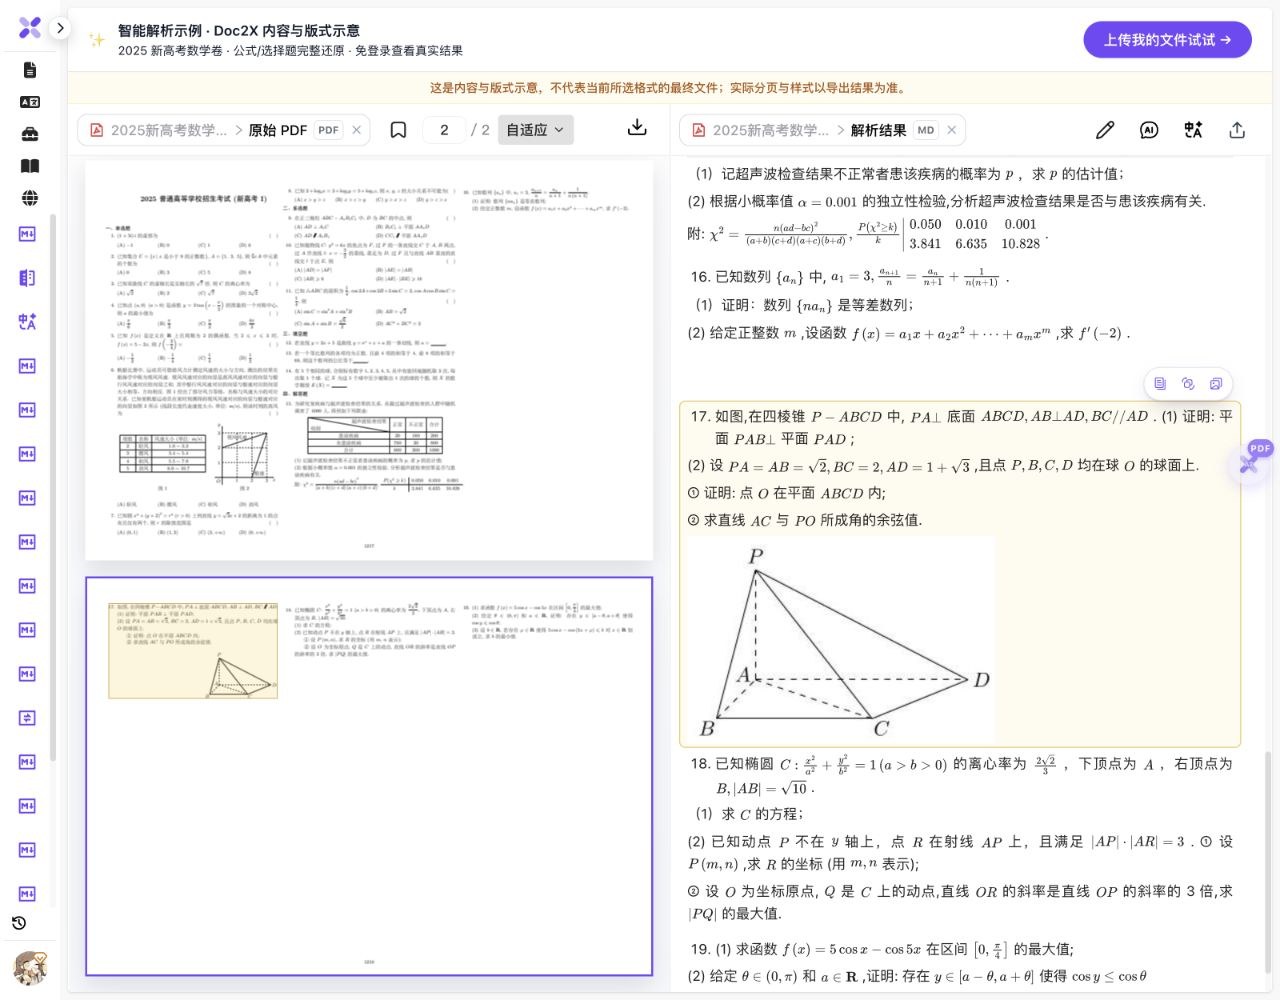
沿用已公开的两页数学试卷与网页解析 JSON,原始文件字节保持一致。本地选取第 6、17 题的完整文本范围,记录文件哈希、JSON 路径和字符范围,并实际点击网页解析内容回到原页。
本地生成的第一份来源记录(正文另存于核对包)
{
  "chunk_id": "reviewed-q6",
  "provenance_kind": "locally_selected_public_web_demo_excerpt",
  "source_pdf": "real-parse.pdf",
  "source_pdf_sha256": "221aeea90ccb7fb26c181693d06618170931038a73732c1018b02aa7feb4379a",
  "source_json": "web-demo-pages.json",
  "source_json_sha256": "5904114f00e113a34cd3244ff23af660d40a86422cacec1b767d1ab18ec3326b",
  "source_json_pointer": "/pages/0/md",
  "web_page_index": 0,
  "pdf_page_number": 1,
  "printed_page_label": "1217",
  "printed_page_label_source": "manually_checked_same_pdf_footer",
  "source_char_start": 902,
  "source_char_end_exclusive": 1645,
  "offset_unit": "unicode_code_points",
  "text_sha256": "b8131a0238007dae730d9a76d5e2f9692350c3c8bfec73247d66c287799df711"
}
- 网页索引 0 对应 PDF 第 1 页,页脚印刷号为 1217;索引 1 对应第 2 页,印刷号为 1218。印刷号是对照同一 PDF 人工记录的。
- 第 6 题片段来自 /pages/0/md 的字符范围 [902,1645),包含完整 HTML 风速表、m/s 单位、图注和配图引用;没有只取一个脱离上下文的数值。
- 第 17 题片段来自 /pages/1/md 的 [0,476),包含几何条件和配图引用。范围按 Python Unicode 字符计数,结束位置不包含在片段内。
- 解压后运行附带的 Python 标准库脚本,可核对两份原始文件、两段文本与两张图片。字面查找风速大小、四棱锥分别回到第 1、2 页;不存在的文本返回空结果。
这是既有公开网页样例的本地派生核对包,没有新建解析/API任务。两段范围由人工选择,reviewed-q6 等是本地记录 ID;本 JSON 没有 layout.blocks、bbox 或 API block id,脚本没有补造这些字段。示例未建立向量索引、调用模型生成答案或评估检索召回率。
先了解这几件事
先保留原 PDF 与实际解析结果,再为切片记录来源版本、页面和文本范围。表格、单位、图注和公式条件应一起核对。本页用两段公开样例演示可复现的来源映射;接入向量库、权限过滤和生成答案后,还需要在自己的系统验证检索与回答。
- 原件
- 同一份两页 PDF 与网页演示 JSON,保存 SHA-256。
- 来源
- 区分网页索引、PDF 页序与印刷页码。
- 上下文
- 整段保留表格、单位、图注与图片引用。
- 验证范围
- 本地一致性检查与字面查找,不作为检索质量评测。
三种位置标识,分别保存
| 标识 | 本例第 6 题 | 用途与边界 |
|---|---|---|
| 网页数据索引 | pageIdx = 0 | 用于这份网页 JSON;不直接冒充 API page_idx |
| PDF 文件页序 | 第 1 页 | 用于打开同一份 PDF 的对应页面 |
| 页脚印刷号 | 1217 | 人工对照原 PDF 记录,不由索引加一计算 |
| 片段文本范围 | [902,1645) | 同一版本 md 的 Unicode 字符范围,不是坐标框 |
解析质量与来源记录一起验收
文本能被读到不代表所有内容已正确识别。本例从原 PDF、网页正文、表格单位与配图一起核对;来源哈希仅说明引用的是哪份文件,不能代替文字或数学内容检查。
让表格与说明一起进入后续处理
本例风速表的数值需要级数、名称和 m/s 单位解释,题干和向量图还有额外条件。只留下一个数字或把图注切到别处,会使下游缺少判断依据。
为自己的切片保存清楚的身份
本地 reviewed-q6 与 reviewed-q17 只是两个已审阅片段的标识。原 PDF 哈希、原 JSON 哈希、JSON 路径和字符范围共同记录它们的来源;文件改变后应重新生成并验证映射。
先证明可回源,再评价检索质量
附带脚本的查询是两段文本上的字面查找,便于核对路径与页码。它没有 embedding、向量排序或生成回答,不应用这三个查找用例宣称生产 RAG 召回率。
API 接入与网页结果按各自结构读取
真实 v3 API 的 data.result、page_idx 和 layout.blocks 以当前文档及实际响应为准;公开网页演示使用 pageIdx,没有布局块。按来源选择适配器,缺失坐标时保留缺失状态。
接入解析API前,先验收保存结果
需要接口集成时,先按文档解析API选型页的清单对照代表性PDF,再用下载脚本检查已保存成功结果。它能发现页索引和布局结构问题,但不做OCR准确率或检索评测。网页演示JSON与公开API字段不同,现有来源核对包继续保留原始网页数据,不能由本地字符范围补造bbox。
相关官方说明
详细操作教程
选择上传用途与页码,开始解析后对照原文检查结果。
遇到这些情况
- 片段能查到,却打不开原页
- 核对 PDF 文件版本、页序和保存位置;不要把印刷号当作文件页序。
- 只有数值,没有单位或图表条件
- 回到原始正文扩大该片段上下文,重新核对表头、单位与配图。
- 图片引用存在,离线却不显示
- 同时保存资源。本包保留原始 src 字符串,并用 resource-map.json 指向本地图片,未自动重写成离线网页。
- 想按坐标高亮,但 JSON 没有 bbox
- 先确认来源和字段。不要根据 Markdown 长度补造坐标,实际布局应来自对应结果。
常见问题
解析 API 是否直接提供完整 RAG 系统?
解析结果可作为输入。索引、检索、权限与回答验证需要在自己的系统实现;网页版多文档对话是另一条完整用户流程。
本例脚本是通用分块器吗?
不是。它只验证固定公开样例中的两段人工选择范围,目的是展示来源记录与一致性检查。
哈希匹配是否说明识别内容正确?
不说明。哈希验证字节与版本,识别准确性仍需对照原 PDF。
每个表格都应该整块送进模型吗?
按任务与模型预算评估。切分时保留表头、单位、上下文与来源,再验证真实查询,不从一个示例推导通用最优块大小。
内容核对:2026-10-16 · 功能条件与配额以当前产品界面为准