
本页内容
对照原页与正文,再选择需要的结构字段
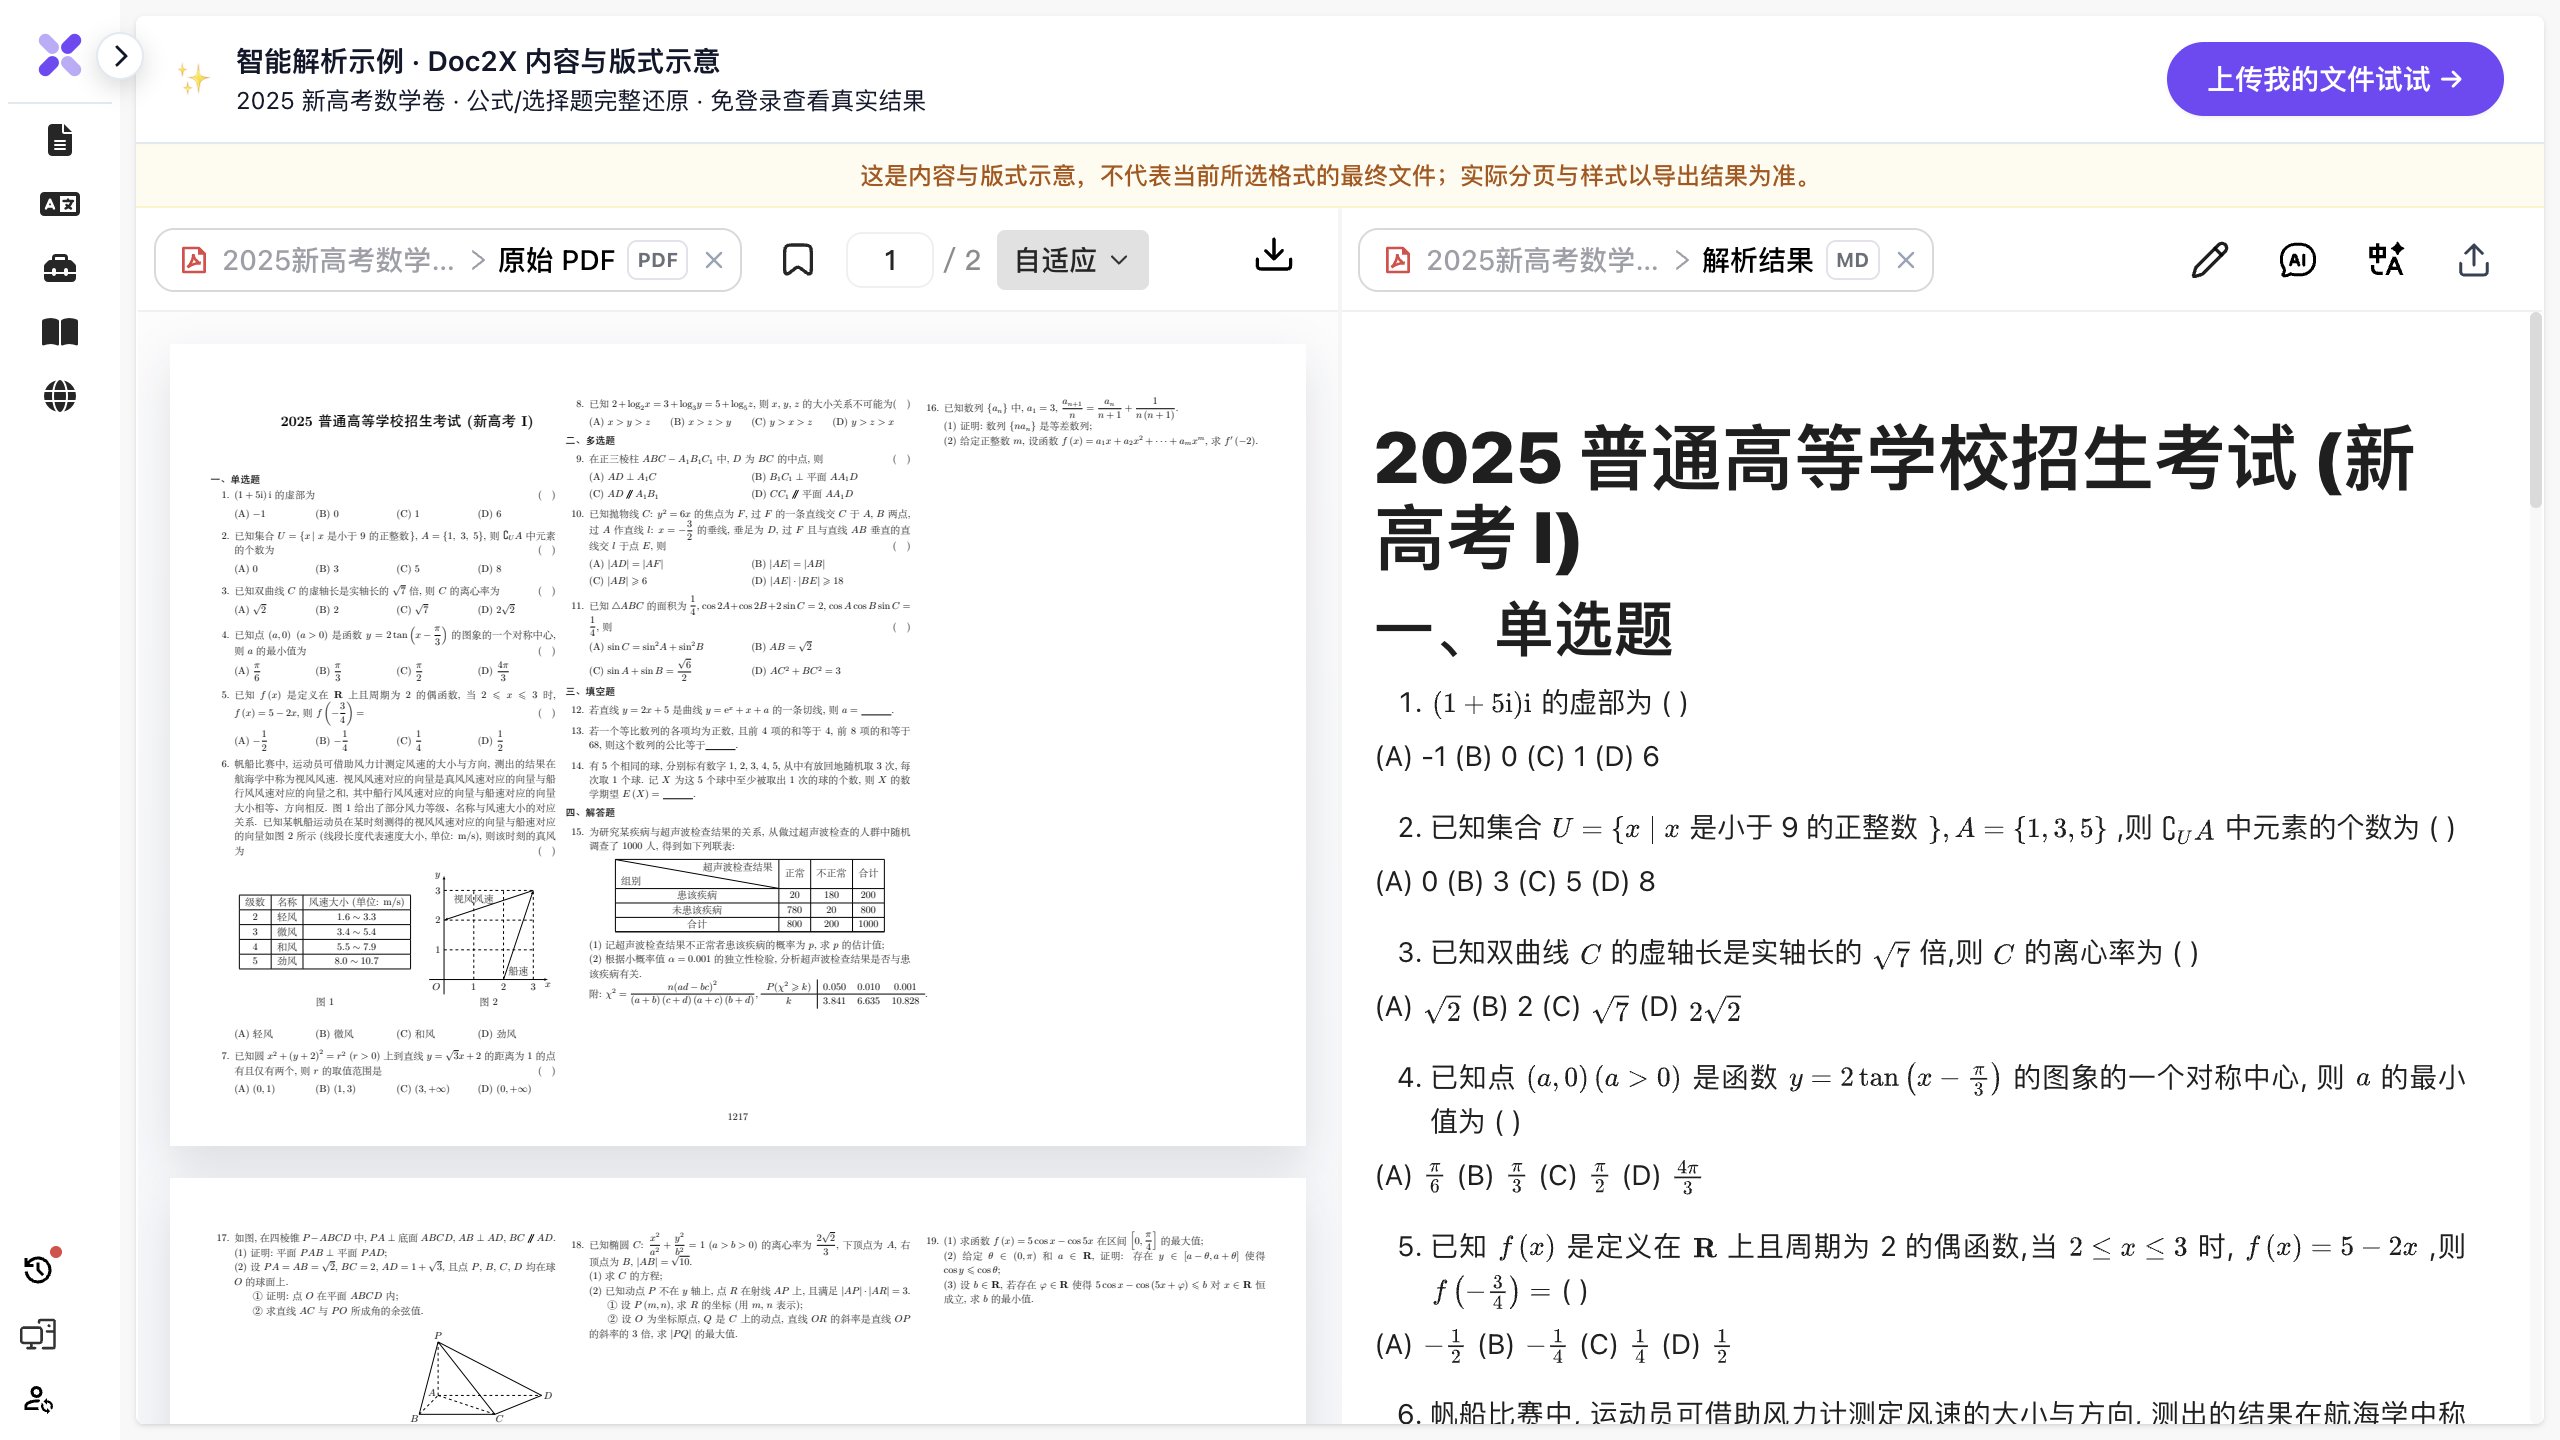
这份两页数学试卷包含三栏题目、公式、表格和配图。打开公开演示,可在左侧看原 PDF,在右侧核对解析正文;下方核对包原样保存同一 PDF 与网页演示 JSON,便于查看文字和页面的组织方式。
网页演示第 1 页的实际字段摘录(md 正文未展开)
{
  "url": "",
  "pageIdx": 0,
  "pageWidth": 2332,
  "pageHeight": 1649
}- 打开原 PDF 第 1 页,核对标题、题号、公式以及第 6 题风速表的单位和行列。
- JSON 的 pages 共两页,每页 md 保存正文。第 2 页含配图引用,保存 JSON 本身不会一并下载图片。
- 这个公开 JSON 使用 pageIdx 等网页字段,没有 layout.blocks。接入 API 时按下方官方字段说明读取实际响应。
2026-10-10 核对的既有公开样例,没有重新调用解析 API。ZIP 是原 PDF、网页 JSON、来源与校验记录的汇集,不是原始 API 响应或离线 Markdown 导出包,不含配图资源。网页演示数据和补建段落坐标不能用于验证 v3 API 坐标或识别准确率。
先了解这几件事
Doc2X v3 JSON 在每页 Markdown 正文之外提供 layout.blocks,用元素类型、阅读顺序、分组和坐标连接内容与原页。接入时保存成功响应中的 data.result,并保留同版 PDF;公开网页演示的 pageIdx、paragraphs 等字段不能当作原始 API 结构。
- 正文
- page.md 适合展示与文本处理,仍需检查公式、表格和图片。
- 结构
- page.layout.blocks 提供块类型、bbox、reading_order 与父子关系。
- 回源
- 保留文件版本、page_idx、block id 与原始坐标,核对后再切分或裁切。
v3 JSON 字段怎么用于文档处理
| 要做的事 | 实际结果字段 | 接入时核对 |
|---|---|---|
| 展示或导出正文 | pages[].md | 保留 Markdown、公式和图片引用;正文可用不等于图片已保存。 |
| 回到对应页面 | page_idx、page_width、page_height | page_idx 从 0 开始;结果坐标范围与 PDF point 不能直接混用。 |
| 区分文字、公式、表格、代码 | layout.blocks[].type | 按类型处理,并兼容扩展类型;不要只靠外观猜测。 |
| 恢复块间关系与阅读顺序 | reading_order、parent_id、linking | 结合分组与原页检查多栏、图注、脚注,不只依赖数组顺序。 |
| 使用表格与图片 | table_data.html、src、bbox | HTML 表格、图片 URL 和原页裁切用途不同;空 src 要按实际结果处理。 |
| 判断页眉页脚是否纳入正文 | attributes.is_boilerplate | 结合内容用途筛选,保留原始结果,避免误删有用上下文。 |
成功响应与保存层级
先检查 code 与 data.status 都表示成功,再保存 data.result。它包含 pages;每页的 md 与 layout.blocks 分别承担正文和结构信息。完整响应外壳、结果对象与网页演示 JSON 不能不加区分地交给同一段读取代码。
坐标使用同一份 PDF 核对
bbox=[x1,y1,x2,y2] 应结合结果页面宽高映射到原页。原 PDF 被旋转、裁切、插页或替换后,坐标可能不再对应;不要直接把结果数值当作 PDF point,也不要修改坐标掩盖版本不一致。
表格结构与表格截图分别使用
table_data.html 适合读取已识别单元格与跨行跨列关系;按 bbox 从原 PDF 裁出的 PNG 只是区域图像。需要 Excel 时选择对应导出流程,不能把表格截图等同于可编辑单元格。
面向 RAG:保留上下文与来源
切分前结合标题、图表组、公式及说明文字。每个片段保留文件版本、页码和 block id,再用真实问题核对检索与引用。块数量和结构标签本身不能证明答案正确。
17 类版面元素,保留文档结构
另有 attributes.is_boilerplate 标记,用于识别页眉、页脚、页码等样板文字。
如何开始
- 按 PDF API 预上传指南显式选择 v3-2026,并保存原 PDF 与 uid。
- 确认任务成功,保存 data.result,再检查 pages[].md 和 layout.blocks。
- 选择一页含多栏或图表的内容,对照原页检查 reading_order、分组与 bbox。
- 保留原始 JSON,再按业务需要生成阅读器、切片或裁图结果;处理空字段和新增类型。
按上面的步骤,继续处理你的资料。
查看 v3 JSON 文档相关官方说明
详细操作教程
以当前真实响应核对结构、页面与内容字段,再接入自己的系统。
遇到这些情况
- JSON 里找不到 layout.blocks
- 先确认文件来自原始 API 结果还是网页演示,再核对模型与保存层级;不要因为缺字段直接重建任务。
- 裁出的图表错位
- 核对 PDF 版本、页面索引、旋转和结果页面宽高;原图与坐标必须来自同一文件。
- 顺序正确,但问答仍找不到依据
- 检查切片是否把标题、表格单位、图注或公式条件分开;用具体问题检验检索和回源。
常见问题
pageIdx 和 page_idx 可以直接互换吗?
公开网页样例使用 pageIdx,当前 API 文档使用 page_idx。先识别数据来源与保存层级,再显式转换;仅改一个字段名不能补出缺失的 layout 或真实坐标。
只有 Markdown,可以生成同等可靠的 bbox 吗?
不能从文字位置直接推断原页坐标。需要位置时使用实际布局结果,并与同版 PDF 核对;补建坐标应标为推导数据。
score 是文字识别准确率吗?
不是逐字准确率。它是结果中的质量分,不能把 85 写成“85% 的文字正确”,仍需对照原文核验。
拿到 table_data.html 就等于原表版式完全保留吗?
不等于。需分别核对单元格文字、行列和合并关系,以及原页的图形表头、脚注和布局。
图片 URL 为空或失效怎么办?
先检查已保存资源和实际字段;如果原 PDF 与有效 bbox 都在本地,可按官方指南裁出区域图像,再核对位置。裁图不等于重新识别。
内容核对:2026-10-10 · 功能条件与配额以当前产品界面为准