
本页内容
识别代码后,先检查缩进与符号
- 准备清晰且完整的代码图片或 PDF,保留原稿;已有可复制源码时,直接使用源码通常更省事。
- 从解析入口上传文件,核对范围与当前消耗,确认开始解析。
- 下载一份原始结果,对照原稿检查缩进、字符、括号和代码块边界。
- 在原任务支持的编辑入口修订,保存并确认版本后重新导出,再用相应语言的工具检查语法和实际含义。
OCR 结果不是可直接信任的程序;核对引号、空白、相似字符,并在自己的开发环境中审查。
同一页代码:保留原始错误,再对照校对后的下载
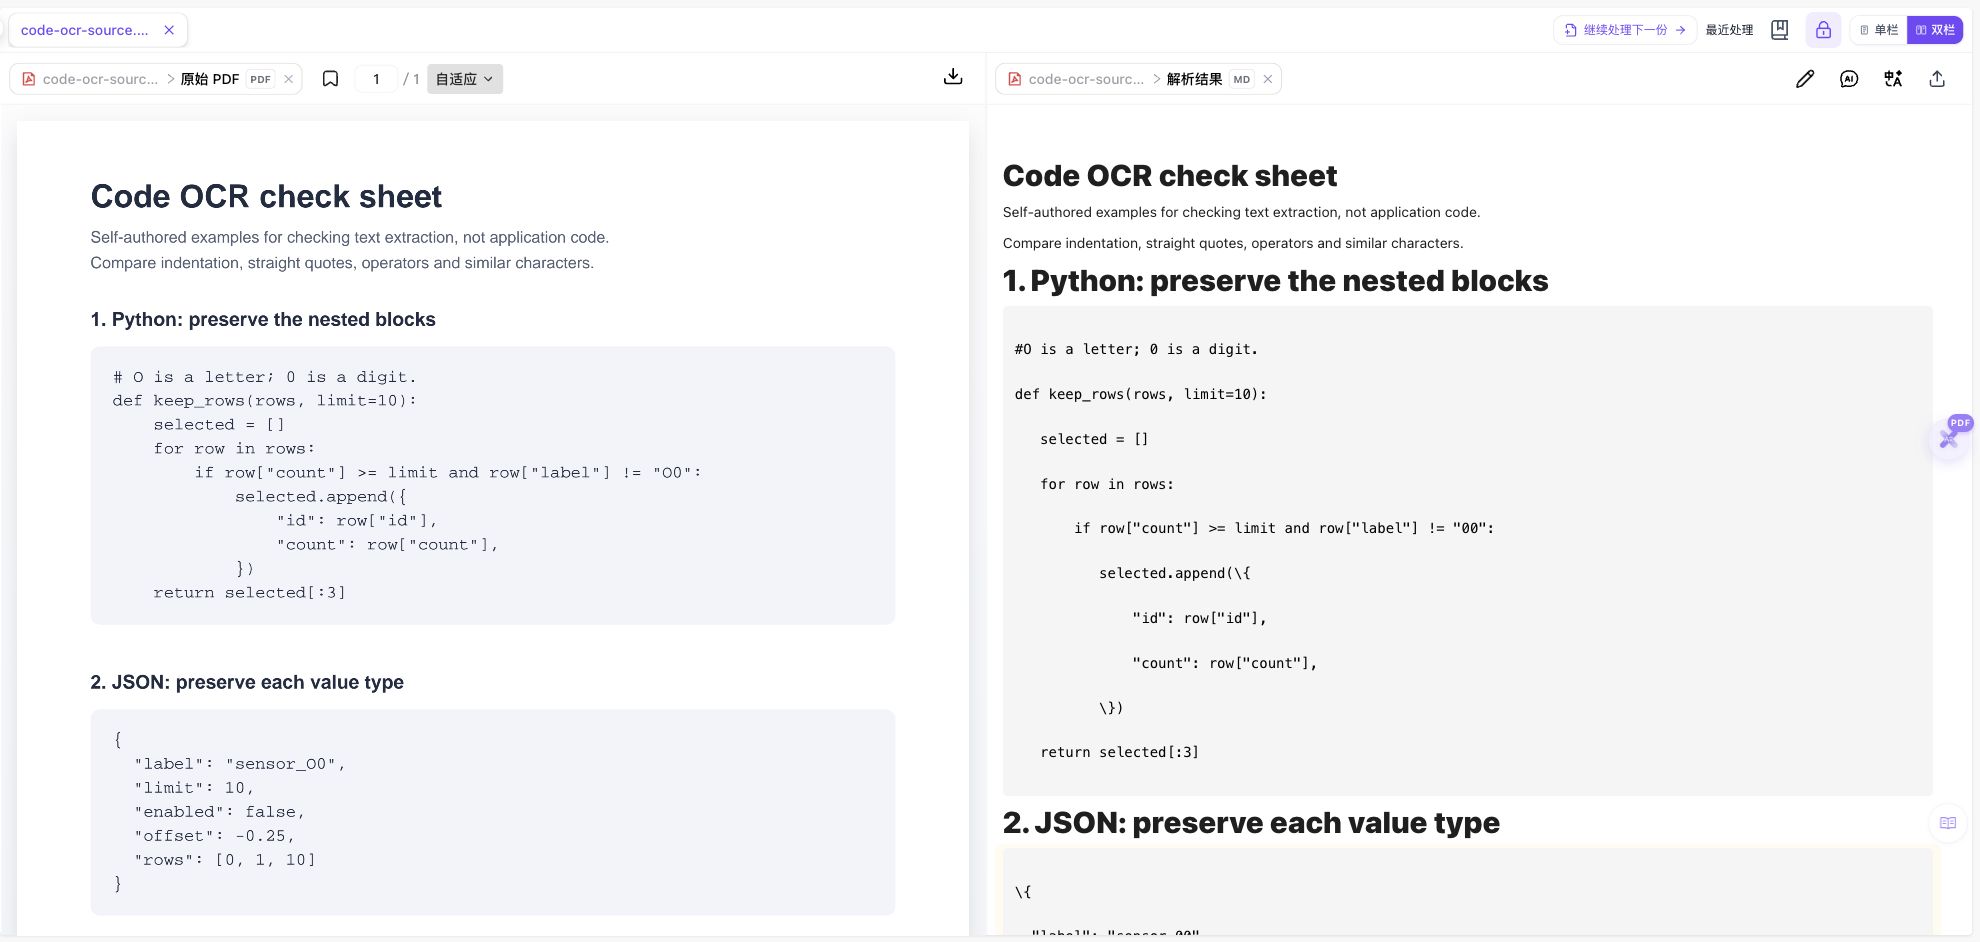
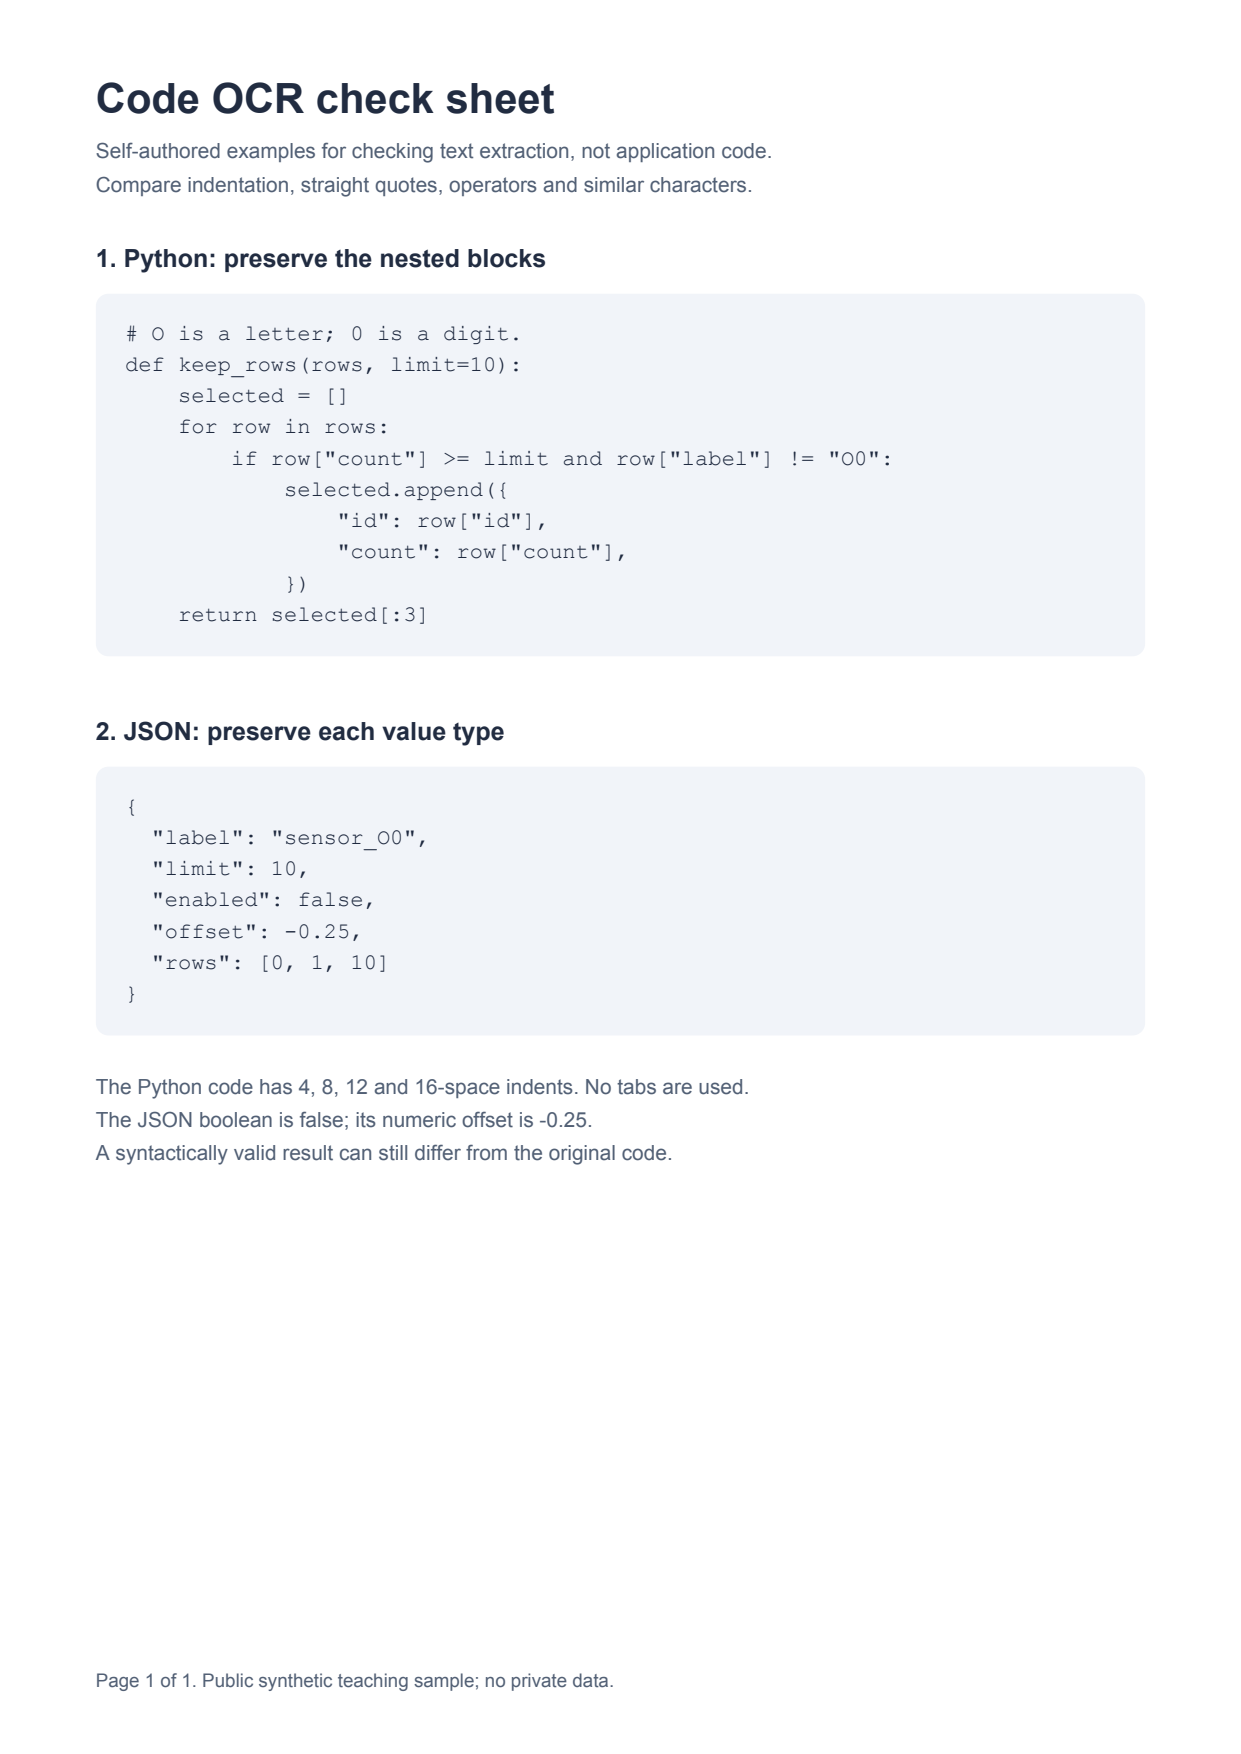
2026年10月11日,将自编的一页原生文字 PDF 与由它渲染的 150 dpi PNG 分别上传解析。文稿含 10 行 Python 和 7 行 JSON。两份初次 Markdown 均保留缩进,但包含字符与转义问题;随后只校对 PDF 任务,保存版本 1、重新加载核对,再下载第三份文件。
PDF 初次导出的 Python 原样摘录:此处仍有错误
#O is a letter; 0 is a digit.
def keep_rows(rows, limit=10):
    selected = []
    for row in rows:
        if row["count"] >= limit and row["label"] != "00":
            selected.append(\{
                "id": row["id"],
                "count": row["count"],
            \})
    return selected[:3]
- 三份 ZIP 各含一个 Markdown 文件,都有两个未标注语言的代码围栏;Python 10 行、JSON 7 行的缩进宽度保持一致。
- PDF 初次结果在四个大括号前带上反斜杠,且把 O0、sensor_O0 中的字母 O 变成了数字 0。Python 语法检查在第 6 行报错,JSON 从第 1 行起无法解析。
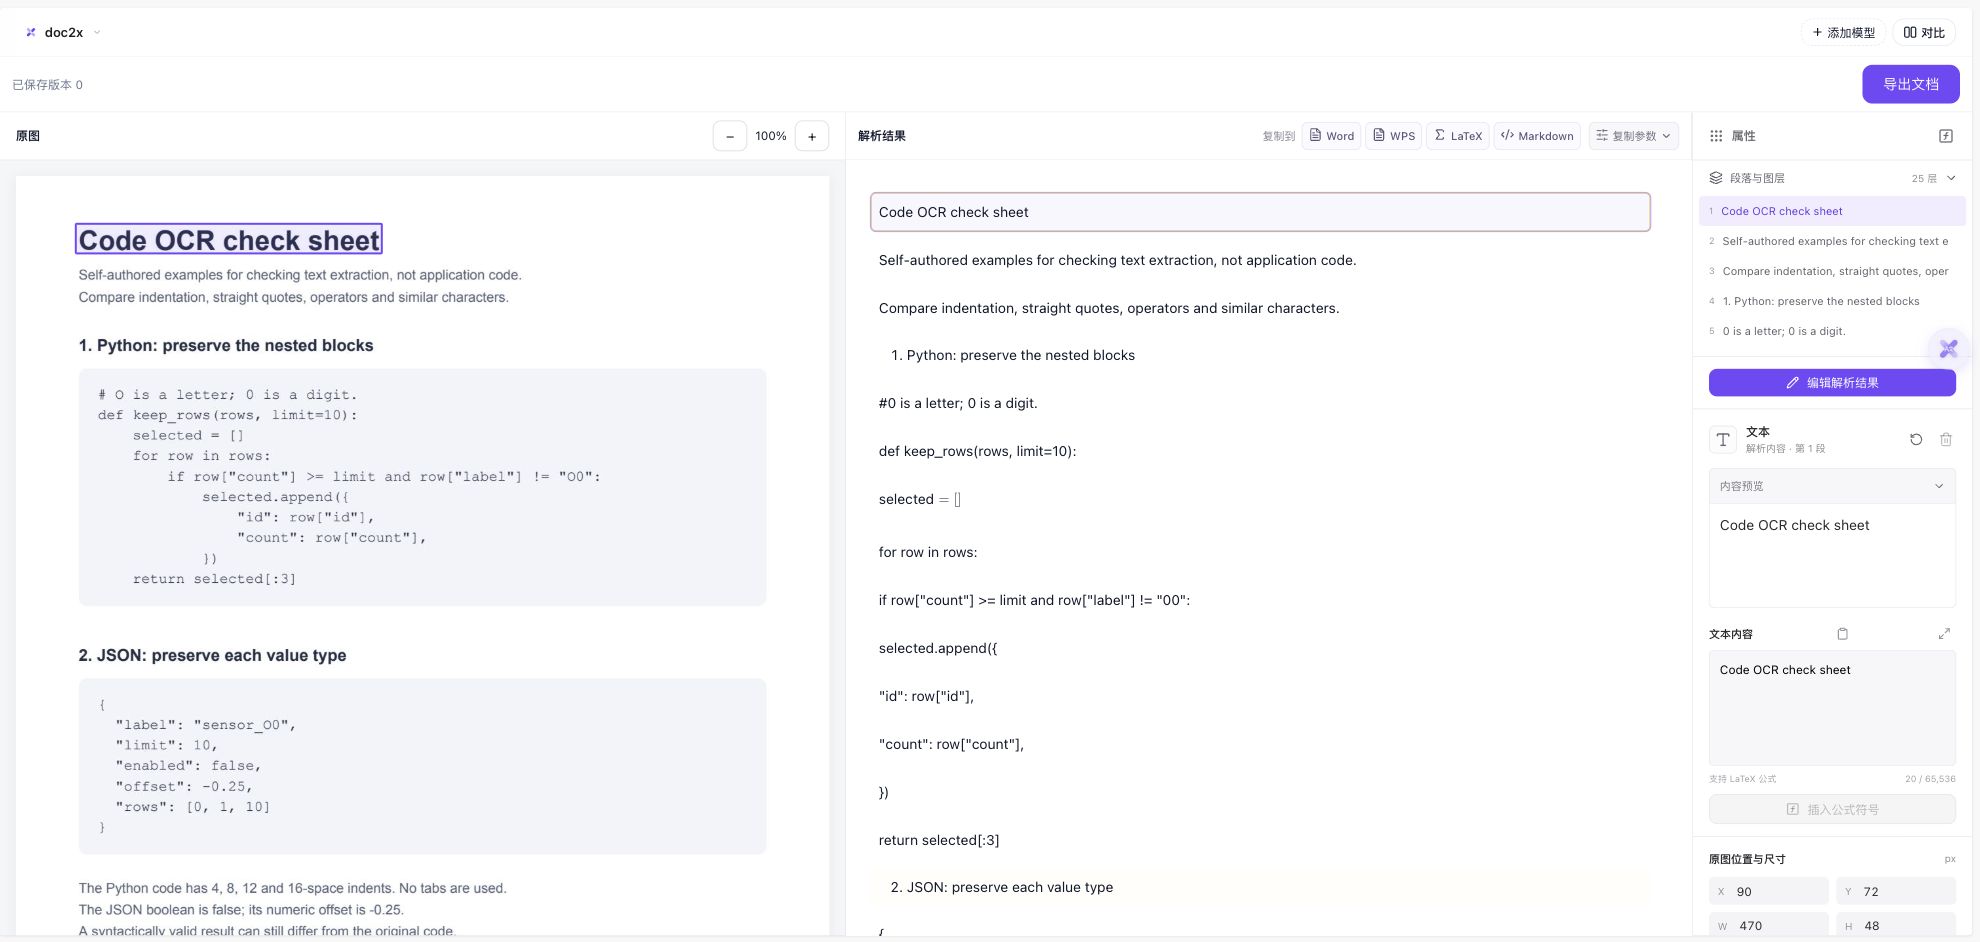
- PNG 初次结果还把 selected = [] 和 JSON 的 rows 数组转成 LaTeX 片段,代码注释中的 O 也变为 0。它的 Markdown 仍有代码围栏,但不能直接作为正确源码使用。
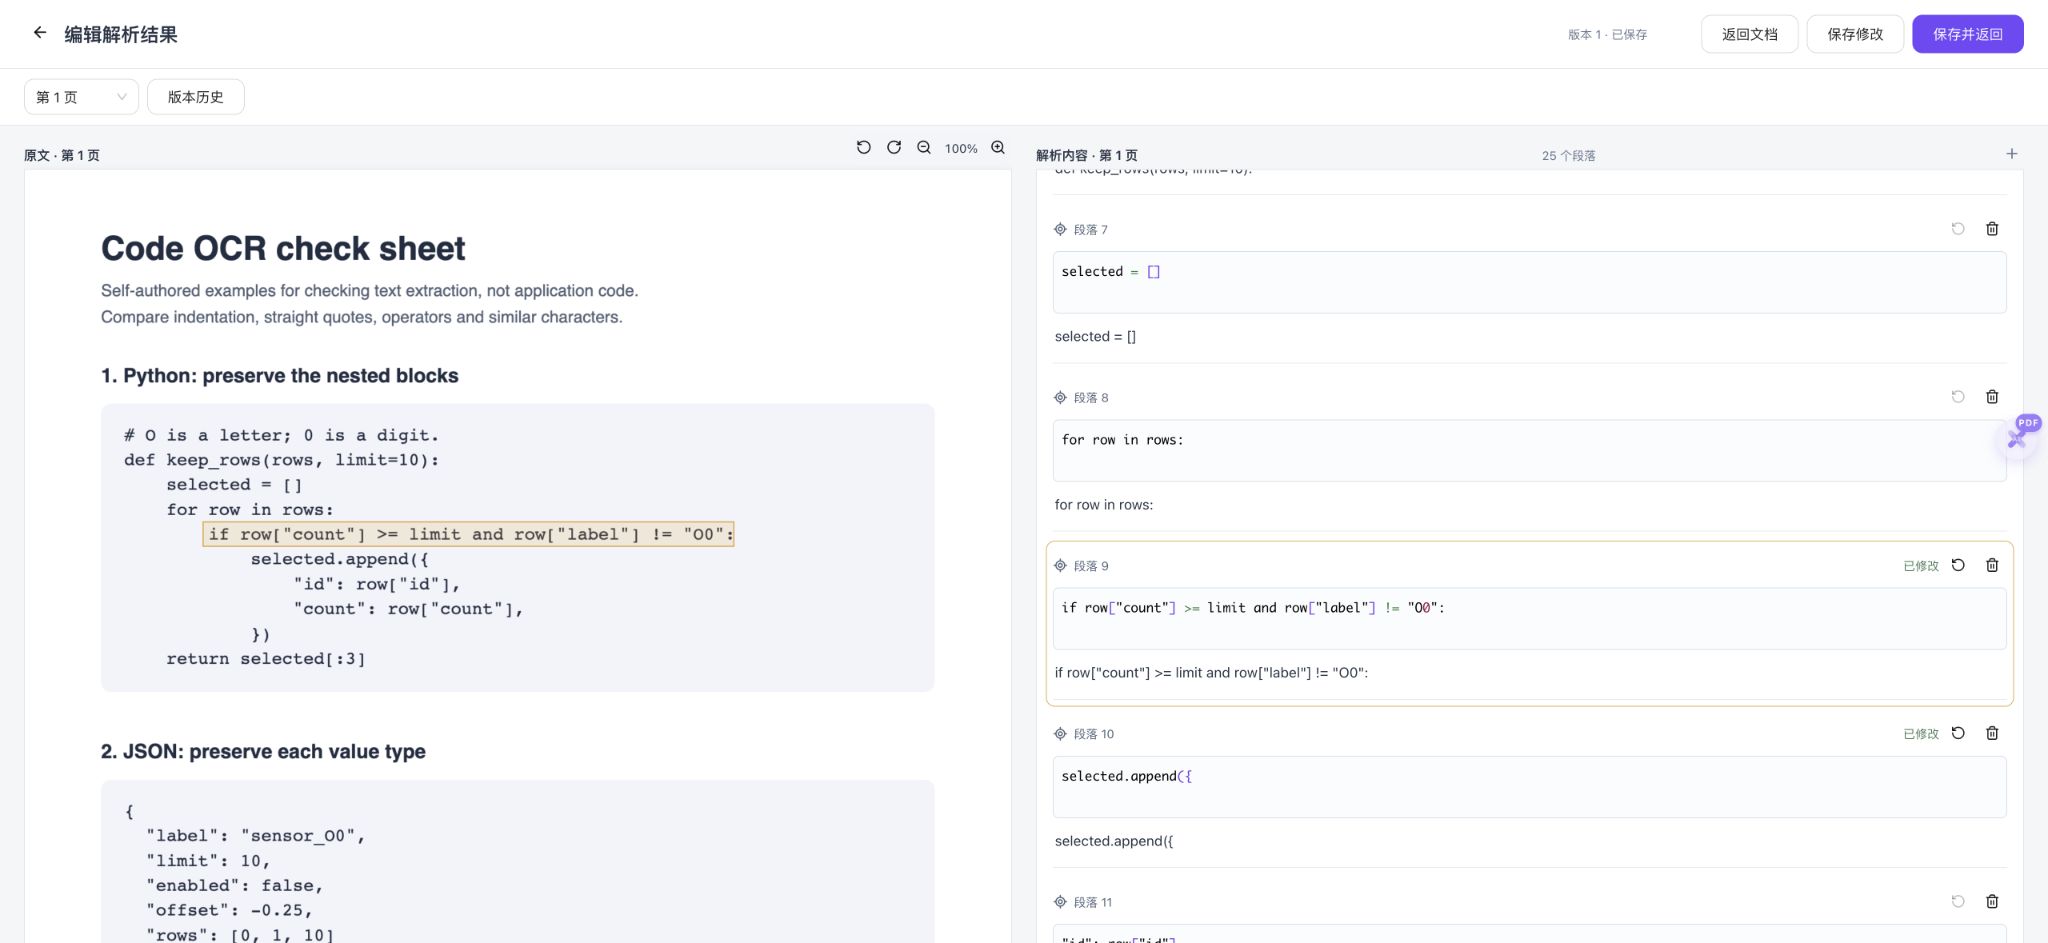
- 在 PDF 原任务中修正四处大括号转义、两处字符串和一处注释空格,保存后重新加载,七个段落的值均保留。再次导出的两个代码块逐字节等于自编参考源码。
- 校对后的 Python 与 JSON 通过本地语法检查。相同自编函数另用六条虚构记录核对;这一小样例不代表任意程序、输入或业务逻辑都正确。
三份 ZIP 保留真实下载内容,未在下载后改写。PNG 任务仍为未修订的版本 0。完整文稿的页脚未进入 Markdown,精确一致只指校对后的两个代码块。样例是清晰浅底文稿,不含真实 IDE 截图、深色主题、行号、手写或其他语言;没有测试 API 返回。完整核对 ZIP 为本地整理,含原稿、参考源码和三份原生导出。
先了解这几件事
代码 OCR 适合提取图片或 PDF 里已有的代码文字。上传解析后先保留原始下载,再对照原稿核对缩进、引号、括号和相似字符;需要修订时回到原任务编辑,确认保存后重新导出。代码围栏与缩进存在,仍不能说明源码准确。
- 输入
- 本例实际上传 1 页原生文字 PDF 和同页渲染 PNG,各解析一次。
- 输出
- 三份 Markdown ZIP:PDF 原始、PNG 原始与 PDF 校对后版本。
- 核对重点
- 缩进、引号、O/0、括号转义及混入代码的数学源码。
- 用途范围
- 提取已有代码文字;界面截图生成网页、判断代码作者是其他任务。
- 深色与行号
- 新增合成深色样例:原生Markdown有代码框,仍混入行号、缩进与O/0差异。
深色代码与行号:下载有代码框,仍不能直接当Python源码
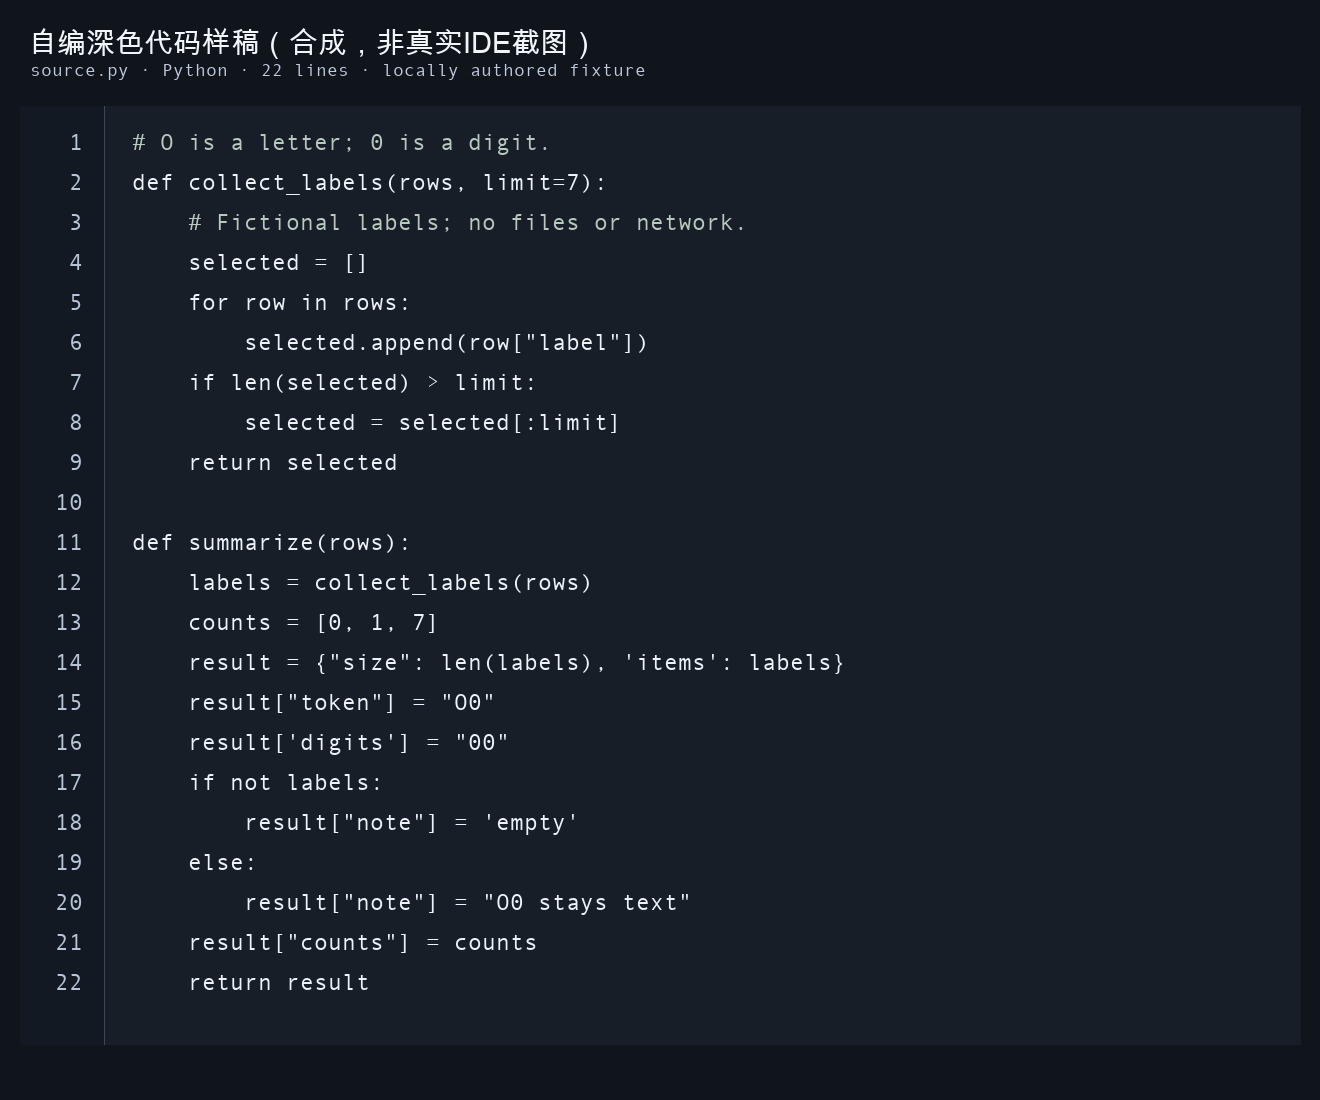
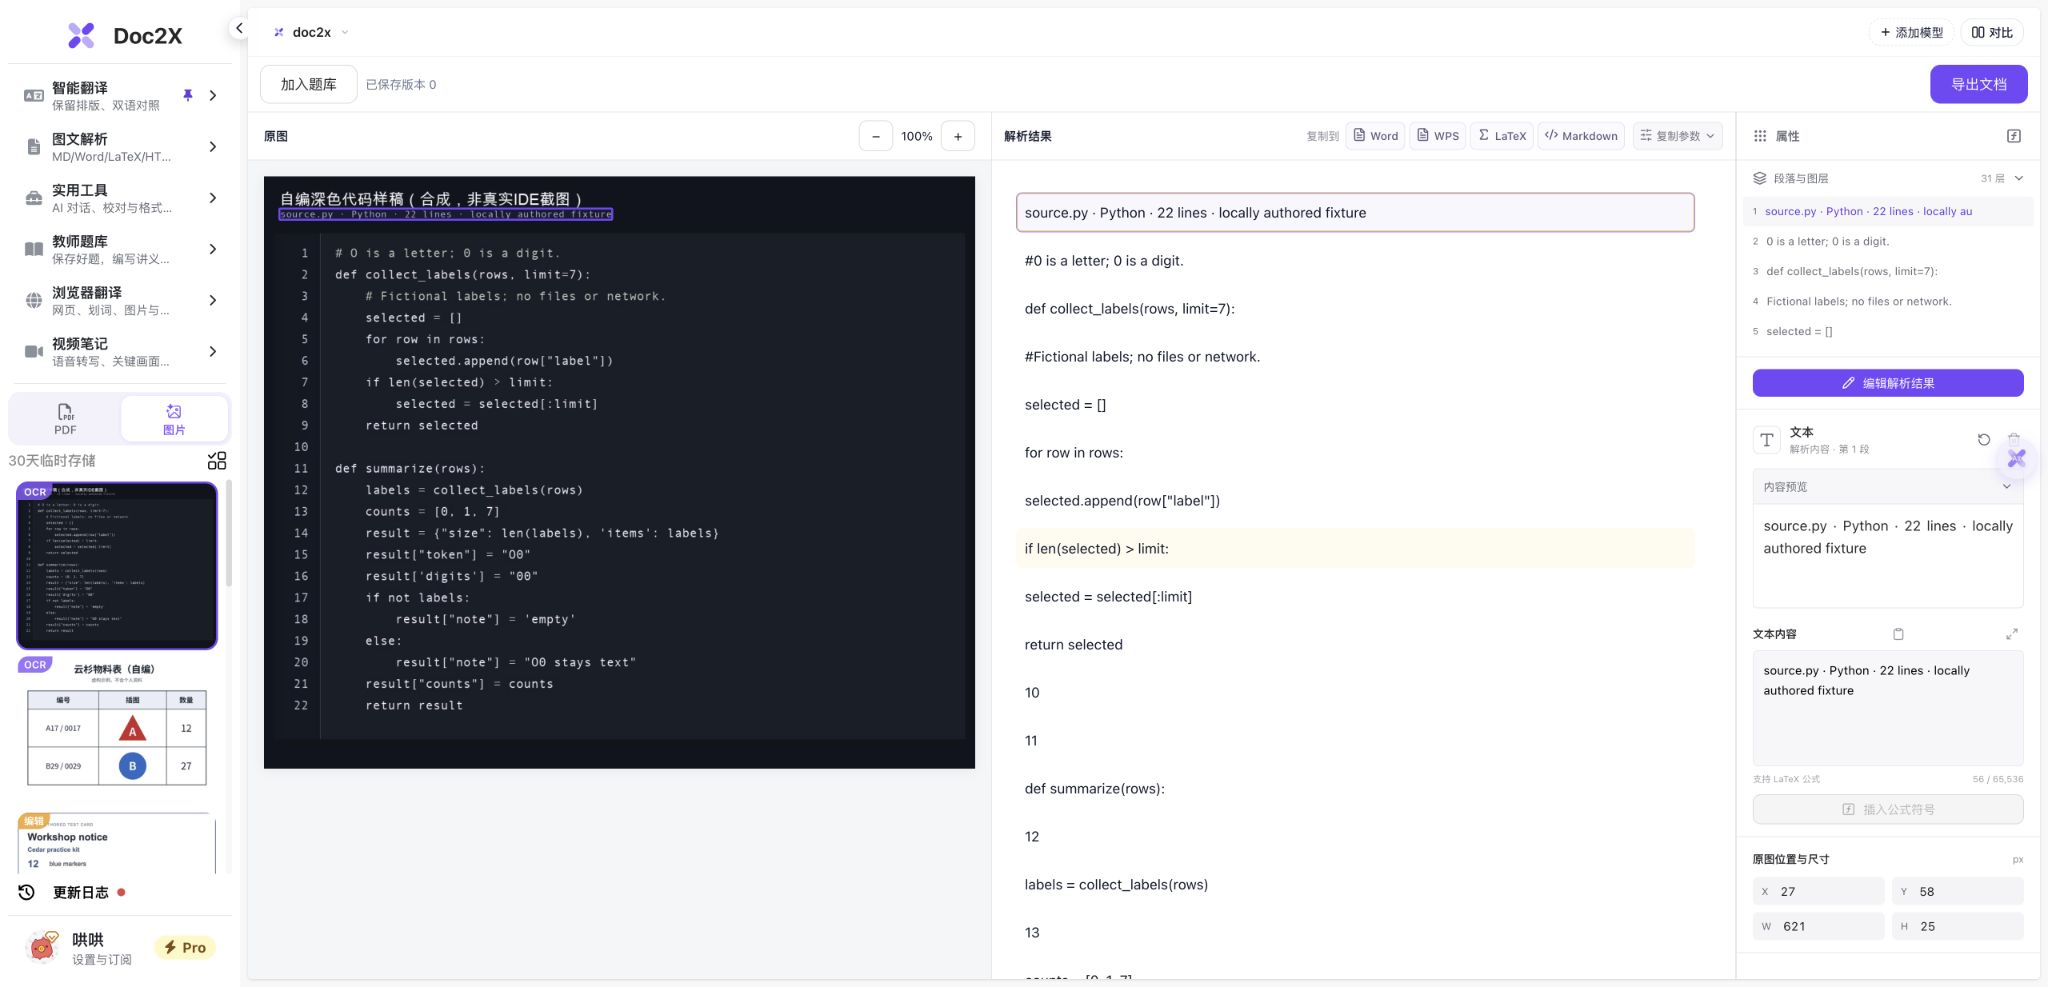
2026年10月19日,一张自编合成深色代码PNG实际上传识别一次、导出Markdown一次。原生下载有一个无语言标签的代码框,仍带入边栏数字、额外缩进、反斜杠及O/0差异;原图、原生ZIP和未改写Markdown都可下载。本例没有编辑结果、保存修正版或执行程序。
| 核对项 | 合成图片参考 | 本次原生Markdown |
|---|---|---|
| 边栏行号 | 边栏显示1至22,不属于Python源码 | 10为独立行,11至18附在部分代码行首 |
| 缩进与代码框 | 22行参考,主要为0、4、8空格层级 | 27行Markdown,一个无语言标签代码框;非空行有0、5、9、13空格及混入行号 |
| 字母O与数字0 | O0出现2处,00出现1处 | O0未见,00出现3处;注释中的O也变为0 |
| 原样静态语法检查 | 参考源码静态检查有效,未执行 | 代码框按Python候选检查,报IndentationError:unexpected indent |
- 实际原生ZIP为584字节,提取的Markdown为788字节。它确有一个无语言标签的代码框,框内22行;网页的31个结果段落不代表下载没有代码框。
- Markdown第13行独立出现10,第14至21行带11至18前缀;参考中的两处O0均未保留,字典大括号前还出现反斜杠。数字、缩进和字符分别核对,不能只看深色预览或代码框样式。
- 原始检查只选择明确标为Python的代码框,因此该次语法观察为空;随后单独把实际无标签代码框原样作为Python候选检查,在框内第2行、Markdown第5行报unexpected indent。没有去行号、调整缩进或修复后再测。
- 本轮未执行参考或识别代码,没有形成修正版。需要使用时,先审阅实际字符与用途,在自己的副本整理,再做相应语言的静态检查与必要验证;识别导出成功不等于程序可直接运行。
此新增深色行号样例与上方浅底Python/JSON及保存修订样例分别记录。合成图片用于观察这一输入的识别与导出结果,不是对真实IDE、任意深色主题、字体或代码语言的准确率保证。核对说明含自编参考文字,原生ZIP与Markdown保持下载字节,没有另建公开Python文件或核对ZIP。
同一页材料,三个真实导出分别证明什么
| 结果 | 本例观察 | 使用前还要做什么 |
|---|---|---|
| PDF 初次 Markdown | 两个代码块、缩进保留;大括号转义与 O/0 有误 | 对照原稿修正字符,不能直接运行 |
| PNG 初次 Markdown | 两个代码块、缩进保留;两处方括号表达式变成数学片段 | 检查数学源码是否混入程序,另查相似字符 |
| PDF 保存版本 1 后的 Markdown | 两个代码块逐字节匹配参考源码,语法检查通过 | 在自己的语言、依赖与数据环境继续验证 |
图片输入:还要核对混入代码的数学片段
这份 PNG 由同一 PDF 渲染,再单独上传识别。图片结果界面逐段显示,下载的 Markdown 仍有两个代码围栏;其中 selected = [] 和 rows 数组被改写为 LaTeX 片段。本例的输入和结果都可下载,不能用页面看起来像代码代替检查源字符。
代码截图识别,目标是已有的文字内容
本页面向截图、图片或 PDF 中已经写出的程序代码。把网页界面截图生成前端工程、判断一段代码是否由 AI 撰写,都需要不同能力。“代码识别”这个宽泛词不能自动覆盖这些用途。
缩进保留了,符号仍可能影响结果
本例 Python 的 4、8、12、16 个空格层级与 JSON 的两空格缩进保留,但大括号前多出的反斜杠仍使代码无效。逐行检查引号、冒号、比较符号和括号配对,不只看文本排得整齐。
图片与 PDF 的实际结果分别检查
这里的 PNG 由同一 PDF 渲染,两个输入走各自的识别流程。图片输出把两段方括号表达式写成了 LaTeX 片段;PDF 输出没有这两处问题。本例不能推出更换扩展名、把图片装进 PDF 或任意截图都能得到相同改善。
代码围栏用于组织内容,不保证程序语言正确
三份 Markdown 都有两个代码围栏,但没有语言标签。保存完整多行代码有助于保留缩进;在编辑器里选择 Python 或 JSON 语法模式,仍要检查原始字符,不能把围栏存在当作已经编译或运行通过。
先保存修订,再核对新下载是否包含修改
本次使用原 PDF 的“编辑解析结果”,修正七个段落并保存版本 1。重新加载确认后回到阅读器,再次导出;新文件中的两段代码与参考源码完全一致。独立 Markdown 编辑器中的修改不等于回写原解析任务。
需要结构化字段时,另看 API 结果说明
官方 v3 JSON 文档列出 Code 和 CodeGroup 等类型,用于表达代码区域及相关说明。此处验证的是网页上传、编辑和 Markdown 下载,没有实际调用 API;不能用网页截图推定某次接口一定返回这些字段。
深色代码图片转文字,先把行号与源码分开核对
下方新增样例为自编合成深色PNG,不是真实IDE截图。实际Markdown保留一个无语言标签的代码框,但10成为独立一行,11至18混入部分代码行首;部分缩进和O/0也与参考不同。先对照原图逐行确认哪些数字是边栏、哪些是代码常量,再在副本整理缩进与字符;不能对所有数字或反斜杠一键删除,也不能因代码框存在就直接运行。
相关官方说明
详细操作教程
选择上传用途与页码,开始解析后对照原文检查结果。
遇到这些情况
- 代码里出现额外反斜杠或数学定界
- 先对照原稿定位具体字符。本例只有四个大括号前的反斜杠属于误差,不应对任意代码全局删除反斜杠。
- 语法检查通过,筛选结果却不对
- 检查字符串、常量与条件。本例 O0 被识别为 00 后,修好括号仍会筛选出不同记录。
- 已经编辑,下载仍像旧版本
- 确认修改已保存到原任务,重新打开导出并核对一个明确改过的字符;保留原始文件方便比较。
- 图片预览像公式,导出的代码也带 LaTeX
- 直接检查下载文件中的对应行。按原稿恢复程序表达式,不能把数学渲染结果当成程序语言语法。
常见问题
图片中的代码能转成可复制文字吗?
可通过图片解析提取并导出 Markdown,本页有一份真实 PNG 输入及其原始下载。结果包含字符和数学片段问题,使用前需要核对。
代码 OCR 能保留 Python 缩进吗?
本例两种输入的导出都保留了测得的缩进宽度。但字符仍有错误,不据此保证任意截图、字体或多栏代码都能正确识别。
识别出的代码可以直接运行吗?
先审阅。本页两份初始输出都未通过 Python、JSON 语法检查;只修语法后的本地对照版本,字符串仍与原文不同。
这里能从网页截图生成 HTML 页面吗?
本页处理图片中已有的代码文字。根据界面外观生成网页工程属于另一种任务,不由这个 OCR 样例验证。
导出的代码块带有语言标签吗?
本次三份 Markdown 的代码围栏都没有语言标签。可在自己的编辑器选择语言模式,保留原文件并继续检查内容。
深色代码图片转文字,行号混进来怎么办?
先保留原图与原始下载,对照每一行区分边栏行号和程序常量。本例独立10及行首11至18进入Markdown,代码里的0、1、7等数值仍有含义,不能直接全局删数字。本轮只展示实际结果与核对方法,没有生成修正版。
代码截图识别后Python缩进报错、O和0混淆怎么核对?
分别检查空格层级与原始字符。本例原样代码框作为Python候选做静态检查,在第2行报告unexpected indent;参考中的两处O0在输出里变为00。语法检查与内容含义要分开,先对照源图修自己的副本;本例没有执行程序。
内容核对:2026-10-19 · 功能条件与配额以当前产品界面为准