
本页内容
先保留原始结果,再分层检查
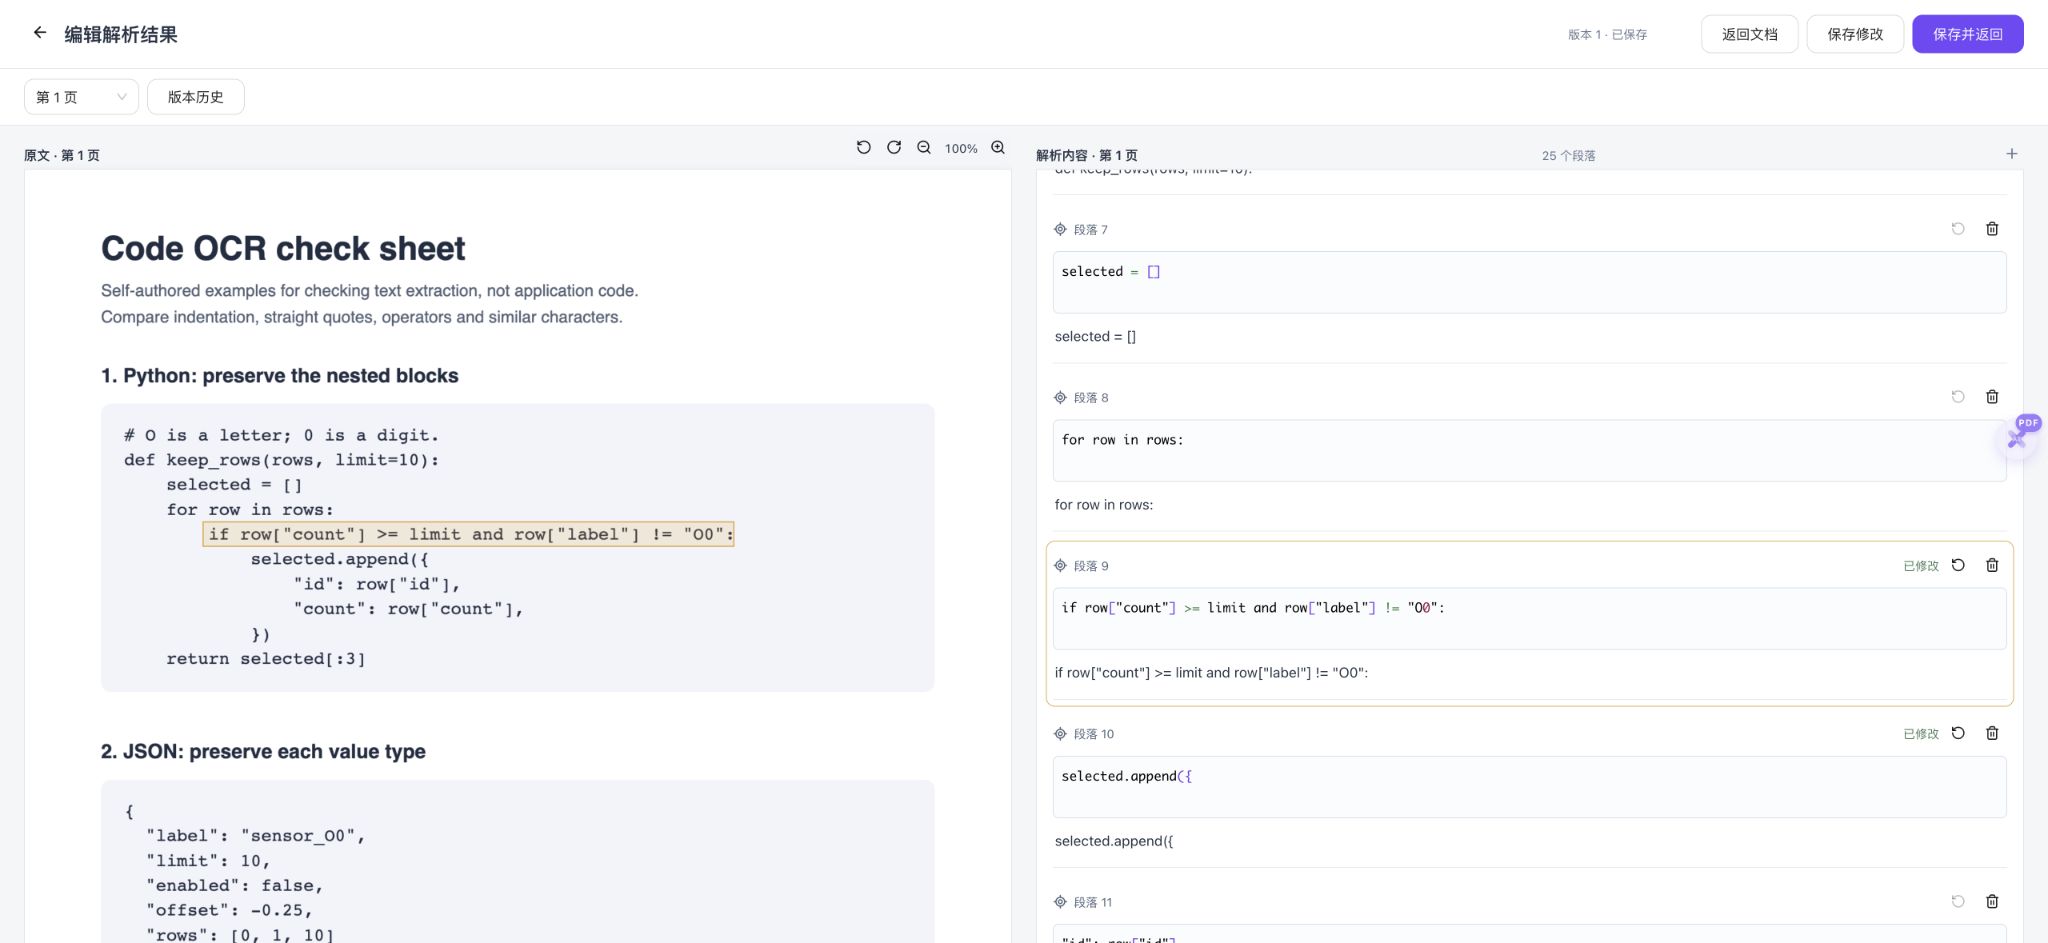
- 保留原始图片/PDF 和初次导出,在编辑器找到报错行及前后的完整代码块。
- 对照原稿逐项修正缩进、括号、引号和字符;区分合法转义与识别产生的额外符号。
- 如果要更新原任务,在“编辑解析结果”保存并确认版本,再回到阅读器重新导出。
- 用语言工具检查语法,再审阅常量与条件;只对已理解的代码使用小份已知输入核对结果。
已有解析结果应回到原任务编辑。只修改本地下载或独立编辑器内容,不会自动回写原任务。
从语法失败,到源码一致:三份文件可逐步比较
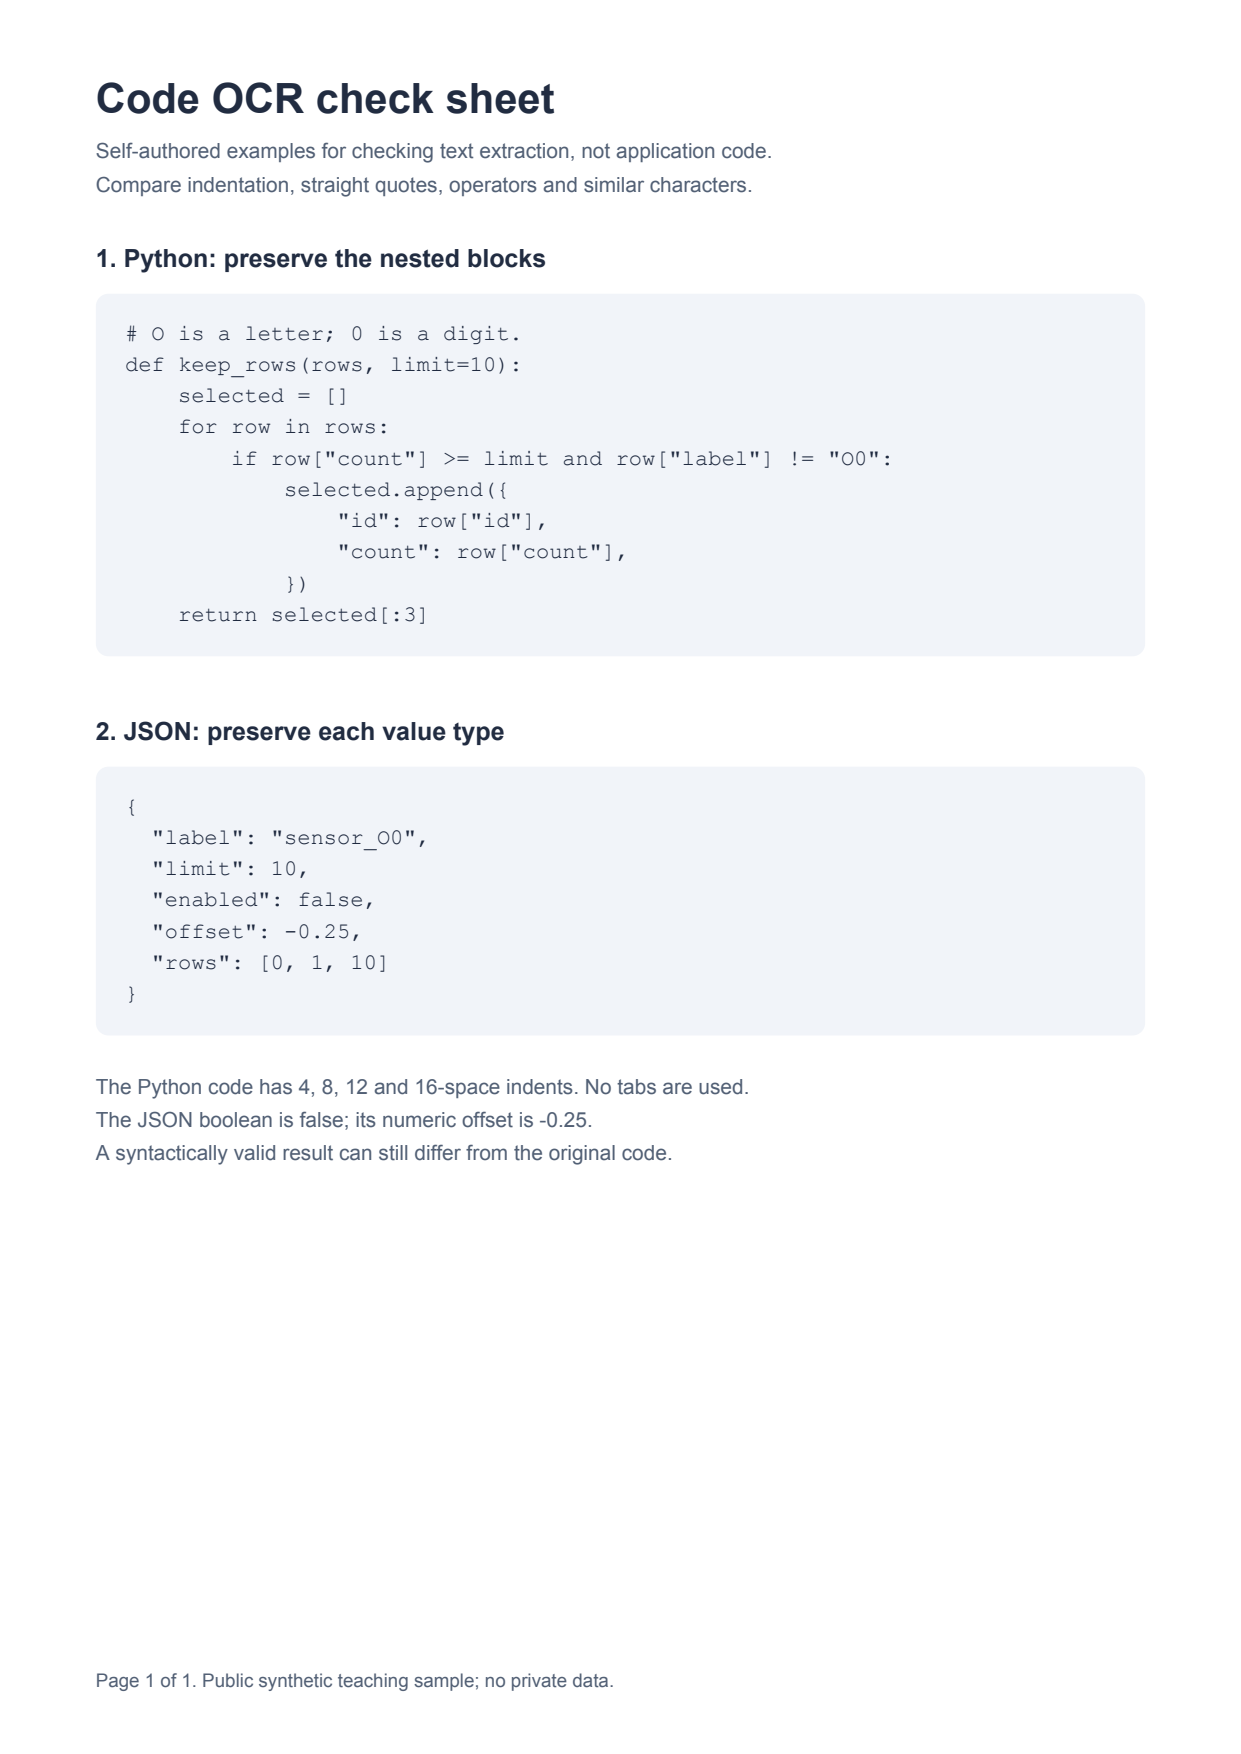
2026年10月11日,将自编的一页原生文字 PDF 与由它渲染的 150 dpi PNG 分别上传解析。文稿含 10 行 Python 和 7 行 JSON。两份初次 Markdown 均保留缩进,但包含字符与转义问题;随后只校对 PDF 任务,保存版本 1、重新加载核对,再下载第三份文件。
| id | count | label |
|---|---|---|
| A | 9 | normal |
| B | 10 | O0 |
| C | 10 | 00 |
| D | 11 | normal |
| E | 12 | normal |
| F | 13 | normal |
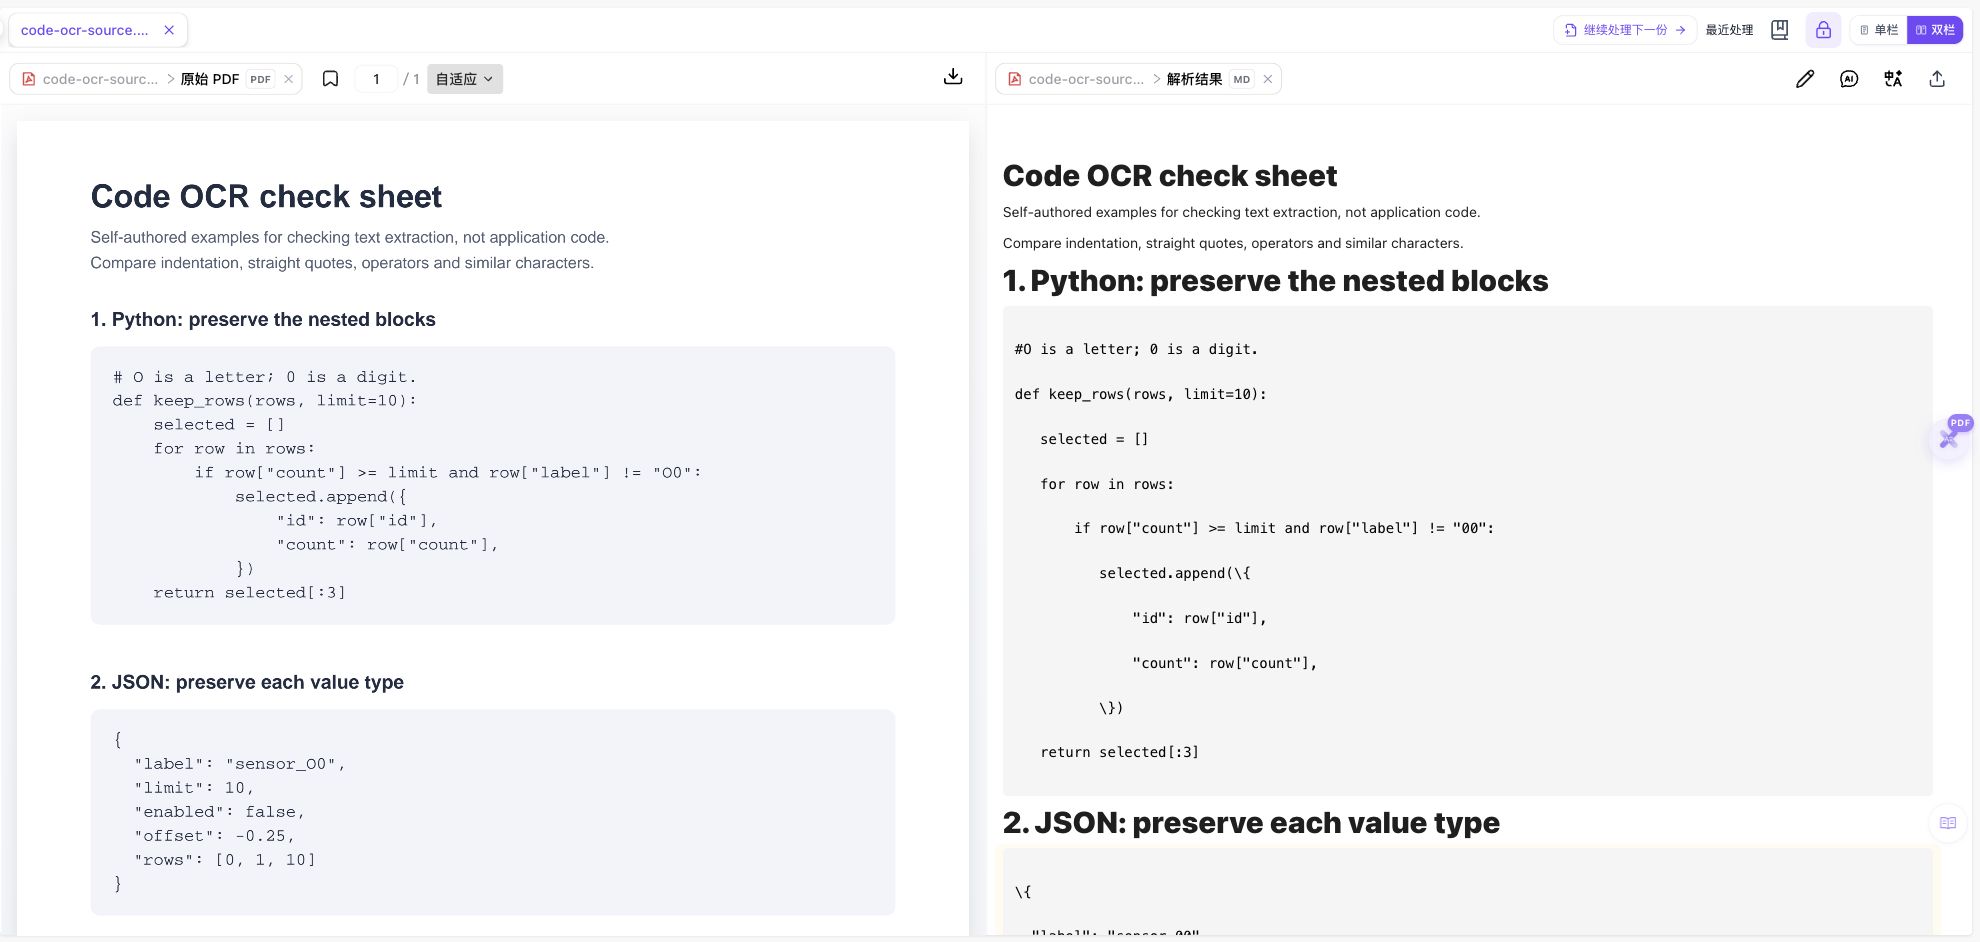
PDF 初次导出的 Python 原样摘录:此处仍有错误
#O is a letter; 0 is a digit.
def keep_rows(rows, limit=10):
    selected = []
    for row in rows:
        if row["count"] >= limit and row["label"] != "00":
            selected.append(\{
                "id": row["id"],
                "count": row["count"],
            \})
    return selected[:3]
- 三份 ZIP 各含一个 Markdown 文件,都有两个未标注语言的代码围栏;Python 10 行、JSON 7 行的缩进宽度保持一致。
- PDF 初次结果在四个大括号前带上反斜杠,且把 O0、sensor_O0 中的字母 O 变成了数字 0。Python 语法检查在第 6 行报错,JSON 从第 1 行起无法解析。
- PNG 初次结果还把 selected = [] 和 JSON 的 rows 数组转成 LaTeX 片段,代码注释中的 O 也变为 0。它的 Markdown 仍有代码围栏,但不能直接作为正确源码使用。
- 在 PDF 原任务中修正四处大括号转义、两处字符串和一处注释空格,保存后重新加载,七个段落的值均保留。再次导出的两个代码块逐字节等于自编参考源码。
- 校对后的 Python 与 JSON 通过本地语法检查。相同自编函数另用六条虚构记录核对;这一小样例不代表任意程序、输入或业务逻辑都正确。
- 本地仅移除多余大括号转义的对照版本虽通过语法检查,却返回 B、D、E;按原稿完整校对后的版本返回 C、D、E。前者是本地构造的对照,不是第四份产品导出。
三份 ZIP 保留真实下载内容,未在下载后改写。PNG 任务仍为未修订的版本 0。完整文稿的页脚未进入 Markdown,精确一致只指校对后的两个代码块。样例是清晰浅底文稿,不含真实 IDE 截图、深色主题、行号、手写或其他语言;没有测试 API 返回。完整核对 ZIP 为本地整理,含原稿、参考源码和三份原生导出。 六条记录的运行对照仅用于这段已审阅的自编纯函数。原始无效 OCR 没有执行;校对结果先确认与自编源码一致,本地对照版本也先核对语法树差异。
先了解这几件事
代码 OCR 后报错,先保留原始导出并找到具体行,再对照原稿核对缩进、括号、引号和转义。修到语法通过之后,还要检查字符串、常量和分支条件。本例只去掉多余反斜杠时,O0 仍被写成 00,六条记录的筛选结果因此不同。
- 原始问题
- PDF 导出的 Python 第 6 行语法报错,JSON 第 1 行无法解析。
- 已验证修订
- 七个段落保存为版本 1,重新加载后再次导出。
- 内容验证
- 校对后的两个代码块与自编源码逐字节一致。
- 边界
- 一个已审阅纯函数、六条虚构记录;不代表任意程序正确。
识别错误片段,逐行核对
原始 Python 下载中的报错行
selected.append(\{这一反斜杠在原稿中不存在,Python 在第 6 行报错。它是本例需修正的特定字符;真实程序中的路径、正则表达式和字符串转义需要各自保留。
去掉转义后,仍要核对字符串
原稿与校对版本:row["label"] != "O0"
初次识别与仅修转义版本:row["label"] != "00"
O0 的第一个字符是英文字母 O。把它写成数字 0 后,条件会选择不同的记录;语法检查无法替你判断原稿希望表达哪个字符串。
图片下载中混入的数学片段
selected \( = \left\lbrack \right\rbrack \)这是 PNG 初次导出的原样一行。原稿为 selected = [];程序源码中的方括号不应在这里被替换成 LaTeX 数学片段。图片任务本次保留原始版本供比较。
语法和内容分开验证,会得到不同结论
| 检查阶段 | 本例观察 | 可以判断什么 |
|---|---|---|
| 直接检查原始 PDF 导出 | Python 第 6 行、JSON 第 1 行报错 | 源代码仍有不合法的转义 |
| 本地只修大括号转义 | 语法通过;Python 返回 B、D、E,JSON 保留 sensor_00 | 语法有效,字符串含义仍与原稿不同 |
| 原任务完整校对并保存后导出 | Python 返回 C、D、E;JSON 为 sensor_O0 | 两个代码块匹配本例参考源码;仍非任意输入的证明 |
先找到真正的错误,不要只盯着缩进
这次两种输入的缩进宽度都保留了,Python 报错来自其他字符:PDF 原始结果第 6 行多出反斜杠,PNG 原始结果第 3 行混入数学定界。以报错行和原稿为起点,再看完整代码块,避免盲目重排所有空格。
只删除报错字符,可能留下不报错的内容错误
本地对照版本仅移除四个大括号前的反斜杠,Python 和 JSON 都可解析,但 O0、sensor_O0 仍变成了带数字 0 的另一个字符串。六行数据对照显示 Python 选中 B 而不是 C;输入值和条件都必须回到原稿核对。
在原任务修订,确认版本后再下载
本次修订七个段落,点击保存修改,看到版本 1 已保存;重新加载编辑器后检查七处文字,再返回文档导出 Markdown。最终文件里的两个代码块与参考源码完全一致,说明这份下载确实包含已保存修改。
完整代码块、语法和小份样例依次检查
先确认代码行没有缺失、混入页码或被拆散,再选择相应语言工具检查语法。审阅内容后,可用已知输入核对一个条件边界和预期输出。这里的六条记录只说明这段纯函数的问题,不能代替真实项目的依赖、测试和业务审查。
遇到合法反斜杠,保留它原本的作用
文件路径、正则、字符串中的转义和语言续行都有各自用途。本例移除的是原稿没有的四个反斜杠,不应把这一处理写成对所有 OCR 代码的全局替换规则。
相关官方说明
遇到这些情况
- 语法检查没有报错,输出却与预期不同
- 检查 O/0、1/l、字符串、数值、运算符与条件。本例只修转义时仍选中错误记录。
- 原任务显示已保存,手里的文件仍有旧字符
- 回到同一任务重新打开导出,下载后查找一个明确修改点;比较文件内容,不能只凭相同文件名判断版本。
- 为了修 OCR,连原本合法的转义也删了
- 恢复原始下载,与原稿逐处比对。保留每次修订副本,按具体语言判断反斜杠含义。
常见问题
OCR 代码报缩进错误,就要重新识别整页吗?
先看实际报错与原稿。本例缩进保留,问题在转义和字符;能够逐项校对时,原任务编辑保存后再导出即可。
语法通过能证明识别正确吗?
不能。本例的本地对照版本语法通过,但 O0 被写成 00,导致选择的记录不同;JSON 字符串也仍与原稿不同。
本页校对版本是手工改过的文件吗?
修改发生在原 PDF 任务的解析编辑器中,保存并重新加载确认后才重新下载。公开 ZIP 保留这次原生导出字节,没有在下载后改写。
PNG 输入的结果也已经修好了吗?
没有。PNG 任务保留版本 0,原始 Markdown 中的字符和数学片段问题仍可下载检查。本次保存修订只作用于 PDF 任务。
内容核对:2026-10-11 · 功能条件与配额以当前产品界面为准