
本页内容
先确认资料,再让每条笔记回到原页
- 打开新建文档对话,上传论文PDF并完成解析,或选择已有解析记录。本例上传原稿24页,范围1~24,未用扫描件增强。
- 核对题名、作者、年份和页数,只选需要的来源,再进入配置任务。本例只选这份论文,模型为Qwen 3.8 Flash。
- 第一问列出要整理的维度,并要求原文出处、保留“可能”和未确认内容。本例问题与原始回答都可下载。
- 先看是否有部分回答或未确认项,再按图号、页段缩小追问。本例第二问只核查Figure 3的数据如何生成、比较什么方法、结论适用到哪里。
- 点击回答中的引用,回到原页查看相邻正文和图注。本例引用定位到第11页,英文摘录与原PDF逐条核对。
- 导出上下文时确认轮次并勾选原文依据。保存MD或Word后重新打开,另行记录作者、DOI和原页;本次下载未自动包含来源页码或原PDF。
本例使用已有登录账户与Qwen 3.8 Flash。模型、AI积分、可用页数和保存条件以当前工作台为准;先用自己的代表论文检查流程。
同一篇论文:追问 Figure 3,再核对原页
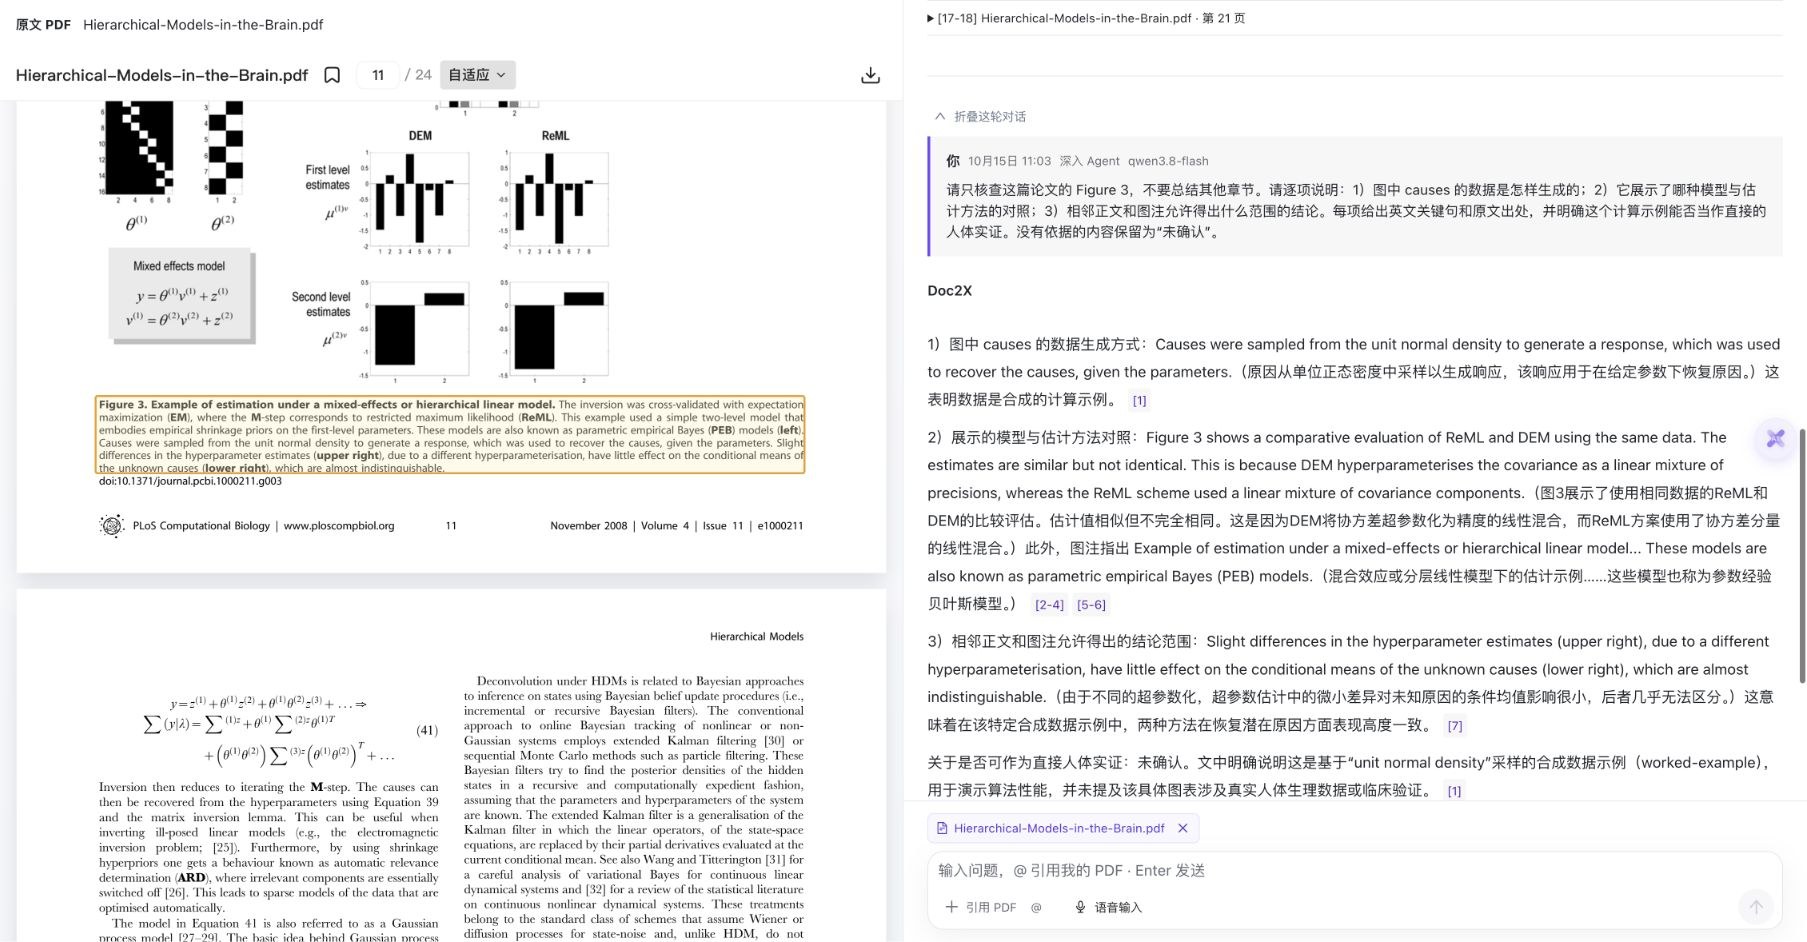
2026年10月15日,实际上传这篇24页开放论文并提出两问。第一问出现部分回答提示;第二问只检查Figure 3。下图左侧来自原PDF第11页,右侧是实际点击追问引用后的工作台,图注范围高亮。
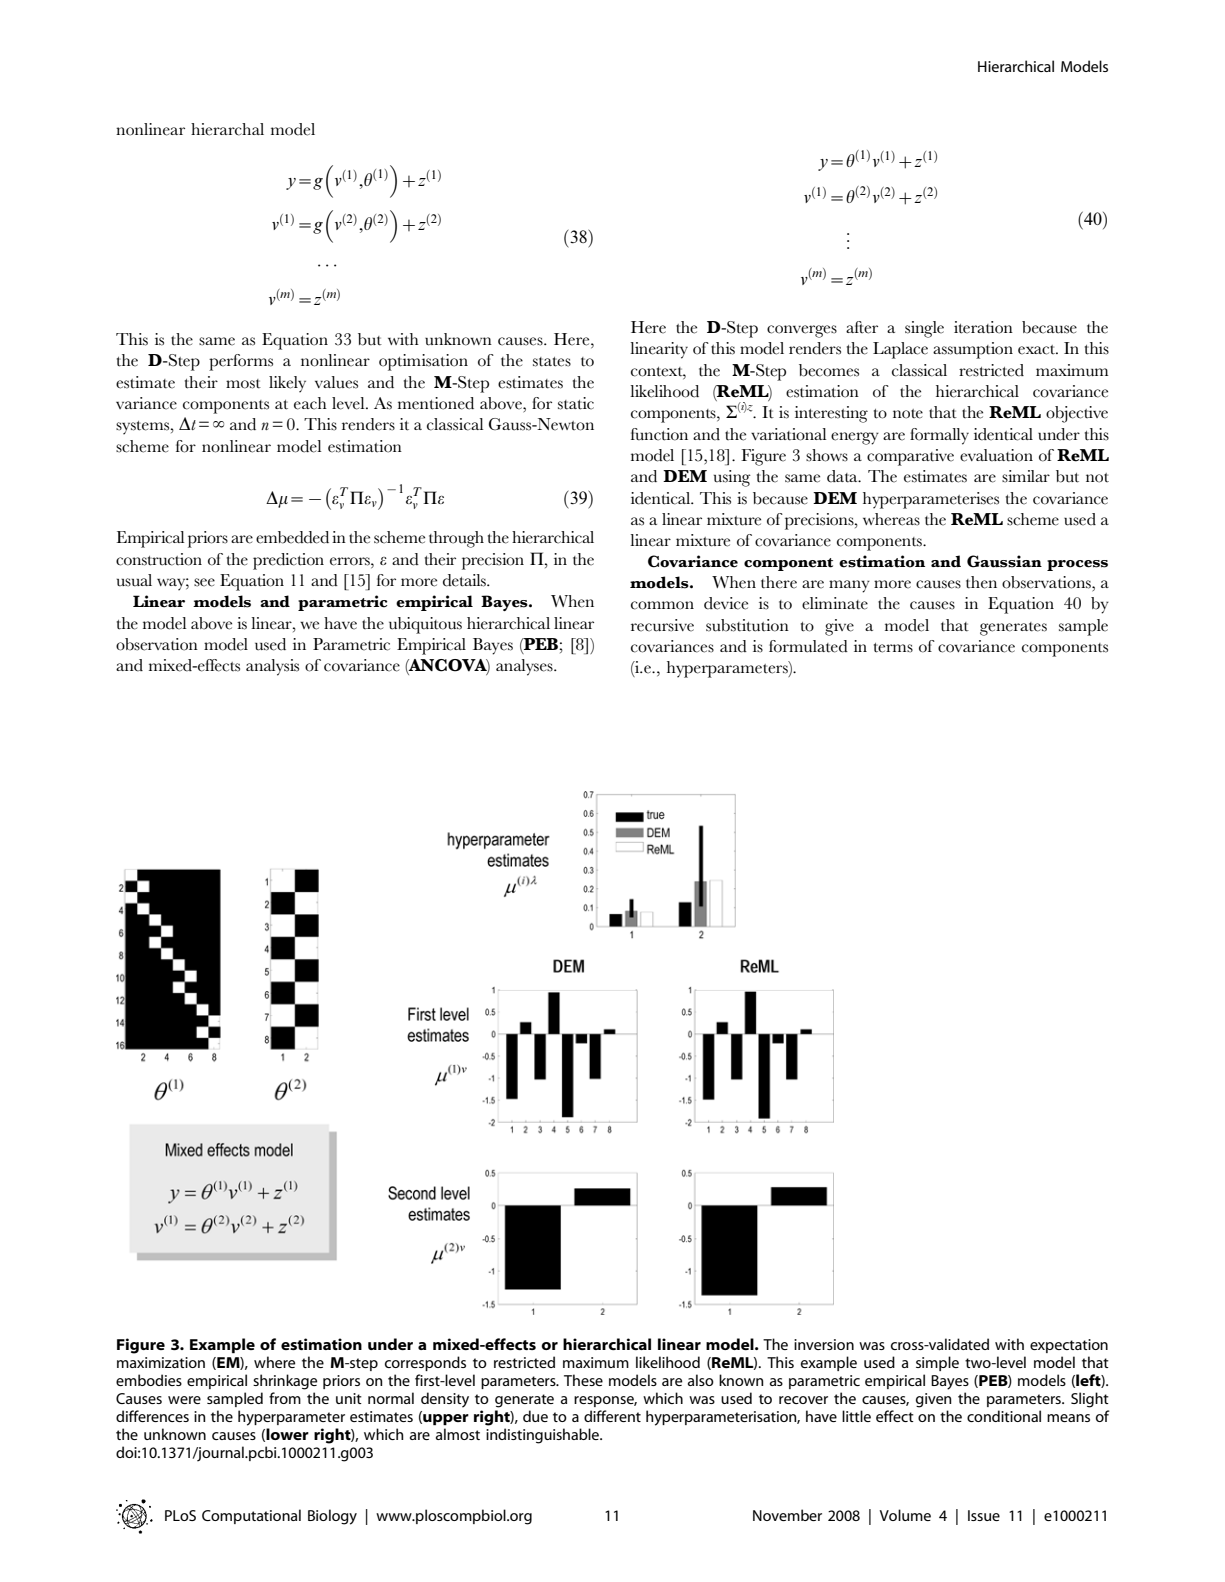
第二问原生Markdown中的一段回答(未改写)
1)图中 causes 的数据生成方式:Causes were sampled from the unit normal density to generate a response, which was used to recover the causes, given the parameters.(原因从单位正态密度中采样以生成响应,该响应用于在给定参数下恢复原因。)这表明数据是合成的计算示例。 [1]- 追问的4组界面引用都指向原PDF第11页,实际单独导出为7条来源摘录。引用组数与条目数分别看。
- 7条英文摘录与原PDF文字逐条核对;两条存在括号内等排版空白差异,未改写原始下载。核对范围是这些摘录,不是全文科学审稿。
- 原图注说明causes从单位正态密度采样生成响应;正文比较同一数据上的ReML与DEM。先核对数据来源,再决定怎样描述这张图。
- 第二问仍对直接人体实证保留未确认,没有把计算示例扩大成真实人体结果。第一问其他未确认页段也没有因此全部补齐。
原文:Karl Friston(2008),Hierarchical Models in the Brain,PLoS Computational Biology 4(11):e1000211,DOI 10.1371/journal.pcbi.1000211。©2008 Karl Friston,原文明确采用Creative Commons Attribution License;本例注明作者与出处,保留完整24页PDF字节。 本例只验证一份英文双栏电子论文的两轮中文问答,使用Qwen 3.8 Flash、深入Agent模式。第一问部分完成,定向追问只补Figure 3,不代表全文已读完或任意论文回答准确。原生成品未改写,CSV页码和ZIP为本地整理。
先了解这几件事
用AI读论文时,先选定原PDF,再围绕研究问题、方法、图表和局限提问,逐项点击引用核对。本例上传完整24页英文论文,第一问只完成部分笔记;接着只追问Figure 3,并回到第11页检查数据生成与方法对照。保留未确认项和原始成品,不能把一段总结当成全文已经读懂。
- 本次输入
- 1份24页英文双栏开放论文;只选该文件,未混入其他资料。
- 第一次提问
- 按五个维度整理,实际出现仅完成部分回答和未确认页段。
- 定向追问
- 只核查Figure 3,4组界面引用、7条导出摘录都对应原第11页。
- 实际保存
- 两份原始MD、一份两轮Word;Word实际打开成功,原文件未改写。
总结之后,先检查还没有核实什么
第一问的提示与未确认页段均原样保留。第二张图在任务刷新后重新查看第一问,仍能看到该段;没有把未确认文字从公开笔记里删掉。
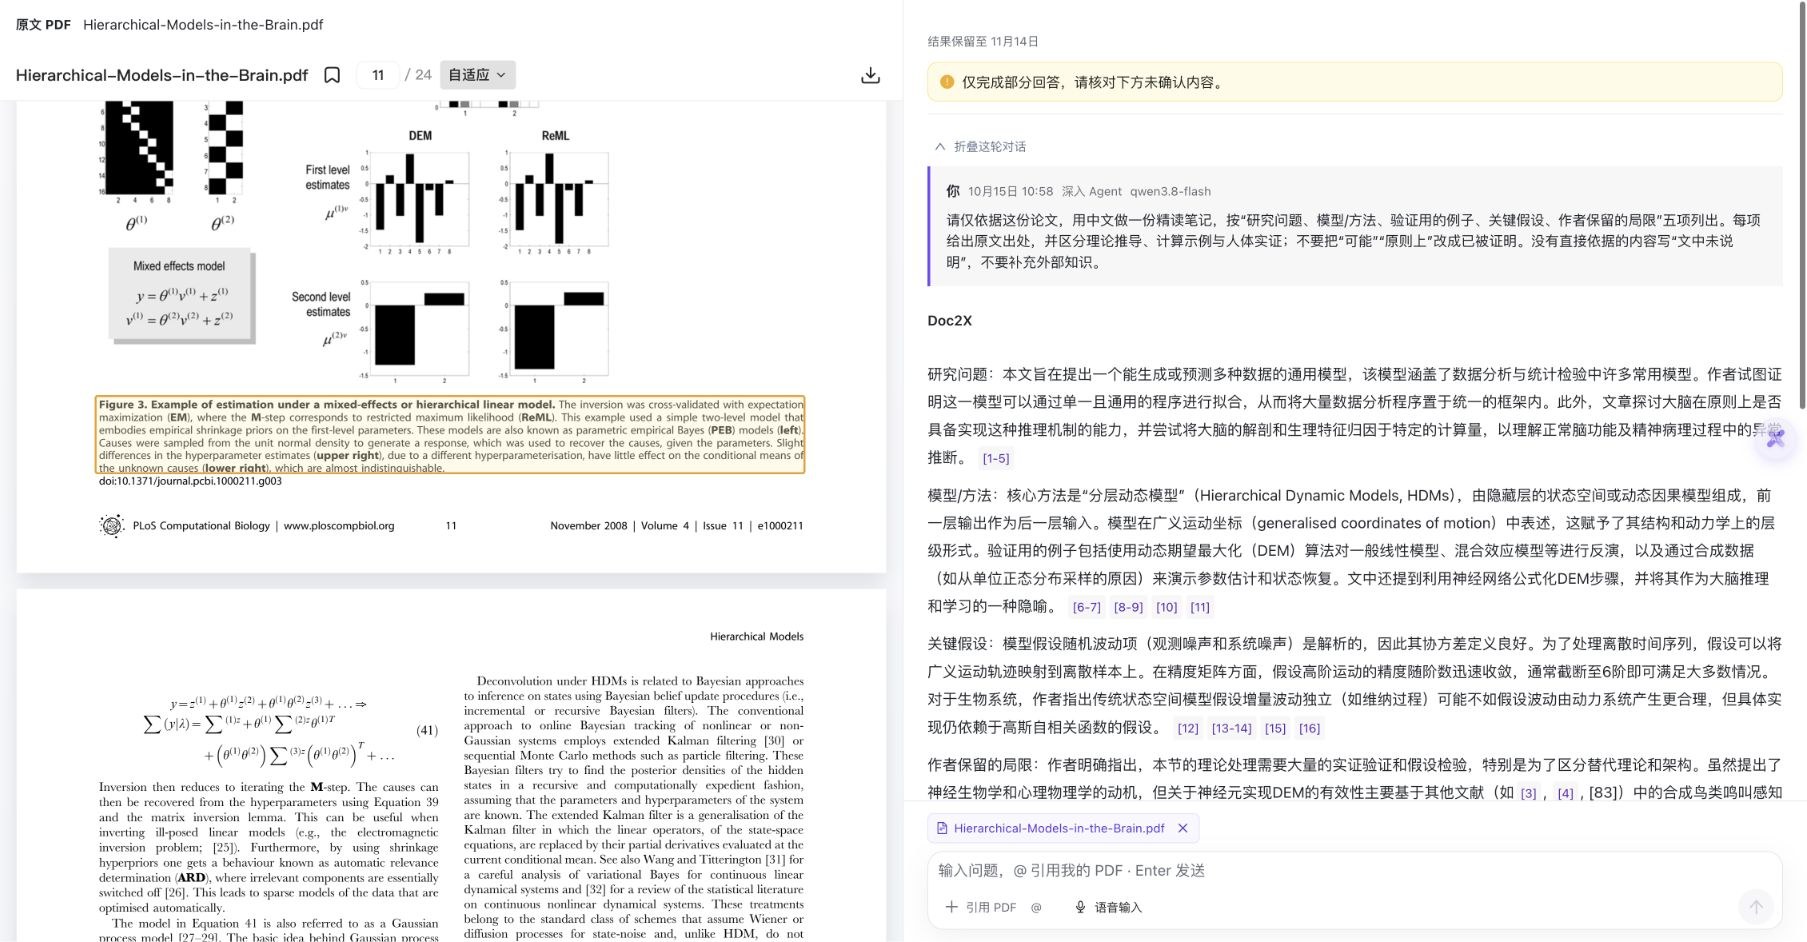
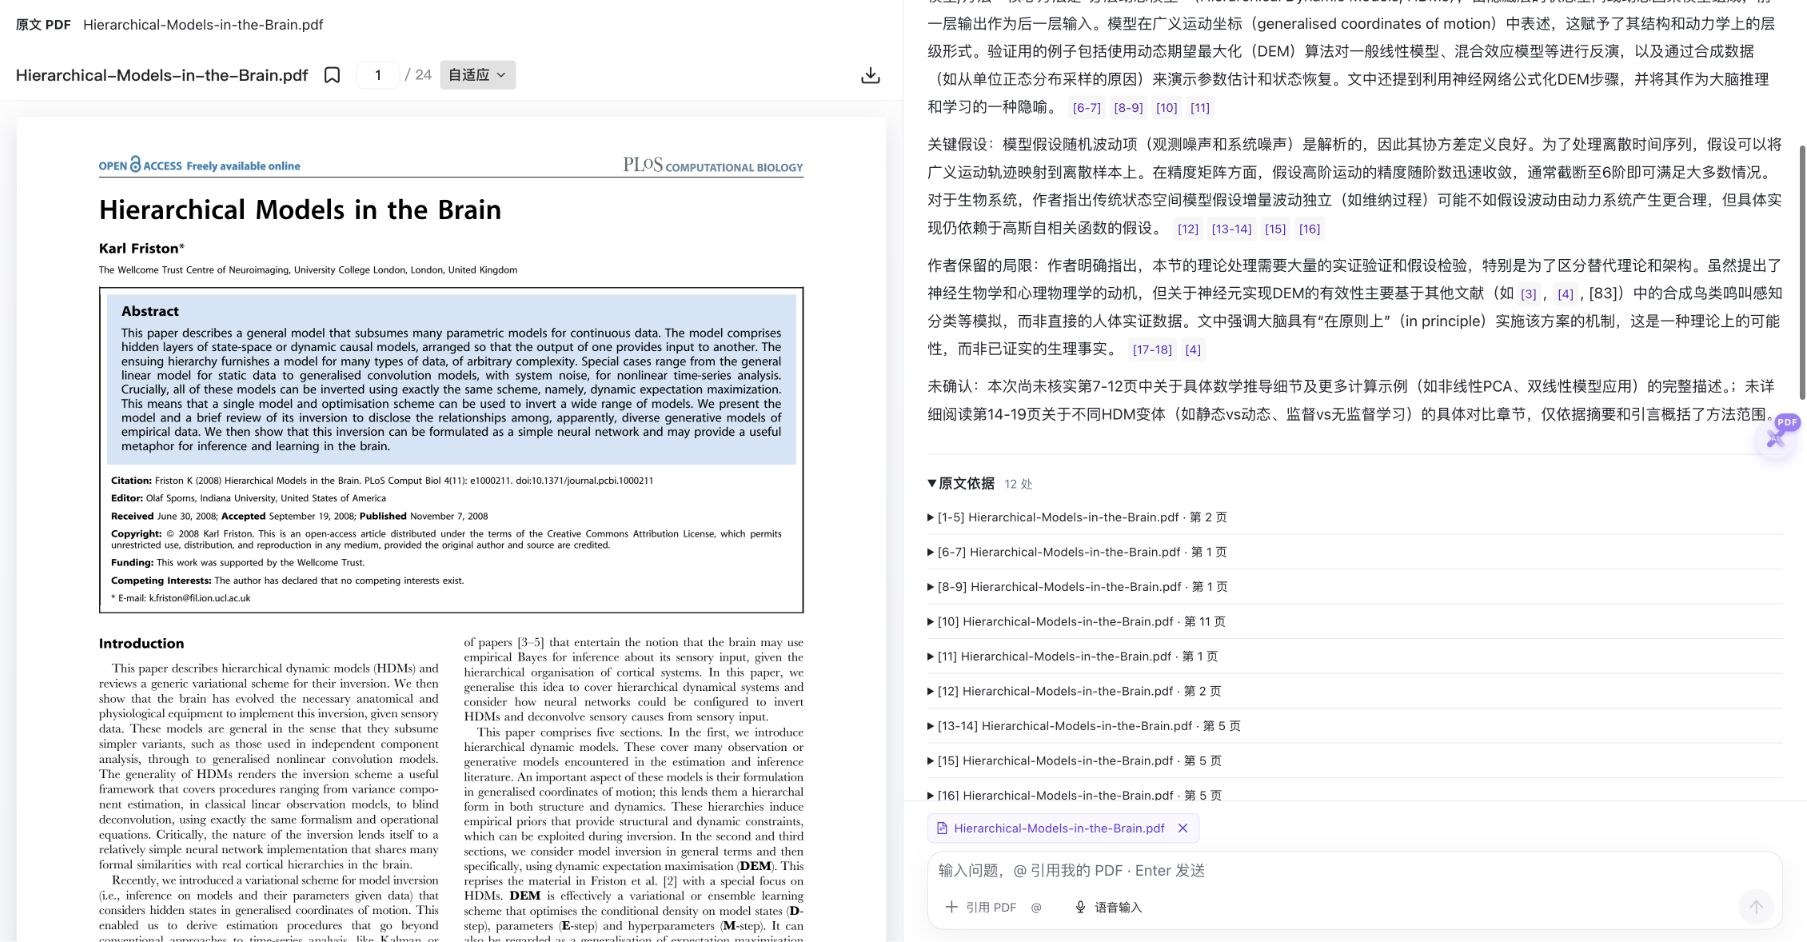
第一问原生文件的未确认文字
未确认:本次尚未核实第7-12页中关于具体数学推导细节及更多计算示例(如非线性PCA、双线性模型应用)的完整描述。;未详细阅读第14-19页关于不同HDM变体(如静态vs动态、监督vs无监督学习)的具体对比章节,仅依据摘要和引言概括了方法范围。原文:Karl Friston(2008),Hierarchical Models in the Brain,PLoS Computational Biology 4(11):e1000211,DOI 10.1371/journal.pcbi.1000211。©2008 Karl Friston,原文明确采用Creative Commons Attribution License;本例注明作者与出处,保留完整24页PDF字节。 本例只验证一份英文双栏电子论文的两轮中文问答,使用Qwen 3.8 Flash、深入Agent模式。第一问部分完成,定向追问只补Figure 3,不代表全文已读完或任意论文回答准确。原生成品未改写,CSV页码和ZIP为本地整理。 本地还发现原第6页的条件独立假设未进入第一问;这里只补核Figure 3,没有把其他章节改写成已确认。
实际操作:24页输入,与两轮导出选择
左图为本次上传后的1~24页解析选项,右图为同一任务导出两轮问题、回答和原文依据的设置。界面中的已选轮次、依据选项和实际文件需分别核对。
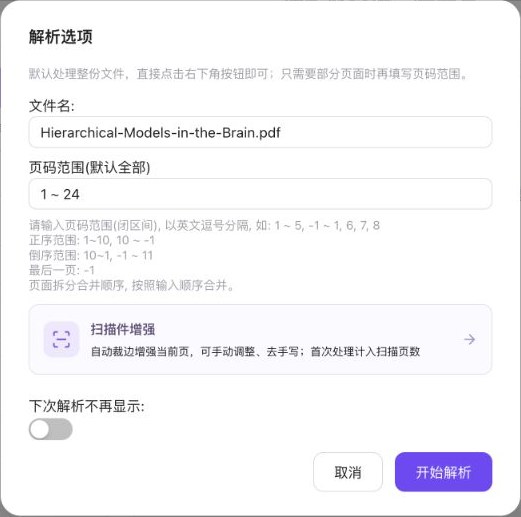
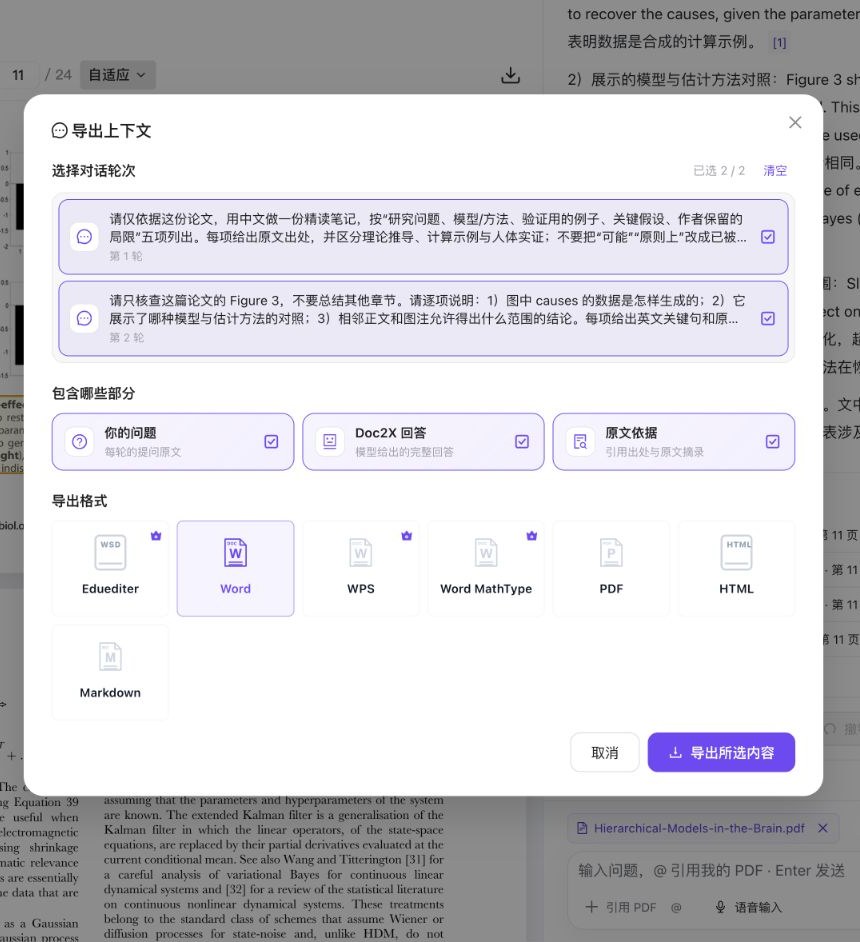
这里没有在本次任务中翻译整篇论文、编辑回答或测试跨账号共享;保存下来的Word包含问答与摘录,原PDF另行保留。
常用语法,逐段对照
实际第一问:按五个维度整理
请仅依据这份论文,用中文做一份精读笔记,按“研究问题、模型/方法、验证用的例子、关键假设、作者保留的局限”五项列出。每项给出原文出处,并区分理论推导、计算示例与人体实证;不要把“可能”“原则上”改成已被证明。没有直接依据的内容写“文中未说明”,不要补充外部知识。这次宽泛问题产生了部分回答,原始结果可下载;不能把这条问题当成任意论文的完整精读保证。
实际追问:只核对一个图号
请只核查这篇论文的 Figure 3,不要总结其他章节。请逐项说明:1)图中 causes 的数据是怎样生成的;2)它展示了哪种模型与估计方法的对照;3)相邻正文和图注允许得出什么范围的结论。每项给出英文关键句和原文出处,并明确这个计算示例能否当作直接的人体实证。没有依据的内容保留为“未确认”。保持来源不变,缩小到Figure 3。本例验证原第11页摘录,其他论文需改成自己的图号和问题。
按论文阅读中卡住的一步继续
| 当前问题 | 本例怎样做 | 还要核对 |
|---|---|---|
| 先了解论文研究什么 | 按问题、方法、例子、假设、局限整理 | 是否部分完成;哪些内容未确认 |
| 想知道一张图依据什么 | 指定Figure 3,要求数据来源与英文关键句 | 原页图注、相邻正文和结论范围 |
| 英文原文读起来困难 | 需要时进入双语阅读或翻译流程 | 本轮是中文问答,没有生成全文译文 |
| 要复用公式或数据 | 另看公式提取、LaTeX或Excel导出 | 源码、编号、单位与实际下载 |
| 准备分享阅读笔记 | 选择轮次并勾选原文依据导出 | 作者、年份、DOI与原页另行记录 |
论文阅读工具先帮你找到问题与证据
本例把原PDF作为唯一来源,要求按相同维度整理中文笔记。先保存题名、作者、年份与DOI,再按自己的研究问题决定阅读顺序;工具输出用于继续核对,不能替代作者原文。
上传全文,与一轮回答覆盖全文分别判断
原稿有24页,第一问却明确说部分页段尚未核实。看未确认内容比只看回答长度更有用;按章节、图表或具体命题继续,不因页面显示任务完成就删掉未确认项。
从图表的数据来源,检查结论的适用范围
Figure 3图注说明数据如何生成,相邻正文解释DEM与ReML的对照。先把这几句找齐,再决定如何概括;本次只核查这个例子,没有把整篇理论或后续研究都验证一遍。
关键假设需要回到方法与讨论逐项检查
本地对照发现原第6页明确写状态与参数、超参数的条件独立假设,第一问没有列出。原第21页又保留大量实证验证与假设检验的需求。笔记已有假设和局限两段,也不代表两者已经完整。
保存笔记,也保留正式引用所需的来源
两轮Word有25条来源标签,附文件名与摘录;没有自动写入来源页码、回源超链接、原生脚注或原PDF。CSV中的第11页由本地对照补记,正式写作还需按要求整理文献条目。
继续双语阅读、公式与文献整理
需要逐段读英文时,可接着用双语阅读或翻译;需要公式时,相关公式页提供同一篇论文摘页的真实Word与TeX。已有Zotero文献库可按插件指南衔接条目;这些流程各自核对,没有在本次中文问答中一并实测。
把 Zotero 全文翻译接入文献阅读
论文保留在自己的文献条目下,按需要取得双语对照笔记或保留排版 PDF。先用一篇短论文检查术语、图表、公式和结果位置,再扩大到同一课题的多篇资料;翻译结果仍需回到原文核对。
相关官方说明
详细操作教程
从PDF或已解析记录选择来源,提问后回原文检查,再导出所需轮次。
设置翻译模式、检查术语与原文,按需要导出阅读或编辑格式。
遇到这些情况
- 回答很长,却提示部分完成
- 保留未确认项,按图号、页段或具体命题继续追问。本例只补Figure 3,不声称全文已完成。
- 关键假设段落看起来齐全
- 回到方法与讨论逐项对照;本例原第6页的条件独立假设没有进入第一问。
- 引用很多,但不知道支持哪句话
- 点开引用读取原页与相邻正文,区分论文内部文献编号与问答任务内的引用编号。
- 下载后缺作者或原页
- 本次成品附文件名和摘录,所需作者、DOI和页码另行记录;原PDF另存。
常见问题
AI读论文怎么开始?
上传PDF或选择已解析资料,核对来源再配置模型。围绕研究问题、方法和局限提问,看到引用后回原页检查;本例提供实际两问和原始成品。
上传24页,就代表AI总结了全部24页吗?
不能这样推断。本例第一问只完成部分回答,列出尚未确认的页段;第二问只补Figure 3的内容。
AI论文精读可以只问某张图吗?
本例可以。第二问指定Figure 3,找到原第11页的7条摘录并实际点击回源。其他图表仍需按自己的问题和原文核对。
中文笔记就是英文论文全文翻译吗?
不是这次结果的含义。本轮生成中文问答,没有翻译全文;逐段对照阅读或保版翻译使用各自流程。
能把这份单篇笔记当作文献综述吗?
本例只使用一篇论文,不能据此代表一个领域的文献范围。比较多篇时,还需分别选择来源、统一比较维度并核对各自条件。
论文笔记能导出Word和Markdown吗?
本次实际得到两份MD和一份两轮DOCX,Word已打开核对。选择轮次并勾选原文依据;所需正式引用字段与原页另记。
内容核对:2026-10-23 · 功能条件与配额以当前产品界面为准