
本页内容
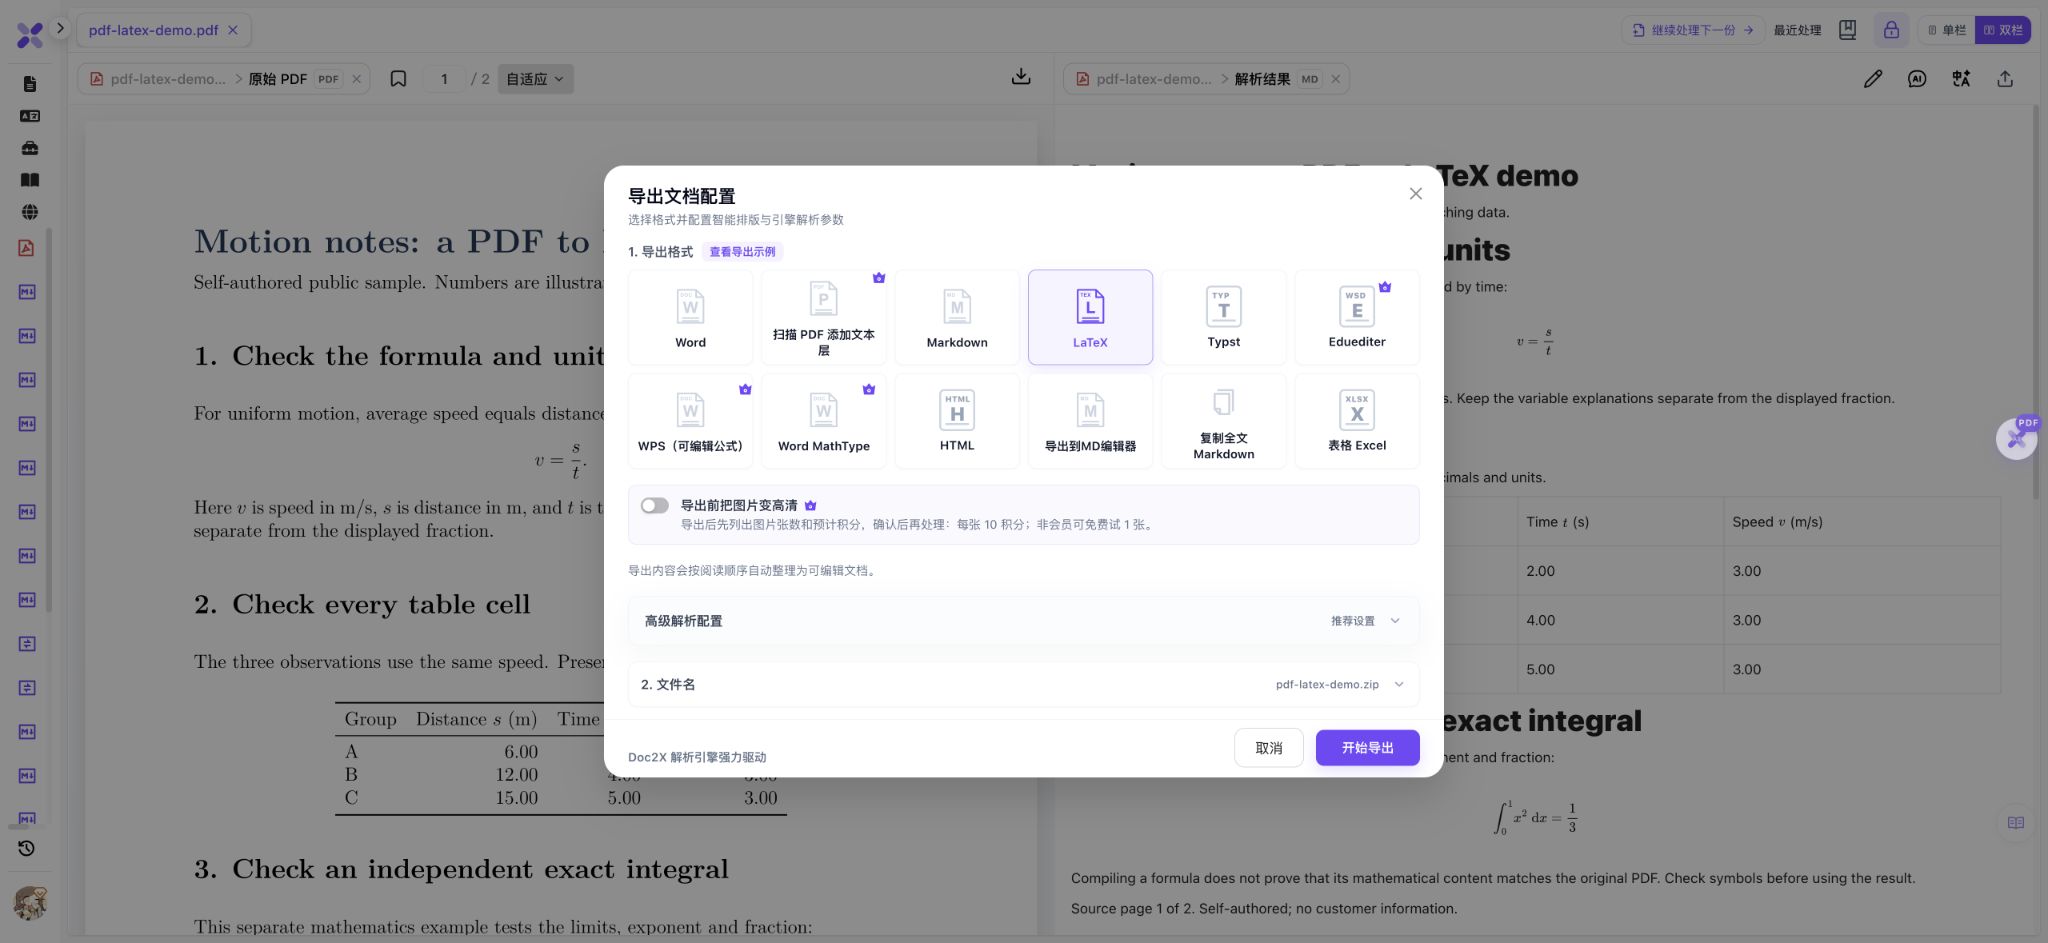
先核对识别内容,再导出完整工程文件
- 打开解析入口,选择 PDF,在解析选项中确认页码范围。本例处理第 1 至第 2 页,没有使用扫描增强。
- 解析完成后,对照原稿检查公式、表格数据、图表标题和阅读顺序。
- 点击导出文档,选择 LaTeX。本例保持图片高清开关关闭,再开始导出 ZIP。
- 完整解压,保留 TeX 与 images 目录。选择适合原包的编译器和字体;本例实际使用 XeLaTeX。
- 生成 PDF 后重新逐页比较:核对数学含义、表格数值、图注与单位,再按需要修改模板或补回缺失内容。
本例实际处理两页。导出、目标工程编译与内容校对是不同步骤;请保留原 PDF。
真实 PDF → TeX ZIP → 本地编译 PDF
2026-10-11 将下面两页自编 PDF 实际上传并完成解析,选择 LaTeX 后下载原始 ZIP。包内只有一份 TeX 与一张 JPG。保留两者原始字节,在本地用 XeLaTeX 编译成功;下面的两幅图分别渲染自输入 PDF 与编译 PDF。
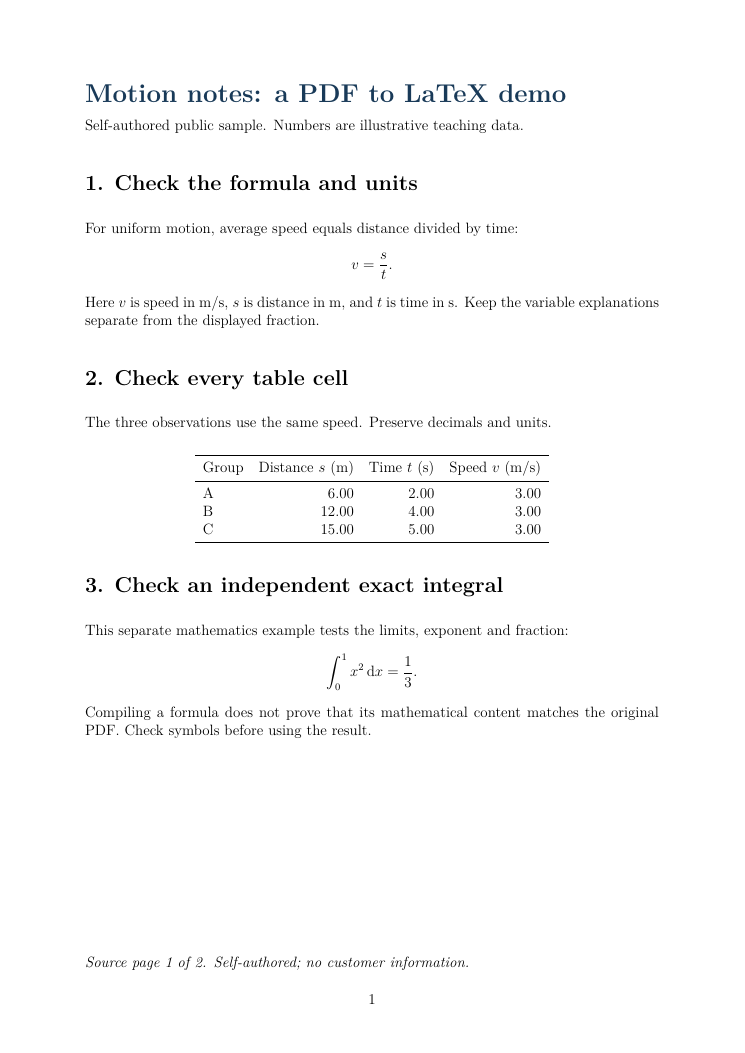
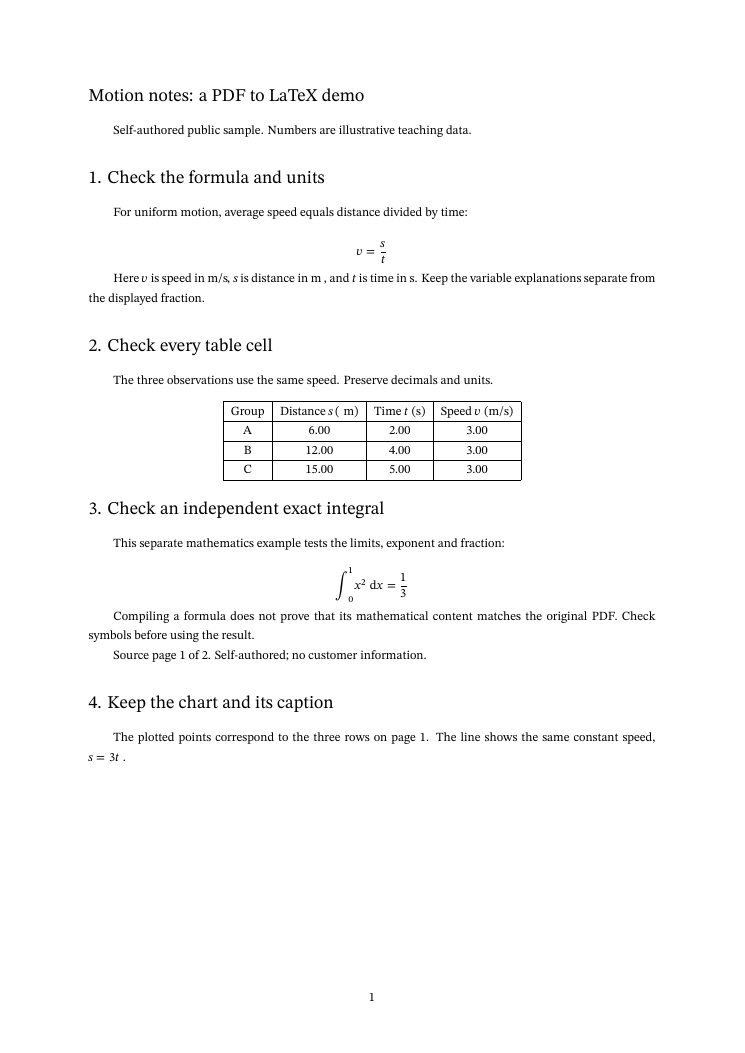
实际 TeX 中的两个显示公式(原文节选)
v = \frac{s}{t}

{\int }_0^1{x}^2\mathrm{\;d}x = \frac{1}{3}- 表格三行分别为 A:6.00 / 2.00 / 3.00,B:12.00 / 4.00 / 3.00,C:15.00 / 5.00 / 3.00。原稿与实际 TeX 可逐格核对。
- 速度分式和定积分的上下限、指数与结果可对照原 PDF 检查。正文中变量与标点的数学定界也应单独核对。
- 编译 PDF 中的图片为 1061×604 像素,其 JPEG 流与原始 ZIP 中的图像字节一致;这张图已由原来的矢量图表变为位图。
- 原 PDF 图表上方的“Distance s (m) | Constant-speed model: s = 3t”没有进入导出的 JPG 或 TeX 正文。三个点的标注和横轴仍可见;纵向距离的单位应回到原 PDF 核对。恢复图片路径只解决文件缺失,不会补回这行识别内容。
这是一份清晰的英文电子 PDF。原始 ZIP、TeX 和 JPG 均未改写,编译 PDF 由本地 XeLaTeX(TeX Live 2023)生成;本轮没有上传或在 Overleaf 云端编译。日志有字体替换和页边注释相关警告,标题字体、表格边框与分页发生变化。扫描件、手写、中文排版、参考文献数据库和原作者自定义宏未由本例验证。
先了解这几件事
PDF 转 LaTeX:上传 PDF,确认页码范围并解析,核对正文、公式和表格后,在导出文档中选择 LaTeX。下载的是包含 TeX 与配套资源的 ZIP。本例一份 TeX 和一张 JPG 在本地用 XeLaTeX 编译成两页 PDF;编译通过后仍发现图表顶部说明缺失,需要继续对照原稿。
- 实际输入
- 两页自编英文电子 PDF,含分式、定积分、三行表格与矢量图表。
- 实际下载
- 一个 ZIP,内含一份 TeX 和一张 JPG;图片高清处理关闭。
- 本地编译
- 未改写原包,用 XeLaTeX 生成两页 PDF;字体与排版有变化。
- 内容边界
- 图表顶部单位说明未被保留;可编译不等于无遗漏或恢复原工程。
LaTeX ZIP 包含什么
本次原生下载有一份 TeX 和 images 目录内的一张 JPG。源码已经包含文档类、宏包、字体与文档环境;它可以作为待核对的工程起点,不是作者原来的模板或绘图代码。
公式、表格与图片分别检查
公式要看数学意义,表格要看行列、数值和单位,图片要看文件是否存在以及内容是否完整。本例两条显示公式和三行表格可核对,但图表上方一行说明缺失,不能用编译成功代替识别内容检查。
先选正确编译器
这份原包使用 fontspec。在本地改用 pdfLaTeX 会立即报错,换回 XeLaTeX 后成功。目标环境还需要相应宏包与字体;本机出现字体替换警告,输出外观与原稿不同。
把源码与图片一起保存
不要把下载 ZIP 直接改名为 .tex,也不要只移动正文源码。图片引用使用相对路径,文件与目录关系需要一起保留;路径问题可查看关联的 LaTeX 图片排查指南。
中文环境自检与本次英文实测分别使用
下方仍保留既有中文 TEX 自检和对应 PDF。那一组由 Pandoc 合成,用于检查中文、公式和表格环境,属于独立辅助样例;它不是本次 PDF 经 Doc2X 识别导出的结果。
英文指南:完整工程、编译器与缺图检查
英文页已按当前入口重新上传同一份自编英文PDF,下载新的LaTeX ZIP,并复核完整包、错误引擎、缺图和恢复四种本地情况。原生TeX与JPG和此前样例字节一致,图表顶部说明仍缺失。页面顶部可切换英文步骤与本轮下载。
科研论文转 TeX,继续核对公式编号顺序
论文公式提取页提供同一真实论文的原生TeX与Word下载。本机编译成功仍观察到(14)排在(13)前、多行公式组拆分;整理写作工程前,可按原论文页码与编号逐组检查。
相关官方说明
遇到这些情况
- fontspec 提示需要 XeTeX 或 LuaTeX
- 检查所选引擎。此原包的实际通过路径是 XeLaTeX;不要删掉所有字体或数学宏包来强行跳过错误。
- 提示图片文件无法载入
- 完整解压 images 目录,并让文件路径与原源码对应。本例补回原 JPG 后恢复编译,无需重新 OCR。
- 能编译但图表信息不全
- 回到原 PDF 核对图表标题、轴单位和图注。本例有一行顶部说明缺失,路径修复不会补回它。
- 输出字体、表格边框或分页不同
- 本例确有这些变化及字体警告。先完成内容核对,再按自己的文档模板调整排版。
常见问题
PDF 转 LaTeX 实际下载的是 TEX 还是 ZIP?
本例下载 ZIP,里面是一份 TeX 与一张 JPG。可以查看单独 TeX,但完整编译需要它引用的图片。
导出的 TeX 可以编译吗?
本页原始 TeX 与 JPG 未改写,在本地 XeLaTeX(TeX Live 2023)生成两页 PDF。仍有字体替换等警告,不保证在任意环境直接通过或保留原排版。
原 PDF 中的图会变成 TikZ 绘图代码吗?
本例矢量图表导出为 JPG,不能继续编辑原来的绘图元素。需要原绘图代码或数据时,应另行保留原始工程。
编译成功是否说明识别内容都正确?
不是。本例图表顶部单位说明仍然缺失;公式、表格和图文内容都要对照原稿。
可以直接恢复原作者的 Overleaf 工程吗?
不能据此保证。作者的模板、宏、自定义标签和参考文献数据库未由本例恢复;导出后仍需按目标工程整理。
内容核对:2026-10-15 · 功能条件与配额以当前产品界面为准