
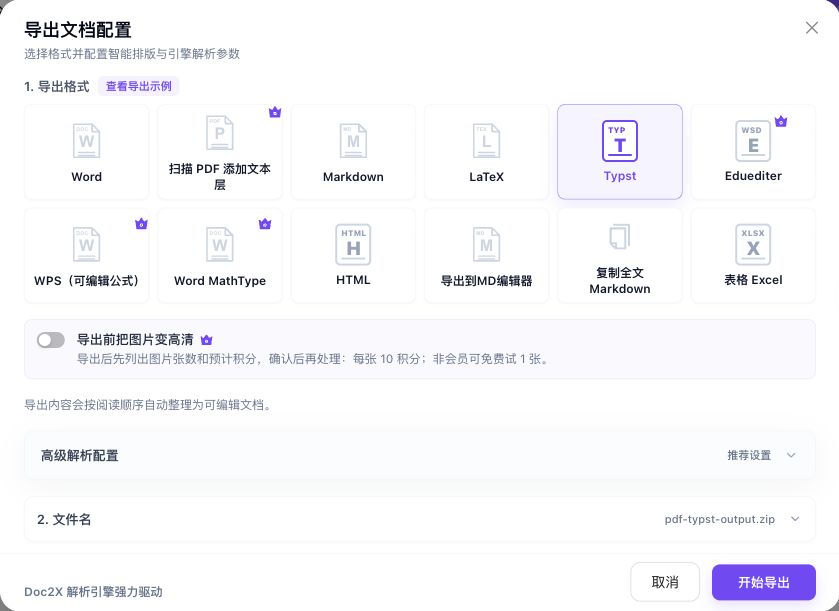
本页内容
核对解析内容,完整导出后再编译
- 上传 PDF 并完成解析,或打开已有结果;对照原页检查正文、公式、表格和图片。
- 打开导出,选择 Typst。本例保留公式、表格按原页保留,并关闭导出前图片高清化。
- 下载并完整解压 ZIP,保留 .typ 与 images 目录的相对位置,再用 Typst 编译。
- 打开编译后的 PDF,逐页核对公式、数据、图注和分页;需要模板或版式调整时再修改自己的副本。
本例原生 ZIP 未改源码即可本地编译;字体、分页与图表说明仍需对照原稿。
一份真实 Typst 项目:原稿与本地编译成品
2026年10月12日,复用此前已完成解析的两页自编英文 PDF,实际导出一次 Typst ZIP。完整解压后用官方 Typst 0.15.1 编译,未改源码,得到两页 A4 PDF。本例保留原稿、原生文件包和本地成品,可逐项检查公式、表格与分页。
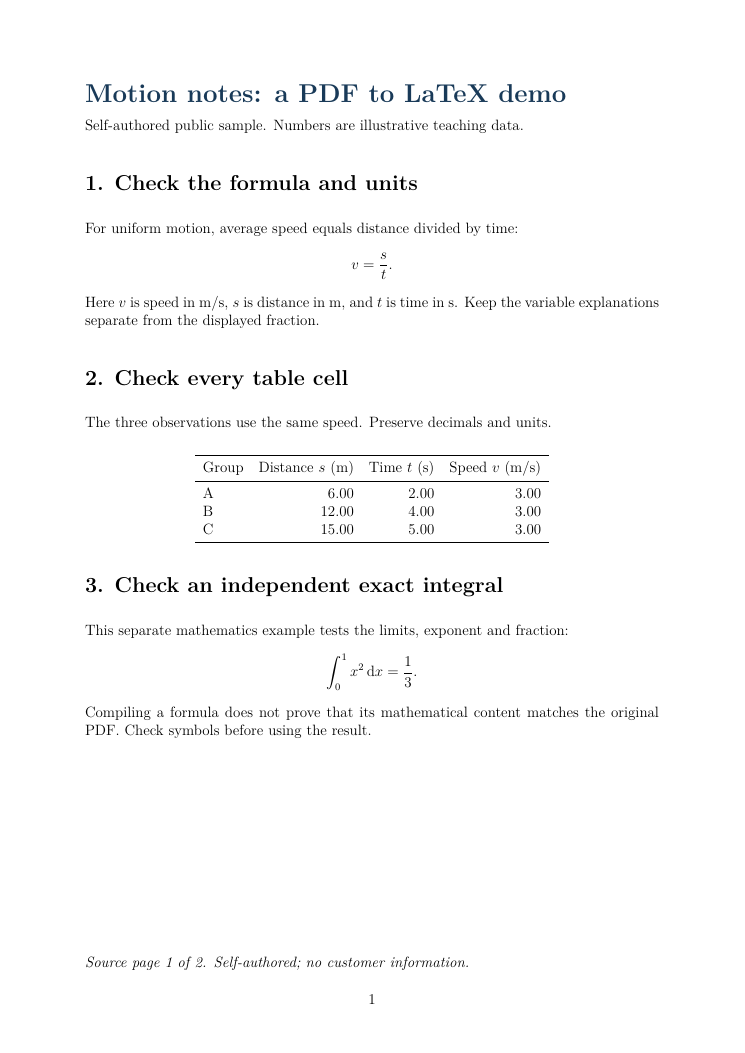
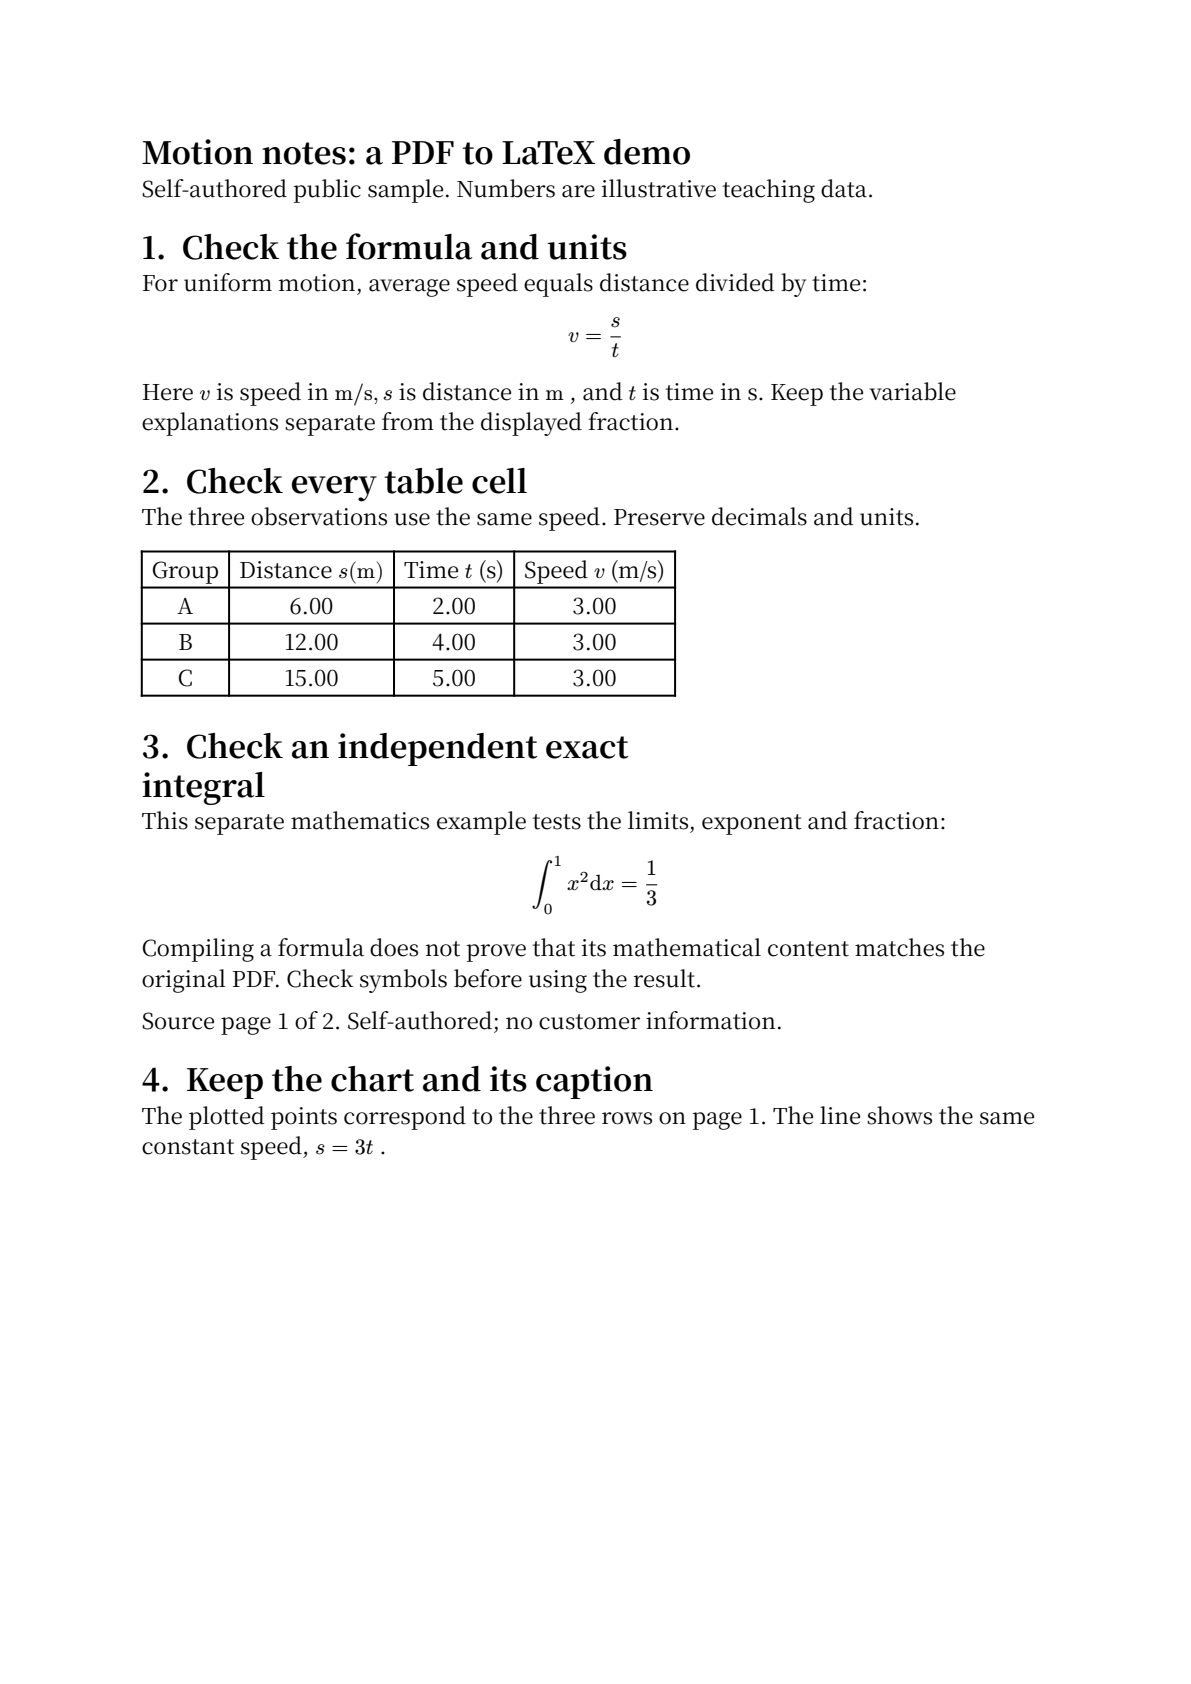
原生导出中的两条公式语句
$ v = s / t $
$ integral_0^1 x^2 upright(#h(0em) d) x = 1 / 3 $- 原生 ZIP 恰含一个 2,460 字节的 .typ 文件与一张 JPEG;图片路径是 images/1_279_471_1061_604_0.jpg。源码没有 import 或 include,本例不需要额外下载 Typst 包。
- 本机能找到源码指定的 Noto Serif CJK SC、STIX Two Text 字体。完整项目在 Typst 0.15.1 下退出码为 0,没有警告;表格 A/B/C 三行的小数与原稿一致,两条展示公式已逐项对照。
- 原稿与成品都是两页 A4,但字体、段落和分页发生变化。第 4 节标题移到成品第 1 页,图仍在第 2 页;六个导出标题统一使用 level: 1,不能当成恢复了原作者的标题层级和模板。
- 图表以 JPEG 保存,编译后内嵌图像的字节与 ZIP 中图片相同。原图顶部“Distance s (m) | Constant-speed model: s = 3t”一行仍然缺失;这是此前解析图片已有的差异,编译成功没有补回它。
这是一份清晰英文原生文字 PDF,原稿标题和文中的 TeX 字样来自此前的转换实验,按原文保留。本轮没有新增上传、OCR、翻译或内容修订。PDF 成品由本地编译器生成,未测试 Typst 云端项目;扫描件、中文缺字、复杂模板和其他版本需另行核对。核对包另含明确标注的本地缺图与字体对照,它们不是更多产品导出。
先了解这几件事
PDF 转 Typst 先提取并核对文档内容,再选择 Typst 导出。解压后将 .typ 与它引用的图片放在对应目录,用 Typst 编译器生成 PDF。本页真实项目未改源码即可编译,但字体、标题层级和分页与原稿不同,图表仍是图片;导出后要继续检查内容和排版。
- 本例输入
- 两页自编英文 PDF,含公式、表格和图表。
- 原生下载
- 一个 .typ 文件与一张 JPEG,组成完整 ZIP。
- 实际编译
- Typst 0.15.1,本地生成两页 A4 PDF。
- 核对边界
- 编译成功、原文完整和恢复原版面分别检查。
导出项目中的不同内容,分别如何验收
| 内容 | 本例导出方式 | 需要核对什么 |
|---|---|---|
| 公式 | Typst 数学语句,分式与定积分可继续编辑 | 分子分母、积分上下限、指数和单位 |
| 表格 | 四列表格源码,三行数据保留小数 | 表头、行列与 A/B/C 对应关系 |
| 图表 | images 目录中的 JPEG | 图片完整性、图注和缺失标签;不能直接改曲线数据 |
| 标题与版面 | 六个 level: 1 标题,重新分页 | 按目标模板调整层级、字体与页边距 |
PDF 转 Typst 得到的是内容项目
这里的流程从 PDF 识别结果生成新的 Typst 源码。它不会找回原作者的宏、模板或可编辑图表。本例仍保留原稿里关于 TeX 的文字说明;文件内容使用 Typst 语法,后缀为 .typ。
公式语句可以编译,也要核对数学含义
本例导出的 v = s / t 呈现为分式,定积分的 0、1 上下限、平方与三分之一也已对照原稿。这样的核对只覆盖这几条简单表达式,复杂矩阵、多行推导和特殊符号仍要抽样验证。
表格是源码,图表仍是一张图片
四列表格以 Typst table 组织,A/B/C 的三行数值保持一致。折线图则是 JPEG,编译器保留了它的像素内容。需要改图中数据时,应回到原始数据或重新绘图,不能把图片引用当作可编辑图表模型。
页数相同,版面也可能不同
原稿和成品都为两页 A4,但第 4 节标题已经移到成品第 1 页,图表留在第 2 页。检查图与说明是否分开,按自己的文档模板调整;仅数页数不能验收排版。
先保留完整文件包,再处理本地编译问题
本例 .typ 在第 54 行引用 images 里的 JPEG。只拿走源码会丢失这条依赖;恢复同一目录后无需修改公式或表格,就能再次编译。字体警告和资源缺失的影响不同,可按下方指南逐步定位。
源码移入子目录后,重新核对图片引用
2026-10-13 用同一份既有下载补做六组本地路径对照。完整项目从其他工作目录调用仍能编译;只把源码移入 src 后,原 images 引用会查找 src/images,即使设置 --root 也不会自动改写它。调整副本引用并指定包含源码与图片的工程目录后,三组成功输出与原有 PDF 字节一致。完整命令与对照包见下方详细教程。
相关官方说明
详细操作教程
保留源码与图片目录,查看真实下载、编译条件和移动文件后的路径检查。
遇到这些情况
- 编译提示 file not found
- 按报错行核对图片引用,确认完整解压了 ZIP,而不是只复制 .typ 文件。
- 出现 unknown font family
- 先看是否仍生成了 PDF,再检查字体与字形。使用 typst fonts 查看可用字体,必要时配置适合文档语言的字体。
- 编译成功,图中说明仍少了一行
- 回到原 PDF、解析结果和 ZIP 图片逐项对照。本例缺失标签在解析图片中已经存在,编译器不会恢复图片之外的文字。
常见问题
PDF 转 Typst 后需要手工修源码才能编译吗?
本页这一份原生 ZIP 在指定本地环境下未改源码即可编译。其他文档的数学语法、字体、图片和模板需要各自验证。
只下载或复制 .typ 文件就够了吗?
看源码是否引用图片等资源。本例需要 images 目录中的一张 JPEG;只带源码会在图片引用处失败。
Typst 导出能保留原 PDF 排版吗?
本例是内容重新排版。虽然仍为两页 A4,字体、标题层级和分页已有变化;需要保留固定外观时,应先明确自己的输出用途。
图表也能像表格一样改数值吗?
本例表格是 Typst table,图表是 JPEG。前者可以修改源码中的单元格,后者不包含可直接编辑的图表数据对象。
网页版支持 Typst,API 也支持同样的格式吗?
本页验证的是网页版导出,没有调用 API。接口格式和条件请查看开放平台当前文档,不能从网页选项推定接口能力。
内容核对:2026-10-13 · 功能条件与配额以当前产品界面为准