
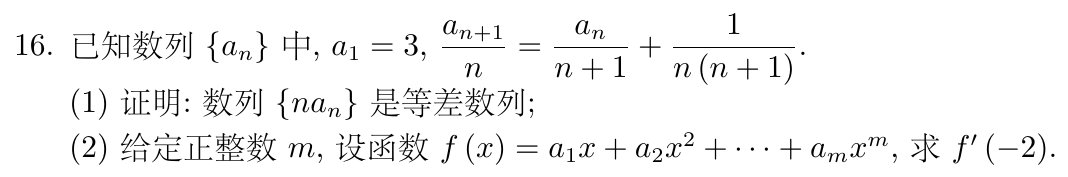
本页内容
提取内容,再检查工程与编译
- 解析 PDF,先核对代表性页面的正文顺序、公式和表格,再导出 LaTeX。
- 查看导出文件与图片资源,判断是否需要放入自己的 LaTeX 文档模板。
- 在 Overleaf 工程中补齐所需文件,核对图片路径、宏包与编译设置。
- 编译并从首个错误定位,生成 PDF 后对照原文检查数学内容、图注和引用。
上传 PDF,核对后导出 LaTeX
不保证恢复原作者模板、宏或参考文献工程;编译通过后仍需核对数学内容。
先了解这几件事
PDF 转 LaTeX 提取内容,不等于恢复作者的原始 Overleaf 工程。导出后先判断文件是公式片段、正文源码还是完整文档,再补齐工程需要的文档结构、宏包、字体与图片路径;编译通过后仍需对照原文核对公式和段落。
- 内容检查
- 正文顺序、公式符号、表格结构与图注。
- 工程检查
- 入口文档、宏包、字体、图片路径与引用。
- 编译检查
- 先处理日志中的第一个实际错误,避免一次改动过多。
- 能力边界
- 提取结果不能保证恢复原作者模板、自定义宏或参考文献工程。
单条公式与完整文档的用法不同
公式片段需要放进目标文档支持的数学环境,不能假定它本身就是完整可编译文件。整篇正文还涉及标题、段落、图片、表格和引用。先打开源码确认结构,再决定怎样接入已有工程。
图片文件必须随工程提供
源码中的图片路径只是引用。上传工程时检查文件是否存在、大小写与目录是否匹配,避免只粘贴正文却遗漏配图。更改文件名后同步修改引用,并对照图注确认没有用错图。
宏包与自定义命令需要工程上下文
编译器不认识某个命令时,先查看该命令用途和模板要求,再判断是缺少宏包、缺少自定义定义还是识别错误。不要删除所有报错命令来换取编译成功,否则可能丢失公式或排版含义。
先解决最前面的有效错误
一个缺失括号或未关闭环境可能引起后续多条日志。保留副本,从第一处实际错误逐步修正,每次少量修改后重新编译。日志路径和行号帮助定位,最终仍以源码与原 PDF 对照为准。
可编译不等于内容正确
缺失负号、交换下标、错列的表格也可能正常编译。逐项检查数学含义与原文阅读顺序,再按自己的模板调整样式。本页配图是已验证的公开公式局部,不冒充完整 PDF 转 TeX 工程测试。
详细操作教程
按目标软件选择文件格式,检查高级选项与下载结果。
遇到这些情况
- 工程找不到图片
- 确认图片随工程上传,检查路径、大小写与实际文件名,不要把图片引用当作图片内容。
- 公式能编译但含义不同
- 回到原图检查分母范围、上下标、负号与括号;编译器不会替你验证数学含义。
常见问题
PDF 转 LaTeX 能恢复原始 Overleaf 项目吗?
不能保证。PDF 记录最终页面,原模板、宏定义、参考文献数据库等可能没有保存在其中。
只有一张公式截图也要走整篇论文流程吗?
不需要。可以使用公式识别获取源码,再按自己的 LaTeX 工程要求放入数学环境。
内容核对:2026-10-09 · 功能条件与配额以当前产品界面为准