
本页内容
先校对原文,再添加文字层
- 保留原稿。新文件从解析入口上传扫描 PDF,核对范围和当前消耗后开始解析;已有任务直接打开结果。
- 对照原页校对正文、数字、公式和表格。需要修改时先保存,再继续导出。
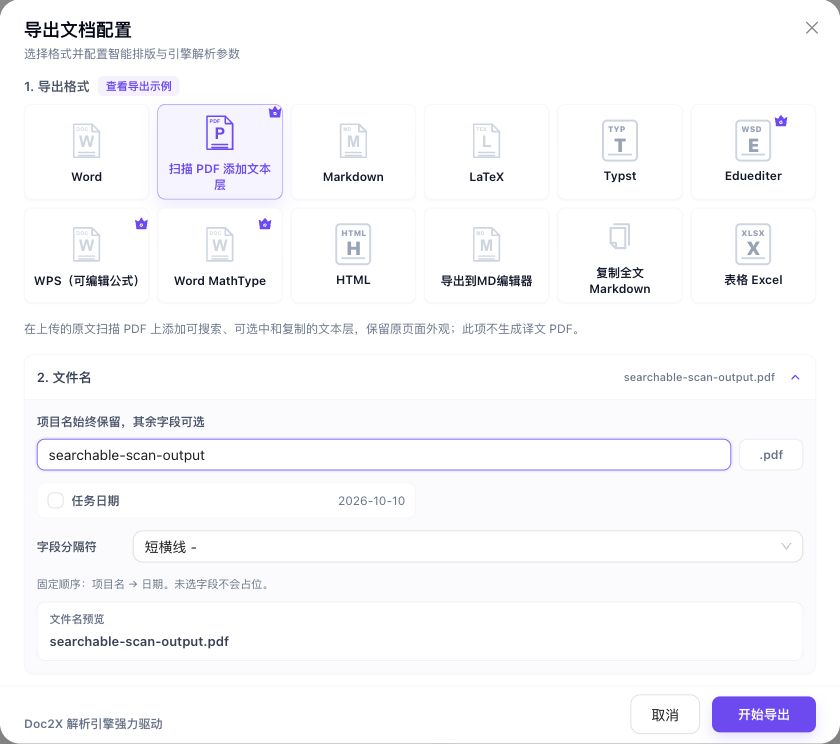
- 打开导出,选择“扫描 PDF 添加文本层”,核对文件名与权益提示,再开始导出。
- 重新打开成品,搜索几个正文词和数字,尝试选择并复制代表段落,对照原页检查字符、位置和顺序。
已有解析结果可直接回到原任务核对后导出。文字层用于检索和选字,表格单元格与复杂阅读顺序仍需单独检查。
同一页 PDF:画面不变,文字层发生了什么
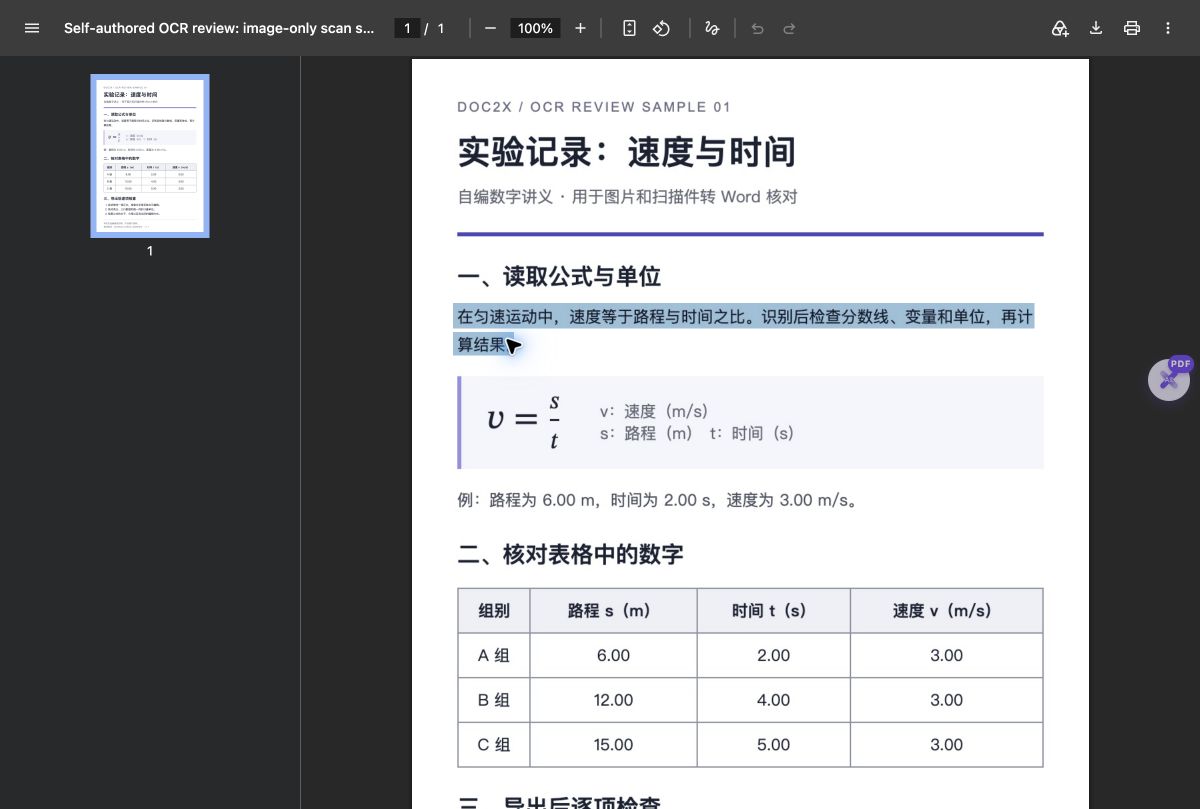
2026年10月11日,复用此前已经解析、校对过的自编讲义任务,选择“扫描 PDF 添加文本层”,实际导出一份 PDF。原稿是一页数字生成的图片型文档,含中文、一个速度公式和一张四行四列表格;本轮没有重新上传、识别或翻译。
独立提取的表头原样片段:它仍带 HTML 标记
<table><tr><td>组别</td><td>路程 s (m)</td><td>时间 t (s)</td><td>速度 v (m/s)</td></tr>- 原稿和成品均为 1 页、508×720 点,原稿没有可提取文字。成品用 pypdf 提取到 611 个字符、PDFium 提取到 640 个字符;两者空白和顺序不同,字符数不是识别准确率。
- 原页内嵌 JPEG 的字节保持一致;用 PDFium 按 2 倍尺寸渲染两份 PDF,1016×1440 像素逐点一致。这是本例的文件和渲染核对,不是任意扫描件的无损保证。
- PDFium 文件级搜索:原稿中“匀速”“速度”“12.00”均无结果,成品分别找到 1、5、1 处。该结果来自独立文件检查,没有当作浏览器原生查找栏的实测。
- 浏览器中实际选中了一段正文,截图保留原始蓝色选区。本轮未验证系统剪贴板粘贴;上面的文本来自独立提取,不能当作复制粘贴结果。
- 公式提取为 v = (s)/(t),表格提取为包含表头和三行数据的 HTML 片段。能找到数字,不等于拥有可编辑单元格或准确的逐格选区;请按后续用途选择输出。
输出保留实际下载字节,并包含此前已保存的 s、t 变量说明。文件搜索与提取由独立工具核对;未完成原生查找栏和系统剪贴板粘贴验证。本例是清晰单栏数字讲义,未验证拍照、手写、多栏、旋转、加密文件、书签或签名。原稿与成品的画面相同,完整页面预览因此只提供一张。核对 ZIP 为本地整理;另附的 Word 是同一原稿此前的真实导出,本轮没有再导出 Word。
先了解这几件事
把图片型 PDF 变成可搜索 PDF,先完成 OCR 并校对识别内容,再在导出中选择“扫描 PDF 添加文本层”。成品保留原页图像,搜索与选字依赖新增的文字层。下载后分别检查关键词、文字内容和位置;需要改写正文或表格时,再选择 Word、Excel 等适合的格式。
- 实际输入
- 1 页自编图片型 PDF;本轮复用此前已校对任务。
- 实际输出
- 原文 PDF 添加文字层,原页内嵌图像字节保持一致。
- 可核对证据
- 成品文件、导出配置、真实选字截图与独立提取文本。
- 使用条件
- 来源与任务符合导出条件,并通过当前界面权益检查。
搜索到了内容,还要分别验收什么
| 核对项目 | 本例结果 | 说明与后续动作 |
|---|---|---|
| 原页外观 | 2 倍 PDFium 渲染逐像素一致 | 仍检查自己的页面、公式、边框和小字 |
| 正文文字层 | 文件搜索“匀速”1 处;浏览器中选中一段正文 | 再用自己的阅读器检查复制后的文字 |
| 表格内容 | 文字层含 HTML 表格片段 | 需要单元格时选择表格 Excel 或合适的 Word 输出 |
| 文件体积 | 249,552 → 260,521 字节 | 本例增加 10,969 字节,添加文字层不是压缩 |
可搜索 PDF、文字层与双层 PDF
这里的“双层 PDF”指保留可见扫描图像,并叠加可检索文字的文档。原页仍按图像显示,文字层服务于搜索、选取与提取;不是两页并排,也不是自动生成的双语翻译。
为什么外观看起来一样,却可以检索文字
本例原稿只有一张页面图像,独立提取不到文字;成品保留原图,同时加入不可见文字。两份 PDF 视觉渲染一致,新增的文字对象让文件级搜索找到“匀速”等词。看到画面不变,不能据此判断没有新增文字层。
原文文字层和译文 PDF 使用不同出口
导出弹窗的“扫描 PDF 添加文本层”用于原文,不生成译文。需要译文在左、原文在左或仅译文的 PDF,应使用对应翻译任务的导出选项;“编辑后生成 PDF”也不是这一保留原页流程。
公式和表格:能提取,不代表可以直接编辑
这页的分式外观仍是原图,提取文字则是 v = (s)/(t)。表格文字含 HTML 标记,且独立检索中某个数字的定位区域跨过表格高度。不要用找到一个数字替代逐格核对;需要原生表格或公式对象时,检查相应 Word 或 Excel 成品。
校对结果之后,再检查搜索位置和复制顺序
文字识别内容正确与文字位置准确,是两项检查。对正文、表格和页脚分别抽样,并留意选择区域是否对应可见文字。本例两个提取器给出的顺序不同,没有验证多栏文稿或所有阅读器的复制顺序。
相关官方说明
详细操作教程
区分文本层与重新排版 PDF,导出后验证搜索和复制。
遇到这些情况
- 能看见字,却搜不到关键词
- 先确认打开的是导出成品而非原扫描件;再查看该词是否识别正确、是否存在文字层。
- 能搜到表格数字,选区却不贴合单元格
- 检查文字层定位,别把搜索命中当成逐格复制保证。需要整理表格时,选择并核对表格导出。
- 导出选项没有显示或提示权益不足
- 检查当前任务来源与支持的导出格式,以界面条件为准。文件后缀是 PDF 不代表任何任务都具备相同选项。
- 想把 PDF 中的段落直接改写
- 可搜索文字层主要服务检索。需要重新排版或编辑内容时,改用已核对的 Word、Markdown 等输出。
常见问题
扫描 PDF 添加文字层后,原来画面会变吗?
本例保留了原 JPEG 的字节,2 倍 PDFium 渲染也完全一致。不同文档仍需检查;这个结果不构成所有页面或阅读器的保证。
双层 PDF 就是双语 PDF 吗?
这里的双层是可见扫描图像与文字层,不是两种语言。此导出处理原文;译文或原文译文对照使用翻译导出。
可搜索 PDF 能直接变成可编辑表格吗?
文字层不等于 Word 或 Excel 单元格。本例可检索到表格数字,但提取结果含 HTML 标记;按所需编辑方式选择输出并核对。
添加文字层能让 PDF 变小吗?
它的目标是增加检索文字。本例从 249,552 增至 260,521 字节。需要减小体积时另做压缩,并保留原稿、检查文字层和清晰度。
这里是否验证了实际复制粘贴?
本轮确认了浏览器中的文字选区和文件级搜索、文字提取,没有完成系统剪贴板粘贴验证。公开 TXT 来自独立提取,不冒充粘贴结果。
内容核对:2026-10-11 · 功能条件与配额以当前产品界面为准