
本页内容
怎么合并 MD 文件?
- 选择多份 .md 文件,保留原稿与图片目录;当前入口支持最多 20 个文件,本例只使用两份。
- 确认队列顺序,再检查分隔符、标题级别、目录和引用设置。含代码或公式时先保留标题级别。
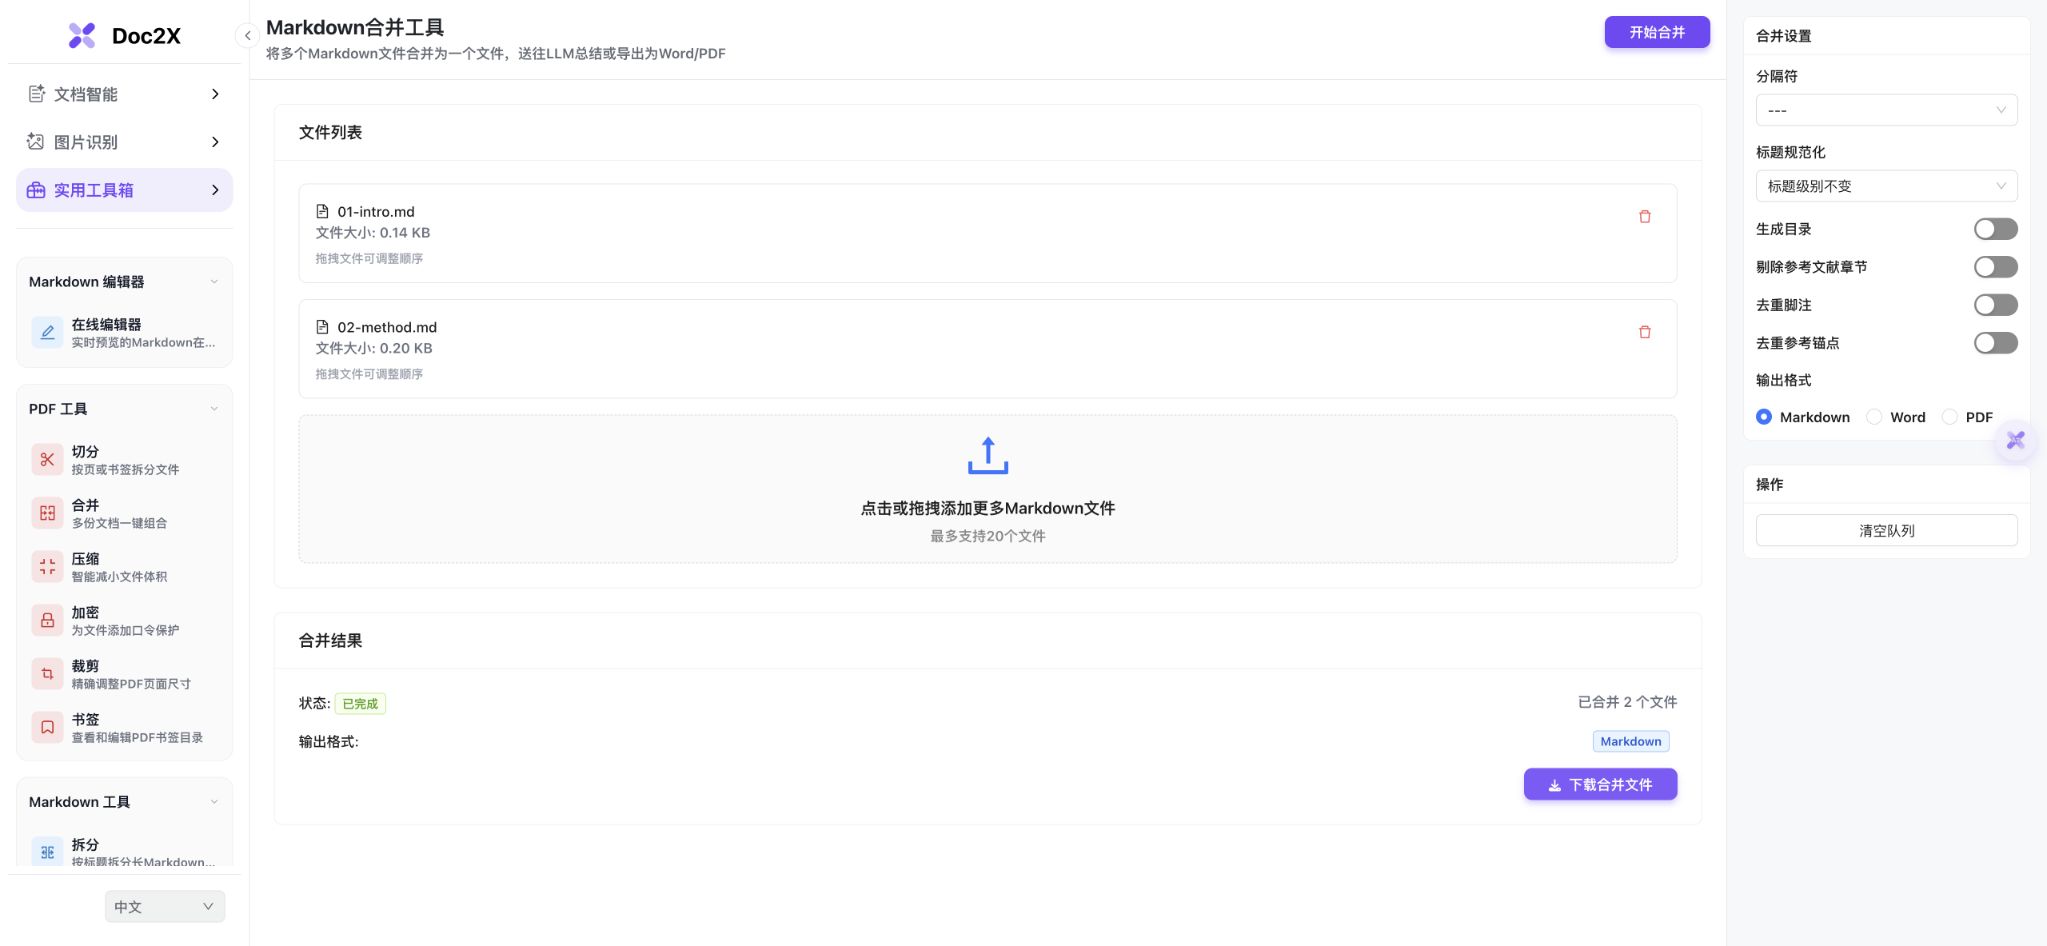
- 选择 Markdown 输出,点击开始合并;看到已完成后,再点击下载合并文件。
- 在目标阅读器核对章节、目录、脚注与图片内容;需要 Word 时再进入已有合并转 Word 指南。
先保留原稿与图片目录,确认文件顺序,再开始合并并点击下载;需要 Word 时使用后续导出指南。
两份自编讲义,下载实际合并结果
2026 年 10 月 9 日,将面积课和运动课两份自编 Markdown 上传到已上线的合并工具。使用默认分隔符、目录和脚注去重设置,下载未经改写的合并 MD;可连同两份输入一起核对。
实际下载文件中的目录与脚注(节选)
## 目录

- [面积课笔记](#面积课笔记)
  - [本课目标](#本课目标)
  - [数据与公式](#数据与公式)
- [运动课笔记](#运动课笔记)
  - [本课目标](#本课目标-1)
  - [数据与公式](#数据与公式-1)


[^area]: 本段为手工编写的工具测试材料,不是识别或翻译输出。- 两课都包含“本课目标”和“数据与公式”,第二组目录锚点带 -1,中文目标不是空的 #。
- 两份输入的脚注内容相同,合并后保留一个定义,正文引用均对应这条定义。
- 表格数据、公式源码与文件顺序可以直接对照输入;最后仍需在自己的 Markdown 渲染器检查。
这是手工编写输入的真实工具输出,不是 OCR 或翻译结果。本例没有图片资源、嵌套脚注或复杂 HTML;它不能代表这些内容已完成验证。不同内容的同名脚注另由自动化回归测试检查。
先了解这几件事
打开 Markdown 合并工具,选择多份 .md 文件并确认顺序,按需要设置分隔符、标题和目录。选择 Markdown 输出,点击“开始合并”,看到已完成后再点“下载合并文件”。图片需另行保存;不同原稿有同名图片时,先分目录并同步修改相对路径,避免缺图或串图。
- 连接方式
- 分隔线、文件名或不加分隔符;以工具当前选项为准。
- 结构设置
- 可调整标题级别、生成目录,并按需要选择脚注与引用处理。
- 处理范围
- 合并 MD 正文,不等于打包整套笔记库的图片、插件和配置。
- 继续导出 Word
- 在合并工具中选择 Markdown 输出,再到在线编辑器继续处理;Word 由服务端转换,需要登录,权益与额度条件以当前界面为准。
合并时剔除参考文献:附录留下,正文引用仍需核对
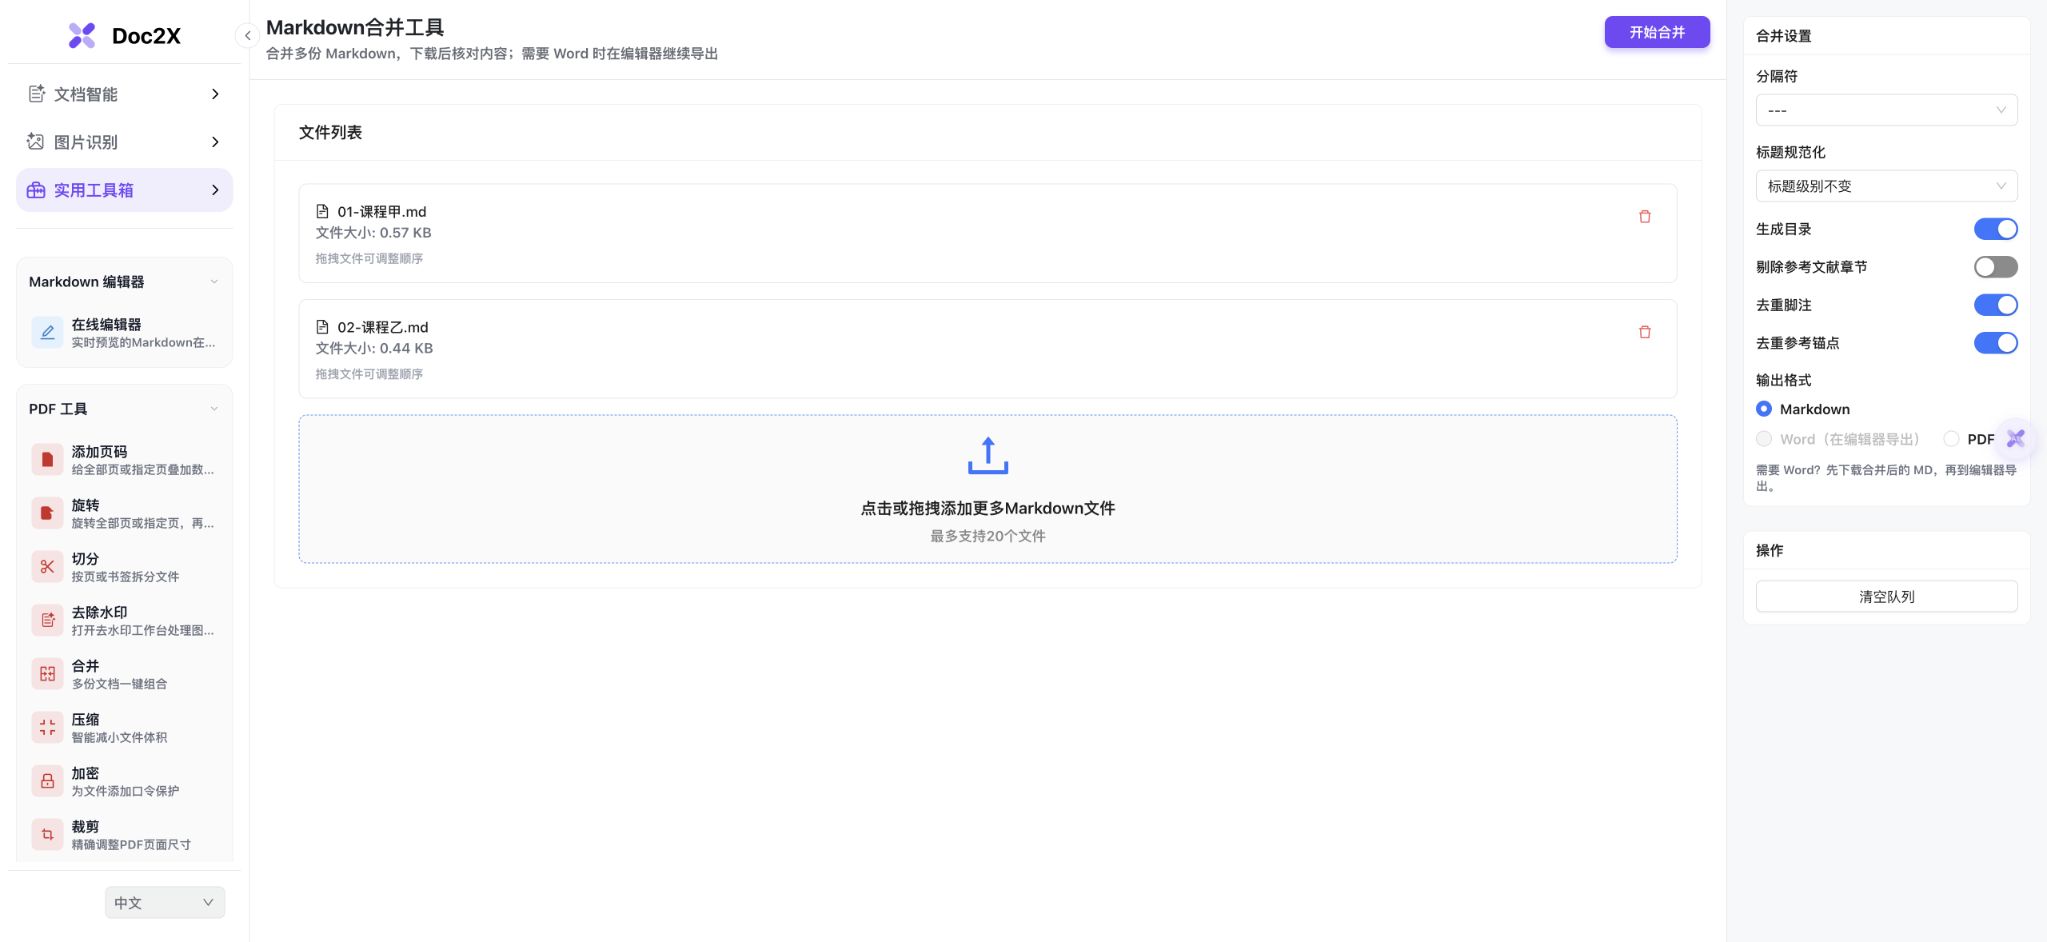
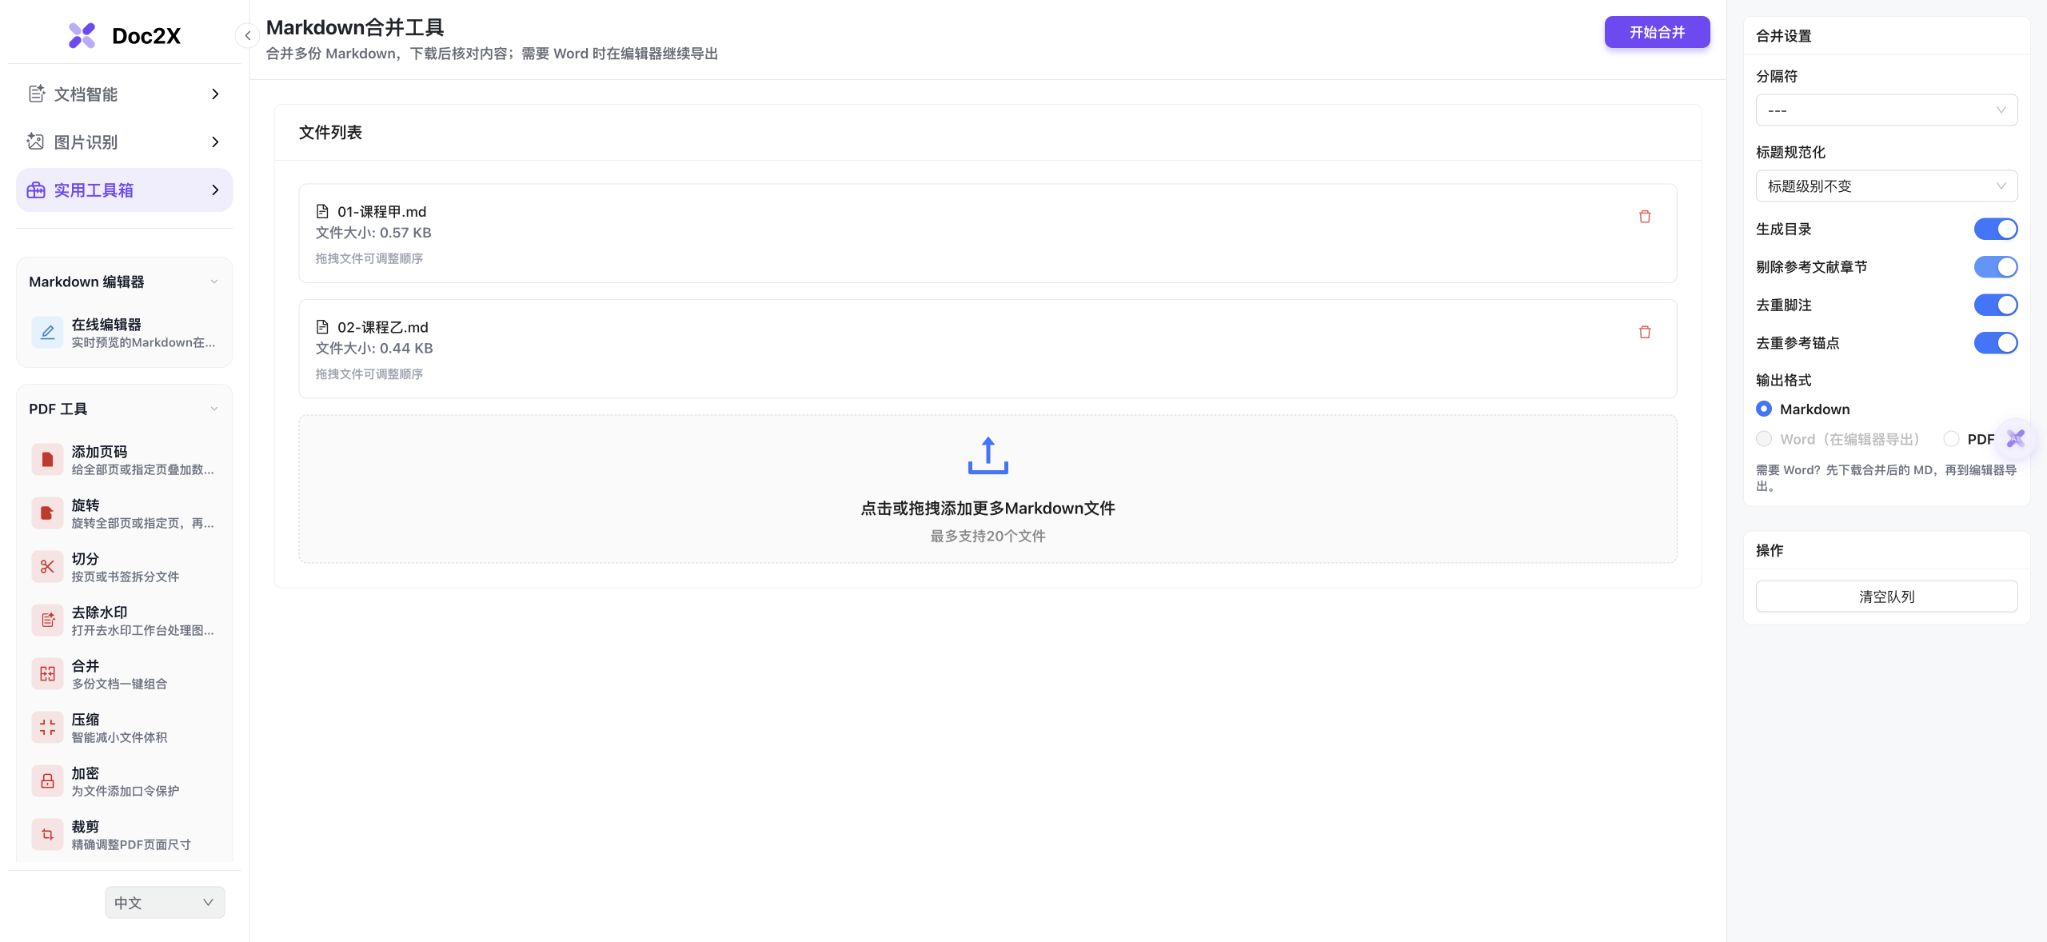
2026年10月17日,一次加入课程甲、课程乙两份完全自编中文MD,合计1,032字节。两轮只把“剔除参考文献章节”从关闭改为开启,分别合并并各下载一份原生MD。生成目录开启,脚注去重与参考锚点去重也保持开启,分隔符为---、标题不变、输出Markdown;其他设置本轮没有单独测量。
| 本例内容 | 关闭时 | 开启时 |
|---|---|---|
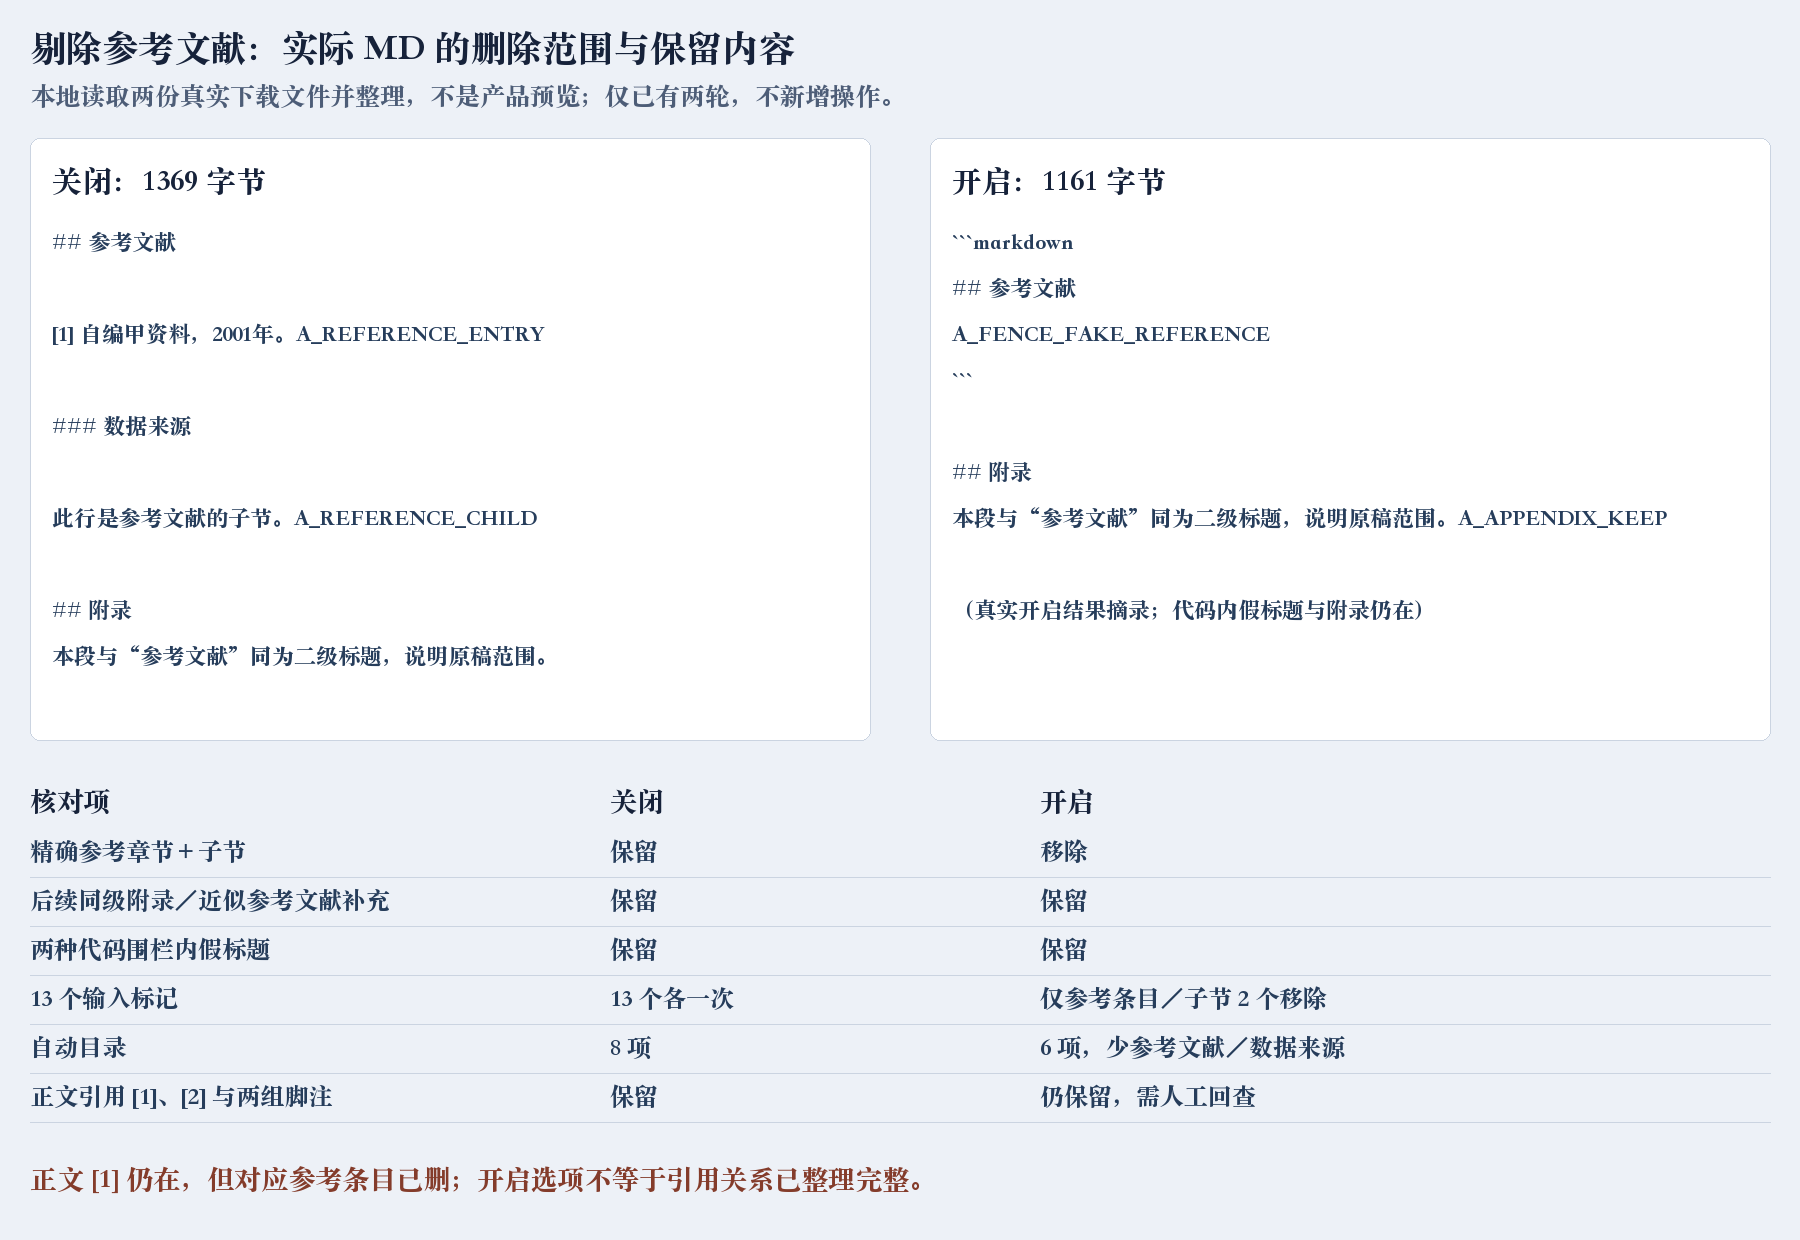
| 甲的精确## 参考文献及条目 | 保留 | 移除 |
| 该节内### 数据来源 | 保留 | 移除 |
| 后续同级## 附录 | 保留 | 保留 |
| 乙的近似## 参考文献补充 | 保留 | 保留 |
| 两种代码围栏里的假## 参考文献 | 保留 | 保留 |
| 正文[1]、[2]及两组脚注引用/定义 | 保留 | 保留 |
| 自动目录源码 | 8项 | 6项,只少参考文献与数据来源 |
本例操作设置与删除范围
顺序:课程甲 → 课程乙
输出:Markdown;标题:不变;分隔符:---
生成目录/脚注去重/参考锚点去重:保持开启
唯一变化:剔除参考文献章节 关闭 → 开启
移除:## 参考文献 及其 ### 数据来源
保留:之后的同级 ## 附录
注意:正文 [1] 仍在,需要人工回查文献关系- 关闭输出1,369字节,开启输出1,161字节,均为真实单MD下载,未将原生文件本地改成预期答案。
- 13个输入标记中,只移除参考条目与子节的2个标记;其余11个均保留且各出现一次。
- 目录源码从8项到6项,仅移除参考文献和数据来源两项,其他条目顺序相同;本轮未逐项点击目标渲染器中的目录链接。
- 将两份目录与正文分开比较,并从关闭版正文扣除准确参考节及其边界空行后,其余正文逐字节一致。近似标题、反引号及波浪线两段围栏、正文引用与两组脚注均保持。
- 参考条目删除后,正文[1]仍然保留。删除章节不是删除所有引文、修复来源关系、统一脚注或管理.bib数据库。
只验证两份小型中文ATX标题稿,没有英文References/Bibliography、Setext/HTML标题、多行引用格式或重复脚注实测。两轮仅切换目标开关,完成后恢复原关闭状态,没有第三轮生成。两张设置图来自真实UI,对照PNG与核对包为本地整理;62项主核验与129项独立审查分别记录,不合并为通用质量分数。
合并标题层级+1:H1变H2,H2变H3,H6仍为H6
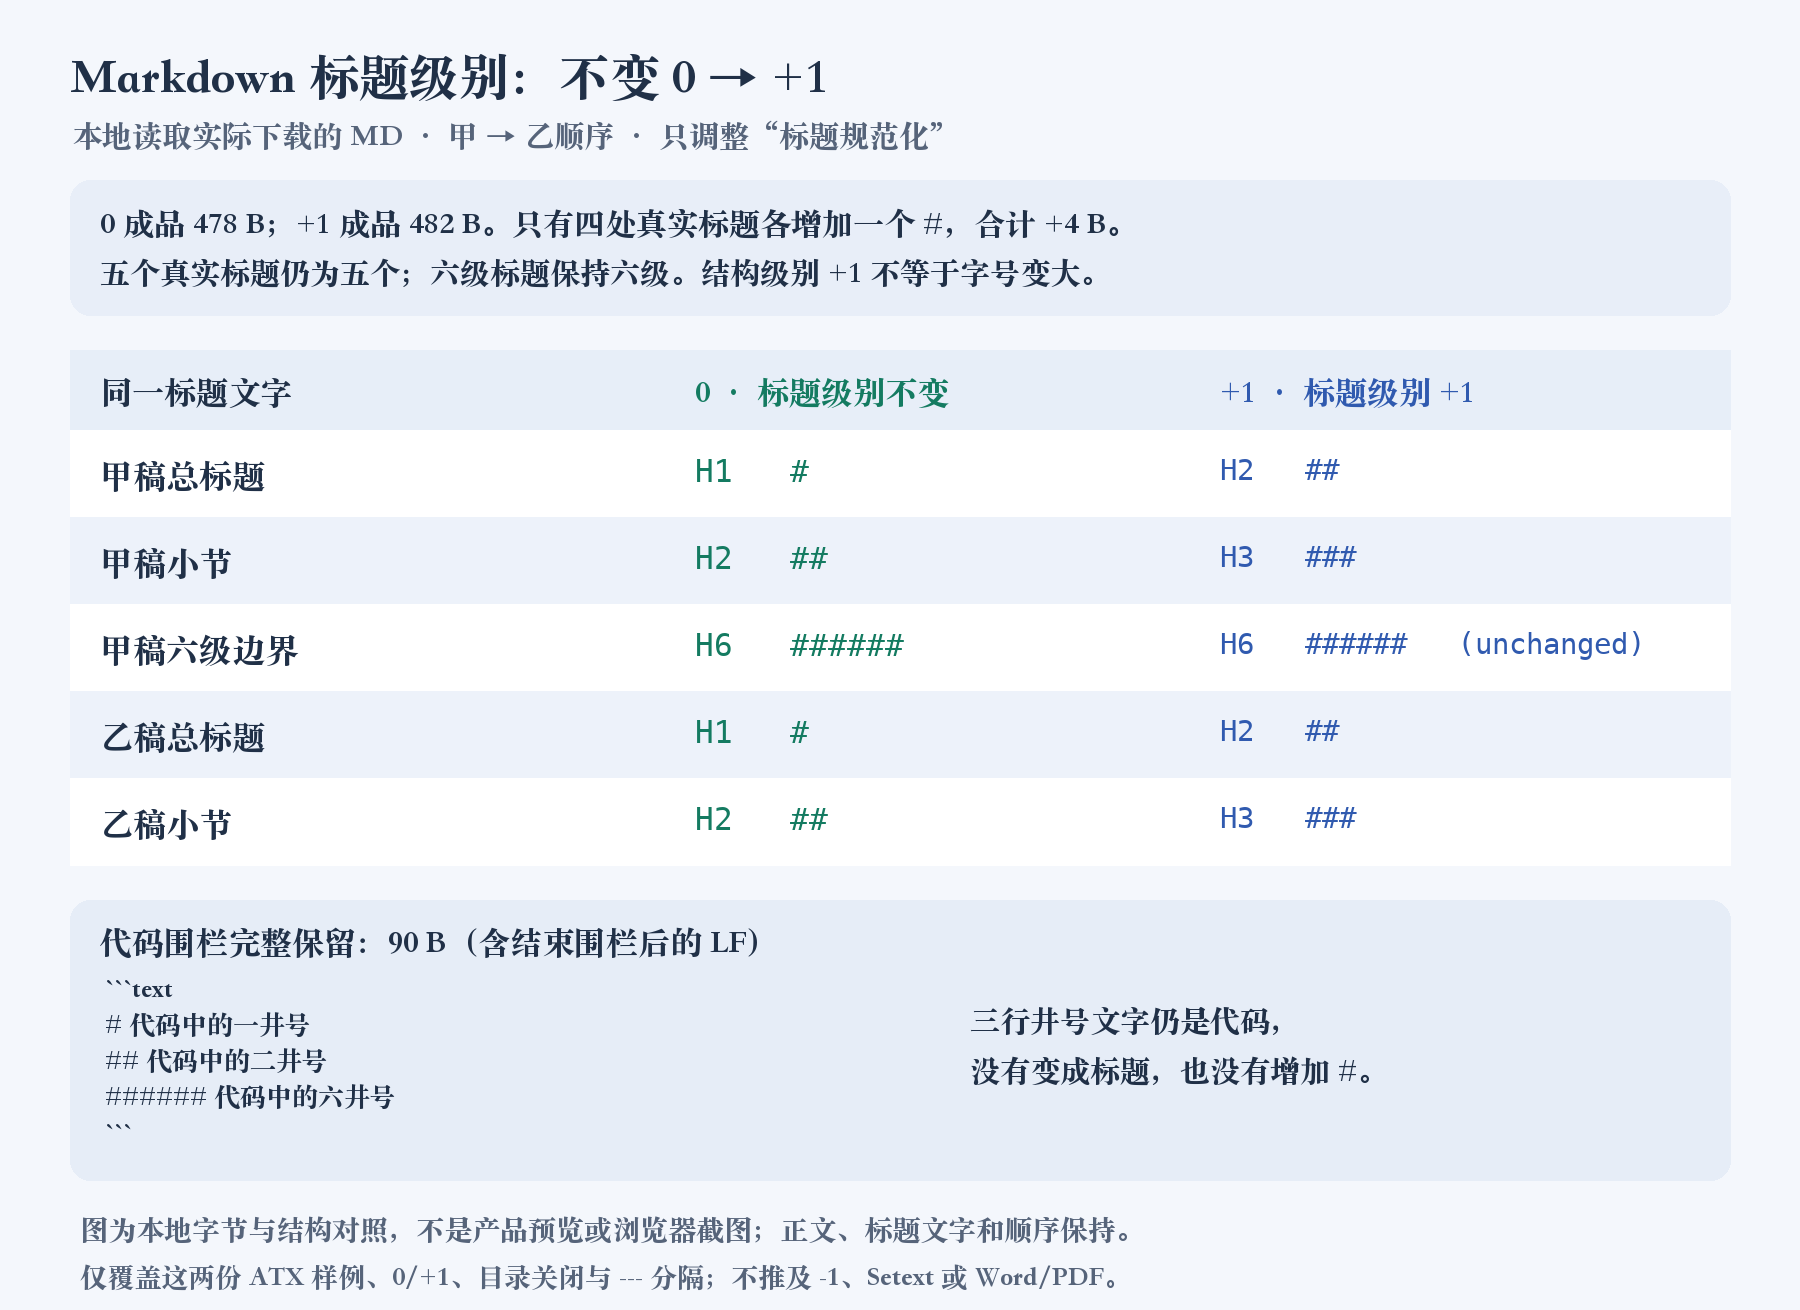
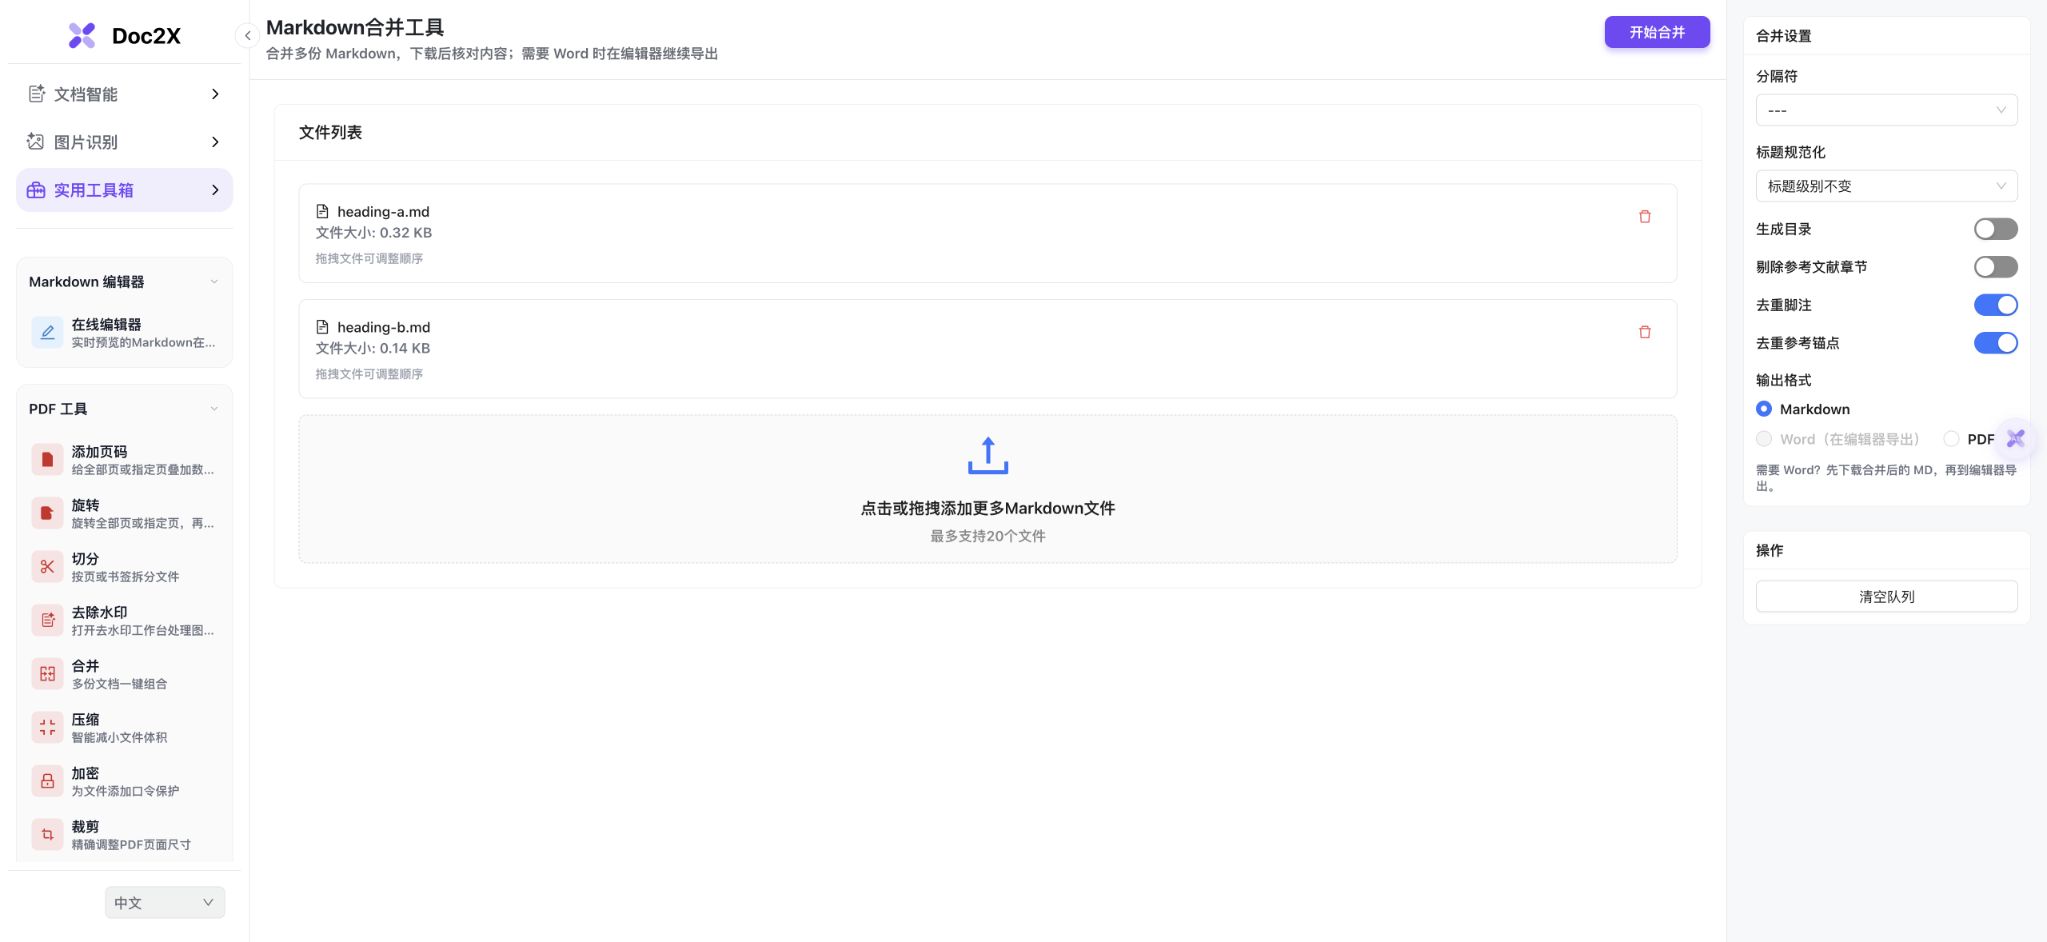
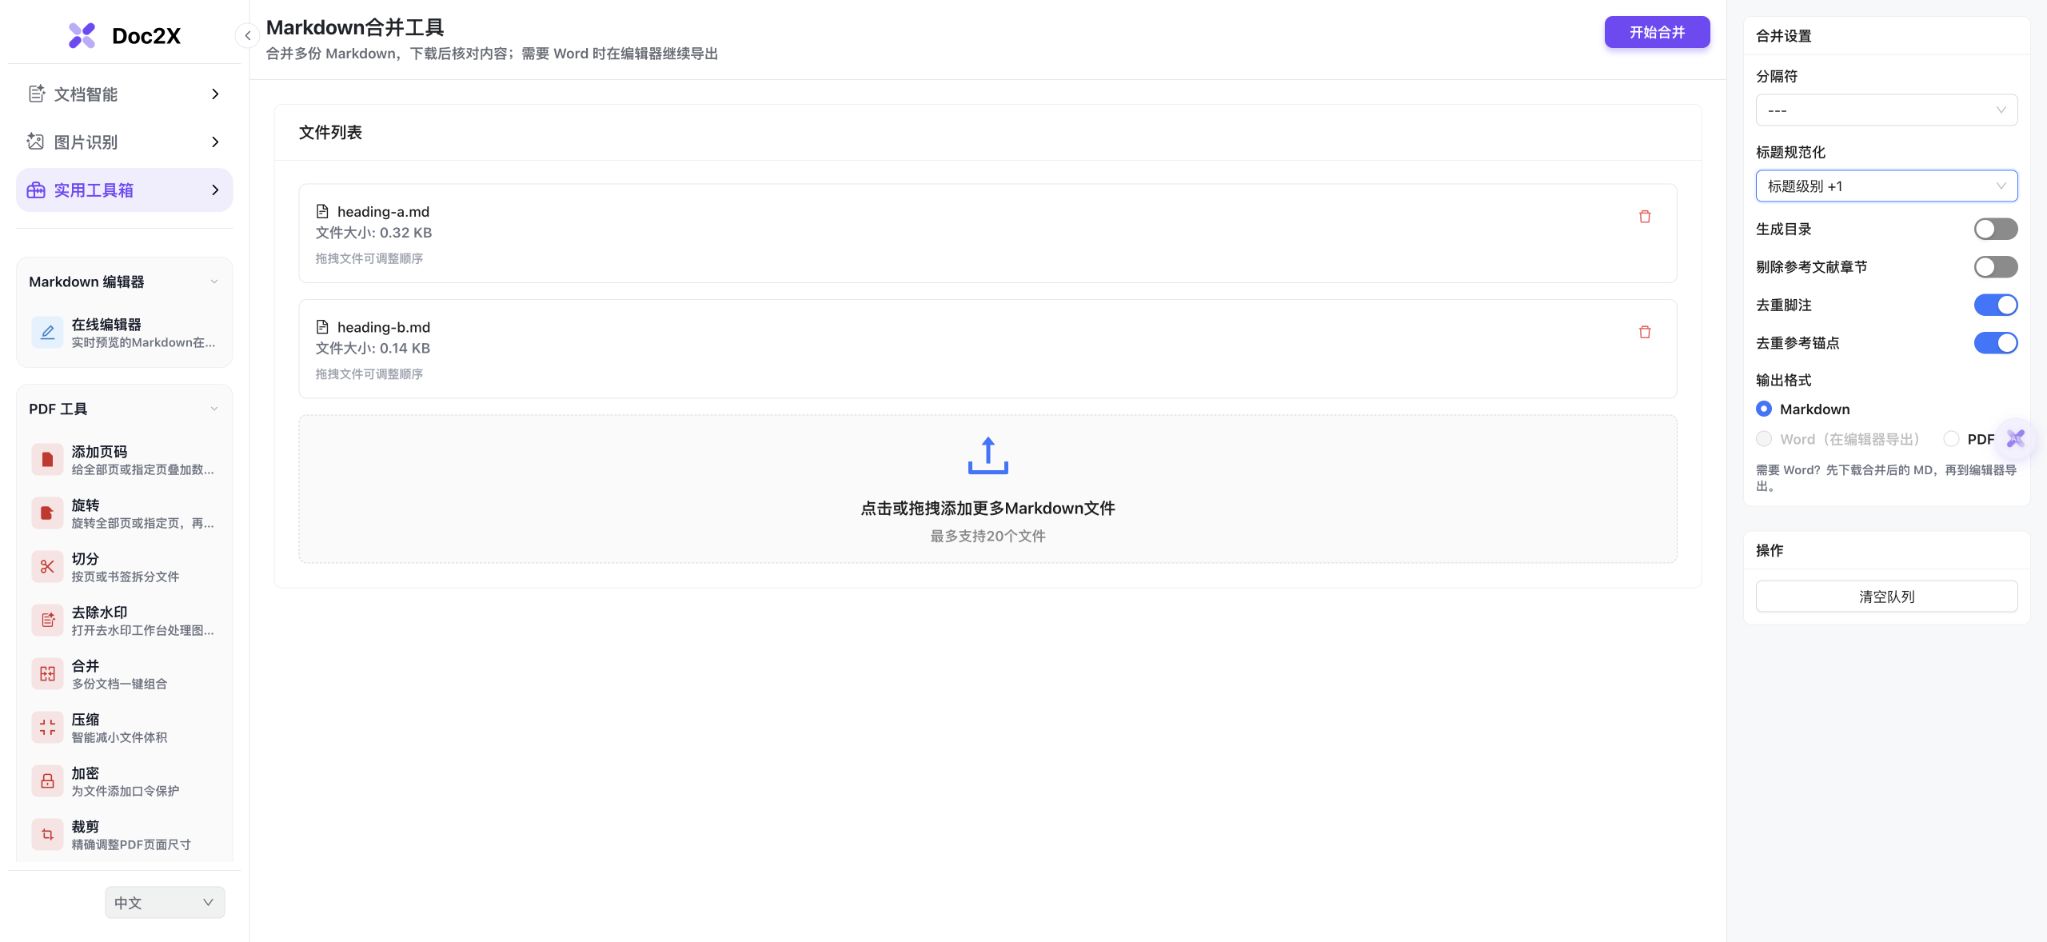
2026年10月17日,两份自编中文MD按A→B合并,先选标题级别不变,再只改为+1,各下载一次。五个真实标题由1/2/6/1/2变为2/3/6/2/3;原六级标题没有变成七级。代码围栏里的三行井号文字在本例保持为代码,没有变成正文标题。
| 原标题位置 | 不变档 | +1档 | 本例结果 |
|---|---|---|---|
| A主标题 | H1 | H2 | 增加一层 |
| A二级标题 | H2 | H3 | 增加一层 |
| A六级标题 | H6 | H6 | 仍为六级 |
| B主标题 | H1 | H2 | 增加一层 |
| B二级标题 | H2 | H3 | 增加一层 |
标题层级与代码块里的井号分别处理
真实标题节选:
# 甲稿总标题 → ## 甲稿总标题
## 甲稿小节 → ### 甲稿小节
###### 甲稿六级边界 → ###### 甲稿六级边界

本例text代码围栏中的三行:
# 代码中的一井号
## 代码中的二井号
###### 代码中的六井号
这些仍为代码,未作为正文标题调整。- 两份输入分别324、147字节。不变档实际478字节,+1档482字节;本例只多四个真实标题的前导井号,五段正文、顺序和一条分隔线保持。
- 完整代码围栏与输入逐字节相同,三行伪标题仍在代码里。本例没有改代码中的井号,不据此保证任意文稿或所有代码写法都相同。
- 正常Markdown解析及另列的本地派生HTML浏览器观察,均显示对应标题层级,正文和代码保持。派生HTML不是产品导出,也不证明其他编辑器的字体、字号或Word/PDF效果。
- 一次加入两文件,固定分隔符、目录关闭、参考章节剔除关闭、两项去重开启与Markdown输出,仅标题不变→+1;两次合并、两次单MD下载、0原生ZIP。
只验证这两份中文ATX标题稿、五个标题和一个text代码围栏。没有-1、Setext、引用/列表内标题、数学、图片、脚注、自动目录或Word/PDF实测;复杂文稿先保留原稿,选代表片段检查。完整原文件、计数、解析和本地显示范围在下方核对说明分别记录。
原稿没有标题,用文件名标出两份内容的来源
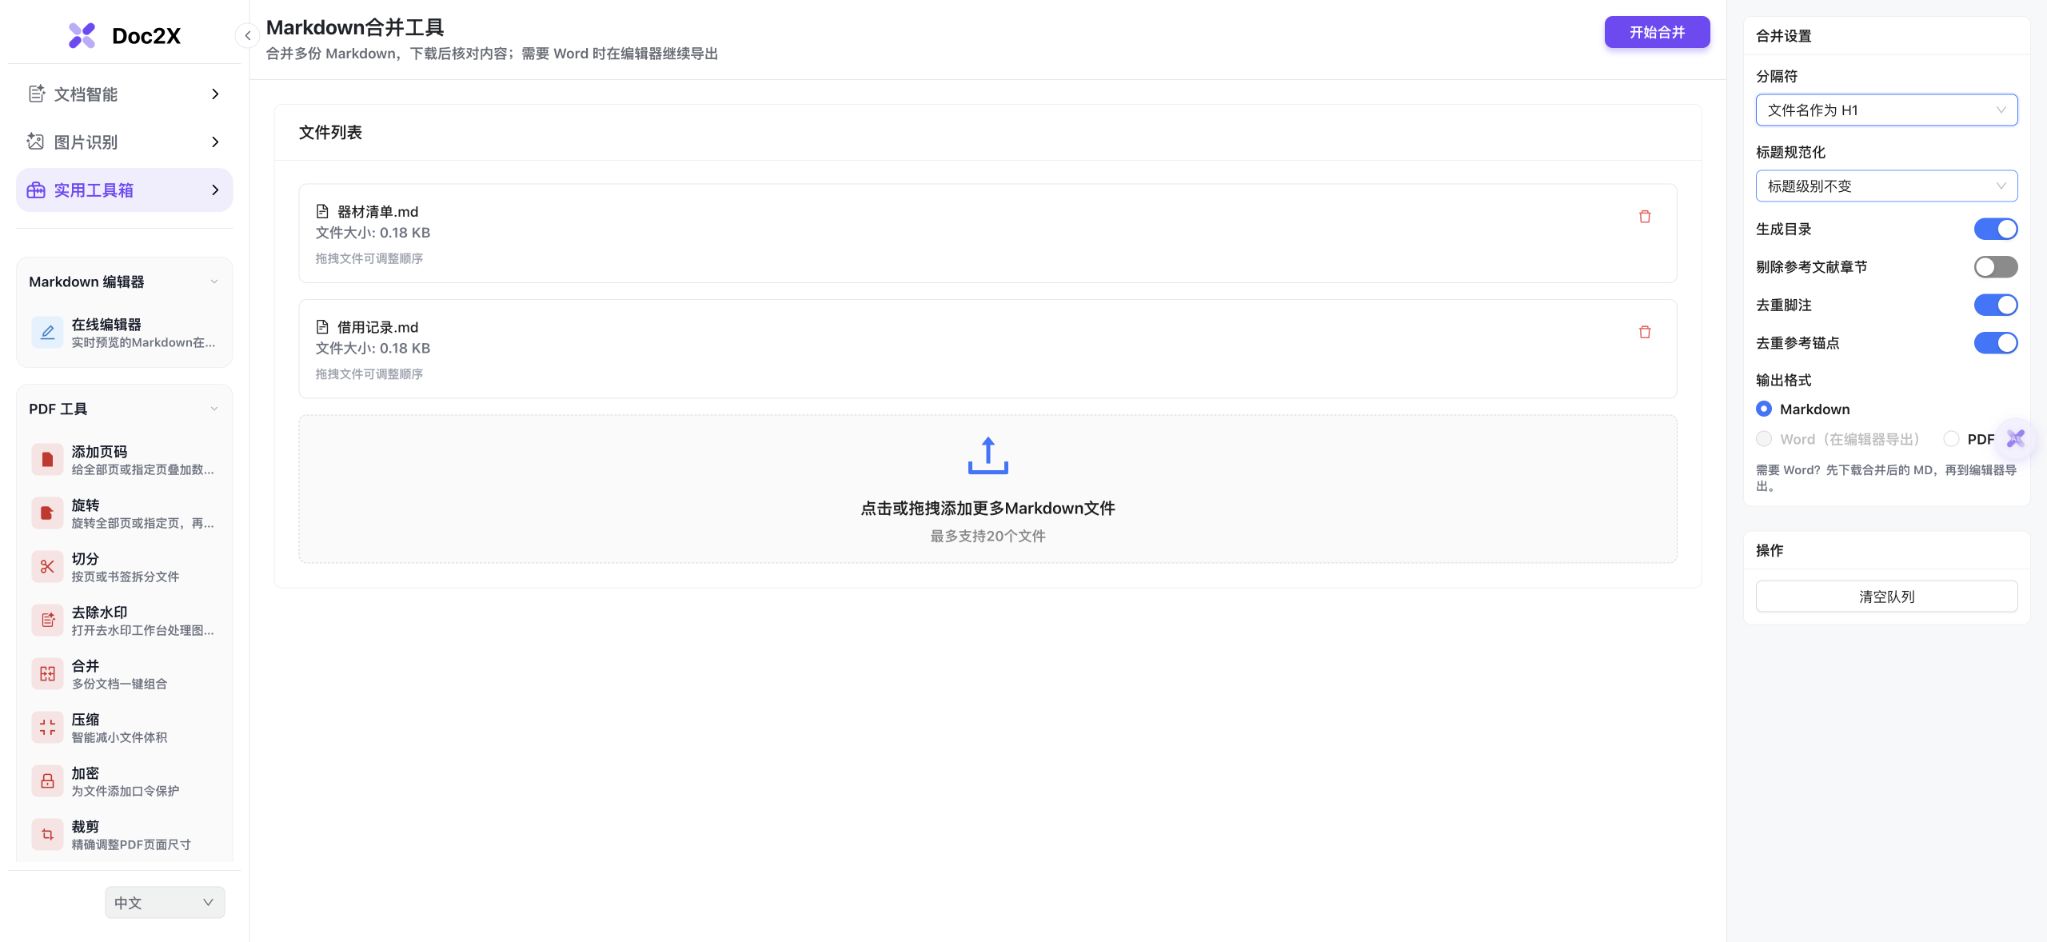
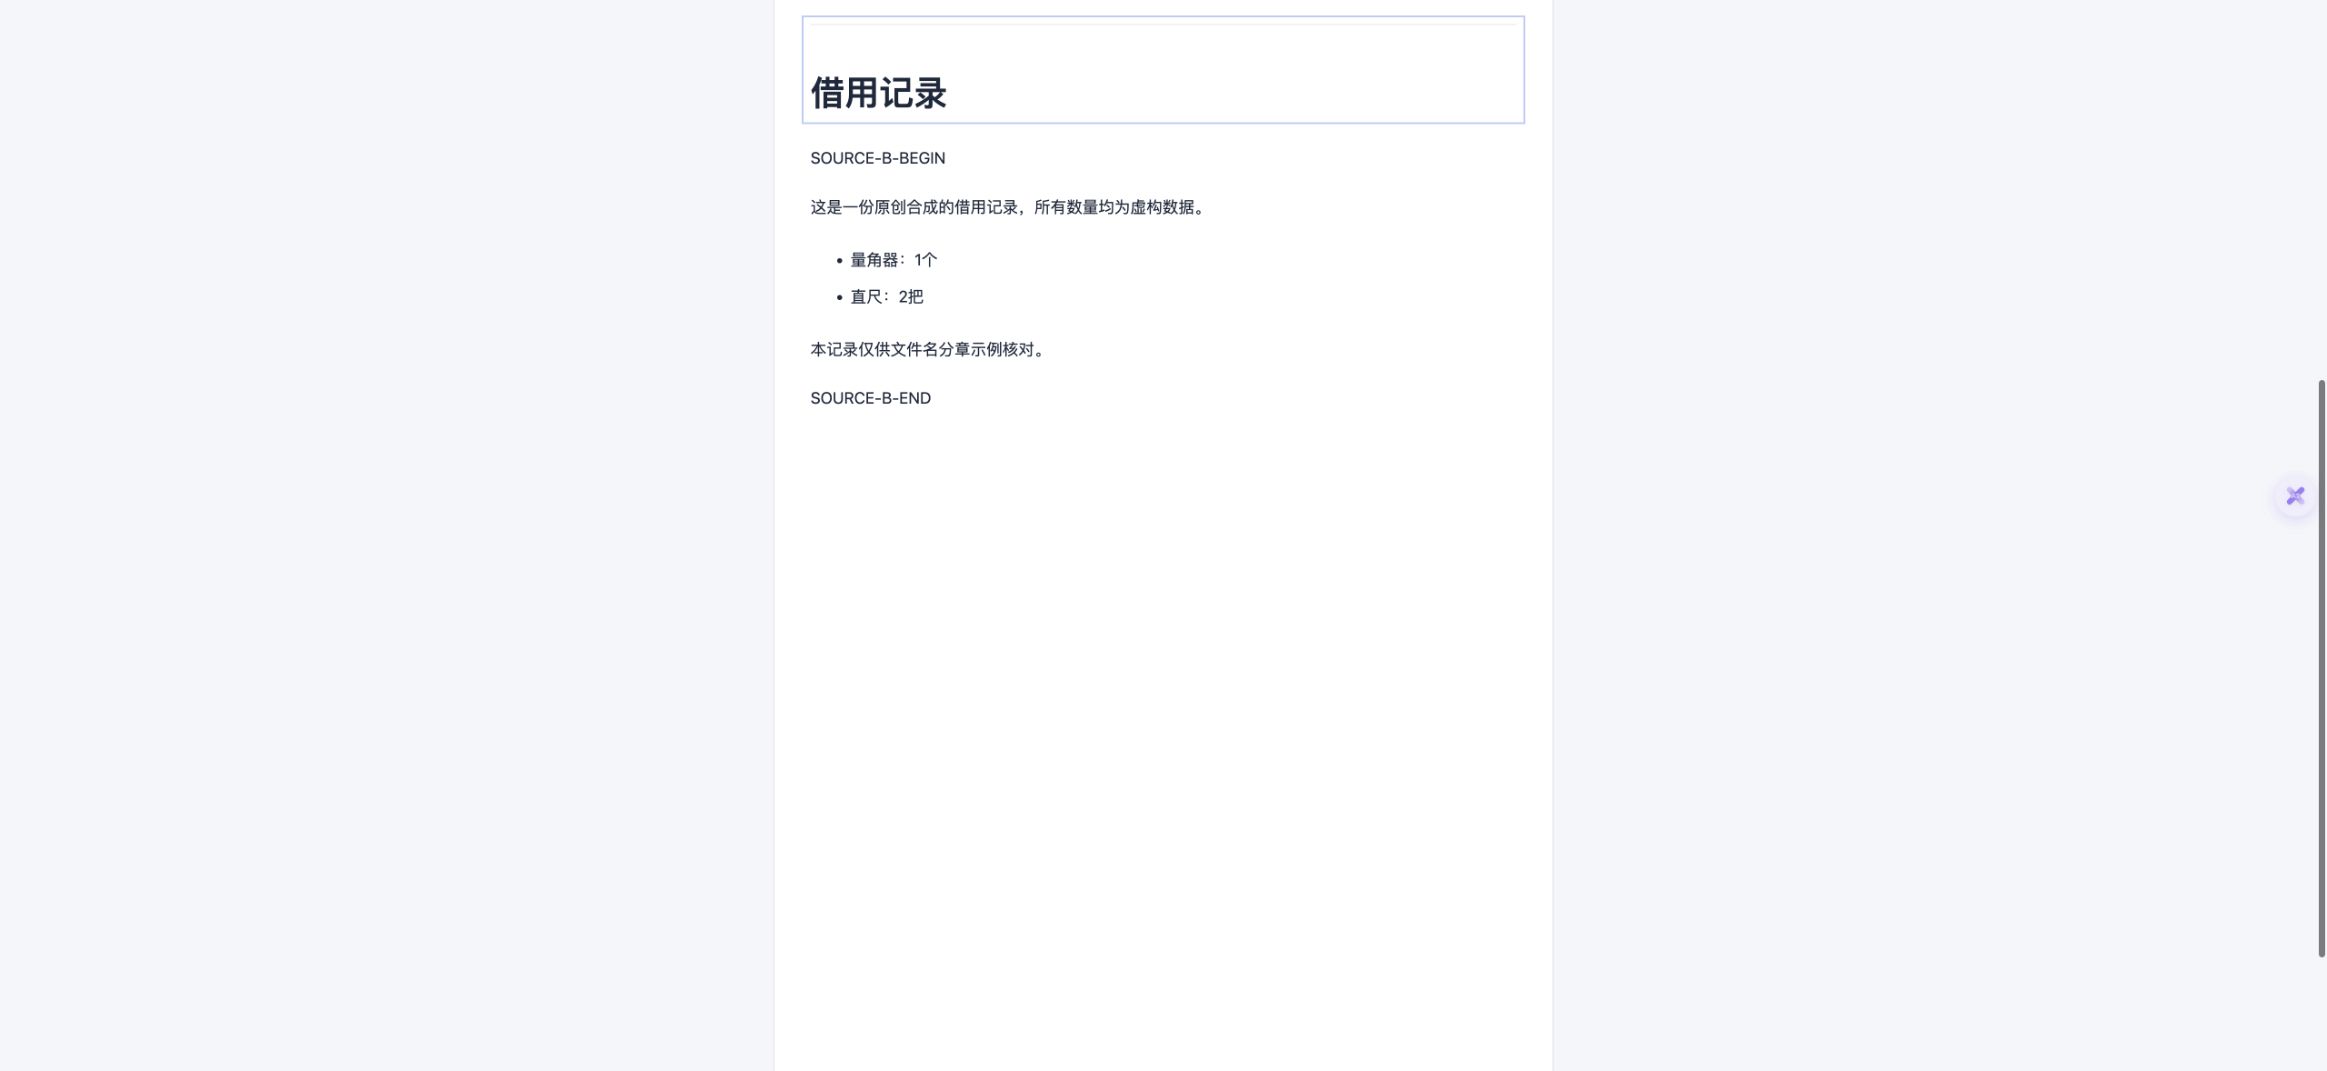
2026年10月18日,一次加入“器材清单.md”和“借用记录.md”两份无标题原创稿,只将分隔方式改为“文件名作为H1”,合并并下载一次。实际Markdown新增两个文件名一级标题和两条目录链接,两份原文段落、列表及3/8与1/2两组虚构数量按原顺序保留。随后在由该下载件生成的Pandoc 3.4本地阅读副本中,分别点击两条目录,均到对应标题;它不是合并工具的正文预览或所有阅读器兼容证明。
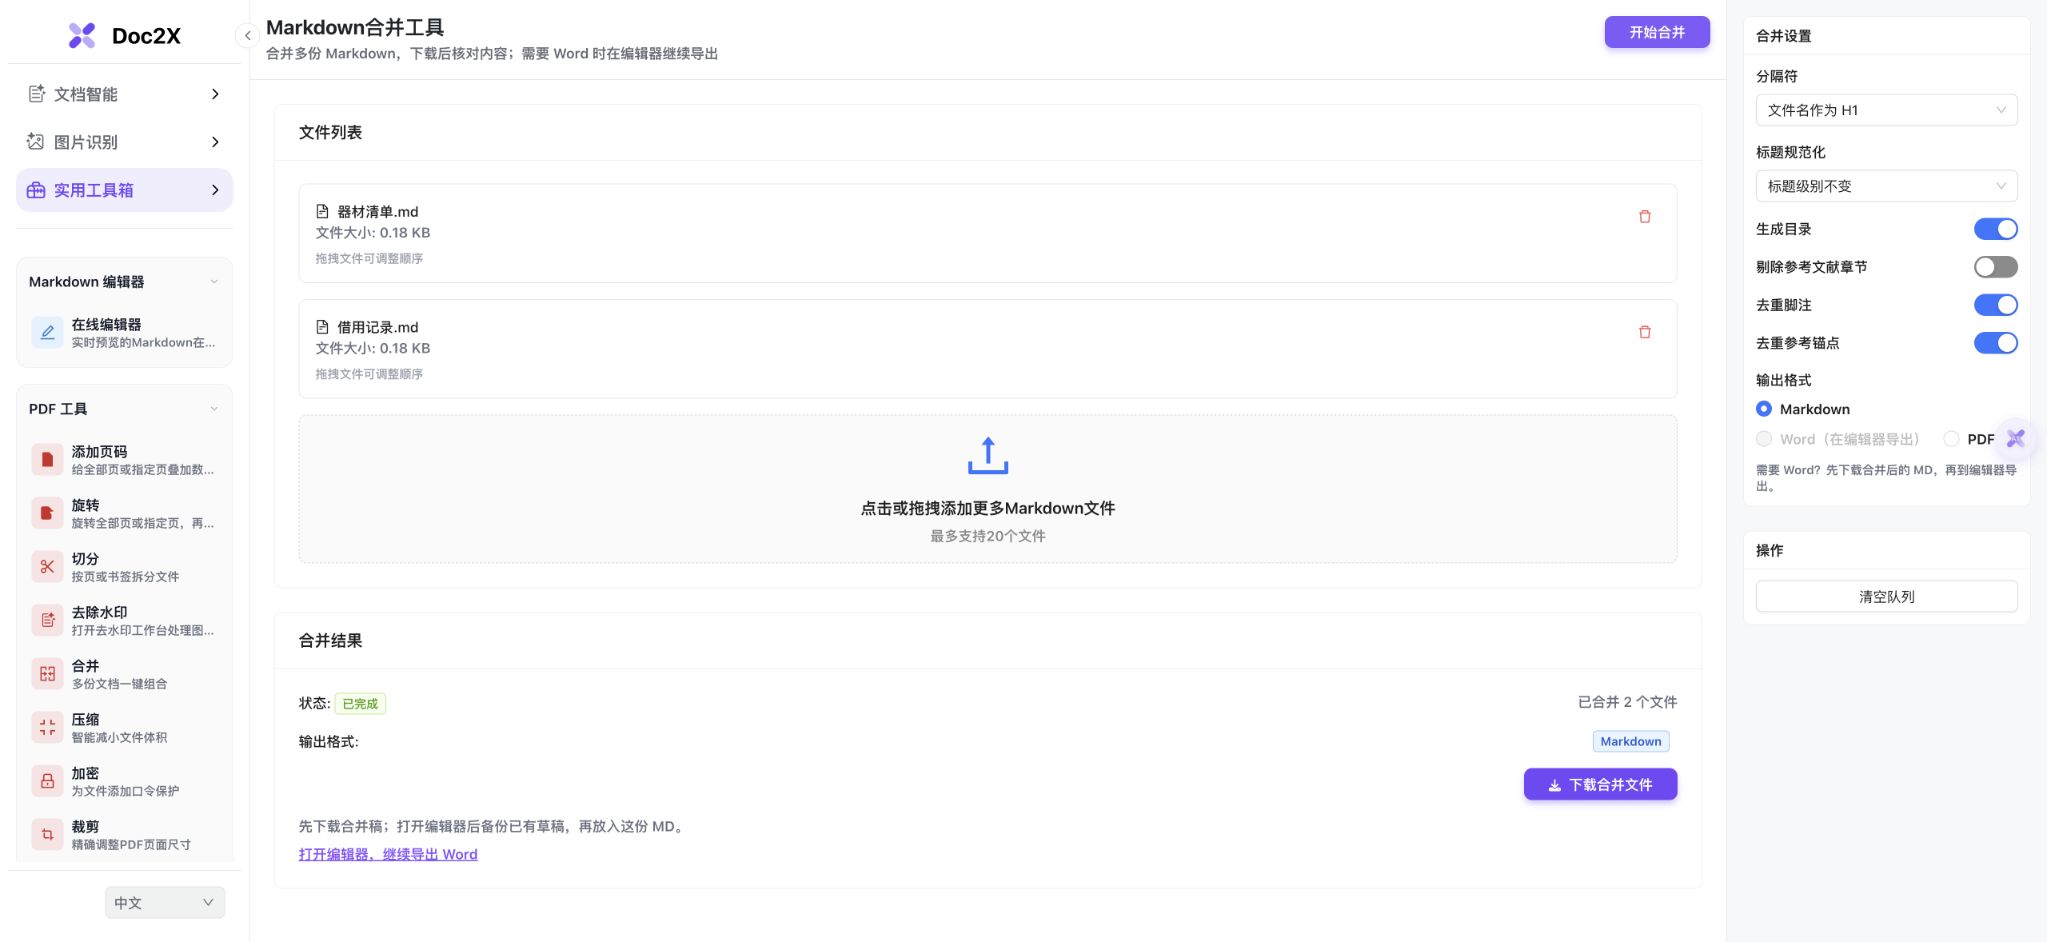
| 输入文件 | 原稿标题 | 实际新增H1与目录目标 | 保留的原文数量 |
|---|---|---|---|
| 器材清单.md,189字节 | 没有标题 | # 器材清单;目录指向#器材清单 | 量角器3个、直尺8把 |
| 借用记录.md,189字节 | 没有标题 | # 借用记录;目录指向#借用记录 | 量角器1个、直尺2把 |
原生Markdown节选:正文省略提示不是下载文件内容
## 目录

- [器材清单](#器材清单)
- [借用记录](#借用记录)

# 器材清单
…(此处省略第一份原文,仅为节选展示)

# 借用记录
…(此处省略第二份原文,仅为节选展示)- 两份输入各189字节,正文没有原有标题。实际488字节合并稿包含两份完整原文,各出现一次并保持顺序;新增的是目录源码和两个文件名H1,不是把虚构数量重新计算或改写。完整下载没有省略,以上代码只展示节选。
- 本例“器材清单.md”“借用记录.md”成为标题和目录标签时没有末尾.md;原输入文件没有改名,实际下载仍是Markdown文件。只验证这两个简单中文名称,不外推特殊标点、重复文件名或其他后缀。
- 文件名H1用于标记这两块内容的来源。本例没有带原标题的输入,也没有重复标题对照,不能据此判断会不会覆盖、重复或调整原文标题;已有标题层级样例仍按原范围阅读。
- 本地Pandoc 3.4阅读副本直接使用原生目录链接和默认标题ID,没有补目录、改链接或修复ID。两次真实点击分别到器材清单、借用记录,并核对对应原文标记及数量;换阅读器、Word或PDF后仍需另验。
- 本轮一次加入两文件、开始一次、单MD下载一次,没有默认分隔符对照、第二轮或Word/PDF/编辑器导出。标题级别不变、目录和去重等其他设置保持,但原稿没有脚注、引用或参考文献,不能把开关保持开启当成这些能力已测。
仅这两份无标题原创小稿及一次文件名分章结果。目录链接存在与阅读器实际跳转分阶段记录:原文件分析时尚未点击的记录原样保留,后来Pandoc 3.4本地副本两次点击另有证据,不表示所有Markdown阅读器都可用。产品只下载Markdown,未观察正文预览;HTML和CSS只是本地阅读材料,放在阅读副本ZIP内,没有独立网页预览或新产品HTML导出。原生MD及原输入不改写,本轮也没有原标题、重复标题、图片、脚注、引用去重或参考文献删除验证。保留原稿,在自己的目标阅读器检查来源分章、数量和导航。
文件顺序就是读者看到的顺序
准备 01-课程简介.md、02-例题.md、03-练习.md 等文件后,先在列表中确认阅读顺序,再选择分隔方式。合并后检查每个接缝:上一章是否完整结束,下一章是否重复了总标题,附录是否出现在预期位置。
标题、目录与资源需要一起核对
含代码或公式的文稿,先保留标题级别,避免标题调整影响正文中的 #。自动目录与目标编辑器的锚点规则可能不同,中文或重复标题需要逐项点击检查。图片引用如 images/chart.png 仍依赖资源目录,合并文本不会自动搬运配套图片。
选择 Markdown 输出,再继续准备 Word
在合并工具中选择 Markdown 输出并下载。打开在线 Markdown 编辑器后,先保存已有草稿,再把 .md 文件拖入页面,或将文件内容粘贴到源码区。核对标题、公式、表格和图片,点击“导出文件”选择 Word;Word 由服务端转换,需要登录,其他格式的权益与额度条件以当前界面为准。
合并后重点核对三种关系
确认章节顺序正确,目录指向相应标题,脚注与引用链接对应各自定义。中文标题应有实际锚点,重复标题应有不同目标;在最终渲染器再次点击验证。两个目录中的同名图片不会因为合并 MD 自动改名或打包。
需要 Word 时走完第二步
当前合并工具的 Word 选项尚未实现。先下载合并 MD,再在 Markdown 编辑器预览并导出 DOCX;工具内 PDF 选项调用浏览器打印,也不等于直接生成可下载的 PDF 文件。
多个 MD 合并后怎么导出 Word
先下载合并 MD,再使用结果区的“打开编辑器,继续导出 Word”,备份当前草稿后放入正文。合并完成不等于已经生成 DOCX。本例在编辑器导出的两课样稿保留表格与公式;标题锚点版的六条目录已于10月16日在 Mac Word 逐个核对,脚注仍需另查。
英文样例:顺序、重复标题与脚注分别核对
顶部英文指南提供两份英文笔记及三次实际合并结果,比较默认设置、关闭脚注去重和反向文件顺序。默认 MD 有三条脚注定义、四次引用,本地 Pandoc 仍显示四条脚注;源码去重与阅读器编号不是同一项检查。
合并后图片相同,先检查相对路径
新增中文样例中,两份讲义各自有 images/figure.png。第一次实际合并保留相同路径;第二次仅修改输入引用到独立目录,原生输出随之保留不同路径。图片路径指南提供原稿、两个实际 MD 和本地显示对照。
开启剔除参考文献后,正文引用仍要回查
新增两份中文稿只切换参考章节选项。精确参考文献节及子节被移除,附录和近似标题保留,正文[1]、[2]和两组脚注仍在。对外分享前核对来源是否还能回查,不把正文里的数字引用当成已自动整理。
合并MD标题层级加一,先看结构而不是字号
新样例将H1变H2、H2变H3,原H6仍是H6。它改变标题层级,最终外观由阅读器样式决定,不把+1当作字体放大或统一排版。
含代码的文稿,先用代表片段核对
本例代码围栏内三行井号文字完整保留,真实标题才增加层级。原稿和两份结果都可下载比较;自己的代码、公式或复杂结构仍应先另存短片段核对,再决定是否调整全文。
没有原标题时,先让文件来源可辨认
本例两份正文只有段落和列表,文件名作为H1后,读者能从“器材清单”“借用记录”区分来源。文件名新增标题与修改正文已有标题是两件事;有原标题的文稿仍需保留原件,另用代表片段核对。
目录先核源码,再在目标阅读器点击
本例原生稿两条中文目录链接在Pandoc 3.4本地副本中分别到正确标题,没有手改目标。这个结果只属于该副本;其他编辑器、Word或PDF的标题ID规则可能不同,不能只看目录文字就判断导航已通过。
详细操作教程
调整文件顺序、分隔符和标题层级,检查目录与引用。
合并完成后继续验证目录与脚注,明确网页预览和实际文件的不同边界。
遇到这些情况
- 选择 Word 后没有生成文件
- 当前合并工具的 Word 选项尚未提供直接转换。改选 Markdown 并下载;先保存在线编辑器已有草稿,再拖入合并文件或粘贴正文,核对预览后选择 Word 导出。
- 调整标题后,代码或公式中的 # 发生变化
- 保留原稿,将标题级别设为不变后重新合并;需要调整真实章节标题时,在编辑器中逐项修改并对照代码与公式。
- 添加第二个文件时没有出现
- 先检查两个文件是否同名。当前选择逻辑会跳过同名文件,可把不同章节另存为清晰且不同的文件名后再添加。
- 合并后图片丢失或显示错图
- 检查 images/chart.png 等相对引用;把配套图片放到正确目录,遇到重名资源先重命名并更新引用。
- 中文目录点不动,或重复标题跳错
- 自动生成的链接锚点可能与目标编辑器规则不同,中文或重复标题尤其要逐项验证并修正链接。
- 不同章节脚注编号冲突
- 相同脚注标识未必引用同一来源。检查定义与引用的对应关系,必要时按章节改成不同标识再合并。
常见问题
合并工具可以直接生成 Word 吗?
当前合并工具的 Word 选项尚未提供直接转换。先下载 Markdown,再到在线编辑器核对内容并选择 Word 导出;这不是自动传送文件,也不代表 Word 导出免费或不消耗额度。
合并会自动解决所有图片重名问题吗?
不会自动搬运或重命名配套图片。相对路径、资源文件名和保存目录需要一起检查,尤其是来自不同资料包的图片。
合并后还能拆回章节吗?
保留清晰的标题结构后,可以再用 Markdown 拆分工具按章节整理。
Markdown合并删除参考文献,会连附录一起删吗?
本例精确## 参考文献及其### 数据来源被移除,后续同级## 附录保留。自己的标题级别和结束位置需重新核对,不能把这一组结果当作任意文稿保证。
参考文献补充或代码里的同名标题会被删吗?
本例## 参考文献补充与反引号、波浪线两段代码围栏里的假标题均保留;只验证这些具体写法。
删除参考文献后,为什么正文[1]和脚注还在?
本轮只移除匹配章节,正文引用、脚注引用和定义仍保留。需要检查来源对应关系时应人工核对,不能把开关当作引文或脚注整理器。
Markdown合并标题级别+1是什么意思?
本例H1变H2、H2变H3,原H6仍H6;数字增一表示标题层级变化,不是字体增大。
Markdown六级标题加一会变成七级吗?
本例没有。原六级标题在真实下载和正常解析中仍为H6,只验证这一组输入和+1设置。
Markdown合并会把代码里的#也改掉吗?
本例一个text代码围栏的三行井号文字逐字节保持,未算作正文标题。不能据此保证所有写法,保留原稿并先用代表片段对照。
调整标题后就能保证Word字号或目录正确吗?
不能。这次只验证MD下载和本地解析/显示,Word/PDF、自动目录和其他阅读器需另行验收。
无标题Markdown合并后怎样按文件分章?
本例选择分隔方式“文件名作为H1”,两份无标题稿分别新增文件名一级标题,原文按顺序保留。只验证这两份输入,没有默认分隔线对照或任意文稿完整分章保证。
文件名H1和原文标题有什么区别?
文件名H1来自输入文件名,用来标记本例两块内容的来源;原文标题则写在正文里。本轮原稿没有标题,不能用它证明原标题会被覆盖、去重或怎样调整层级。
合并目录中的文件名为什么没有.md?
本例生成的H1和目录标签使用“器材清单”“借用记录”,没有末尾.md;输入没有重命名,合并下载也仍是Markdown文件。其他复杂名称需另核。
Markdown目录有中文链接就一定能跳转吗?
不一定。要在目标阅读器检查链接和实际标题目标。本例只有Pandoc 3.4本地阅读副本的两次点击验证,不是所有阅读器、Word或PDF兼容结论。
内容核对:2026-10-18 · 功能条件与配额以当前产品界面为准