
本页内容
选标题或大纲,下载后核对首尾内容
- 选择已有 MD,确认真实标题层级与文件头。
- 按 H1/H2 分章,或切到单文件模式勾选大纲。
- 设置是否保留 Frontmatter 与文件名,点击开始拆分。
- 下载 ZIP 或选取的 MD,检查前言、公式、代码和文末标记,配好图片目录。
修改规则后重新拆分。文件保存位置由浏览器决定,关闭工具前先下载。
同一份原稿,下载两章实际拆分结果
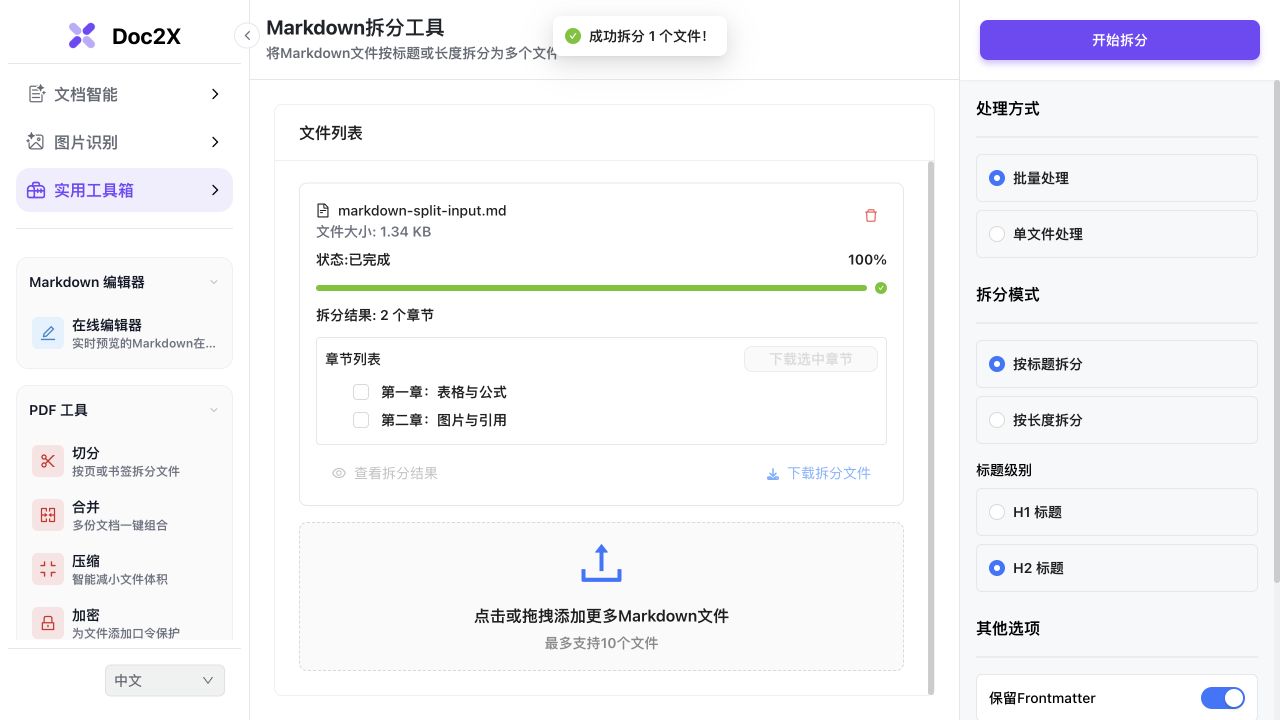
将自编 UTF-8 样稿选入已上线的 Markdown 拆分工具,选择 H2,保留 Frontmatter 后下载 ZIP。样稿含 YAML、无标题前言、两章正文、表格、多行公式与代码中的假标题;两份 MD 按顺序连接后,与本例输入的正文和换行逐字节一致。
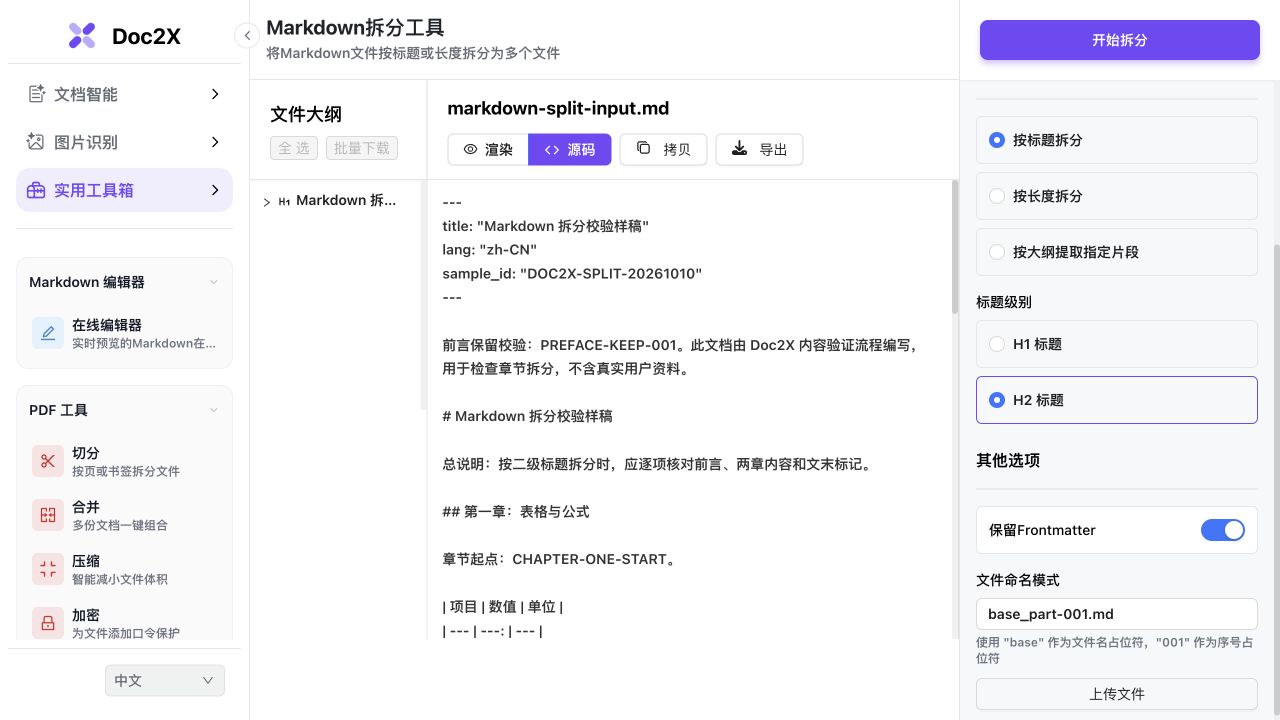
解压实际 H2 成品后可看到这两份文件
markdown-split-input_part-001.md
  YAML + 前言 + 总标题 + 第一章(含小节、表格、公式、代码)

markdown-split-input_part-002.md
第二章 + images/chart.png 引用 + 全文结束标记- 第一份应保留 PREFACE-KEEP-001;CODE-FENCE-KEEP-001 与代码里的 ## 不应被单独拆出。
- 核对表格 A=12、B=18、合计 30,以及多行公式的 $$、aligned 和换行。
- 第二份应保留图片引用与 DOCUMENT-END-20261010。验证包另附参考 Token 目标 100 的六份实际输出。
- 需要只取第二章时,可比较附带的实际章节 MD;勾选提取时文件头只写入一次。
本次核对针对实际下载的 Markdown 源码。渲染效果与相对图片仍需在目标编辑器检查;跨章脚注和引用定义不会自动复制。拆分 ZIP 只含 MD,验证包中的 input/images/chart.png 由我们另行附入,工具没有自动收集图片。
先了解这几件事
上传已有 MD 后,章节清晰的文稿先选 H1 或 H2;只取一部分时,在单文件模式展开大纲并勾选章节。点击开始拆分,再下载结果。原文前言留在第一份,文件头按开关保留;完整代码、表格和公式不会为凑长度目标而从中间切开。
- 选择层级
- 按 H2 时,H3 小节留在所属章节;代码围栏中的 # 不算标题。
- 前言与文件头
- 前言保留在第一份;YAML 可保留一次或关闭移除。
- 长度目标
- 字符与参考 Token 允许完整内容块超过目标;内容块模式按块计数。
- 图片资源
- 保留引用路径,原图与跨章引用定义需要另外检查和携带。
- 目标100,不是硬上限
- 本次长围栏完整保留为377参考Token。先在本地副本按每3条记录整理围栏,再拆出的8片为50–82;这是本样例结果,不是任意输入的硬上限保证。
- 同名批量来源
- 本轮两个notes.md结果卡都下载为B正文,A的章节未出现在这两份结果里;B仅改名为notes-b.md再对照时,两份实际ZIP才分别匹配A与B。
目标100,为什么一片仍会超过100?
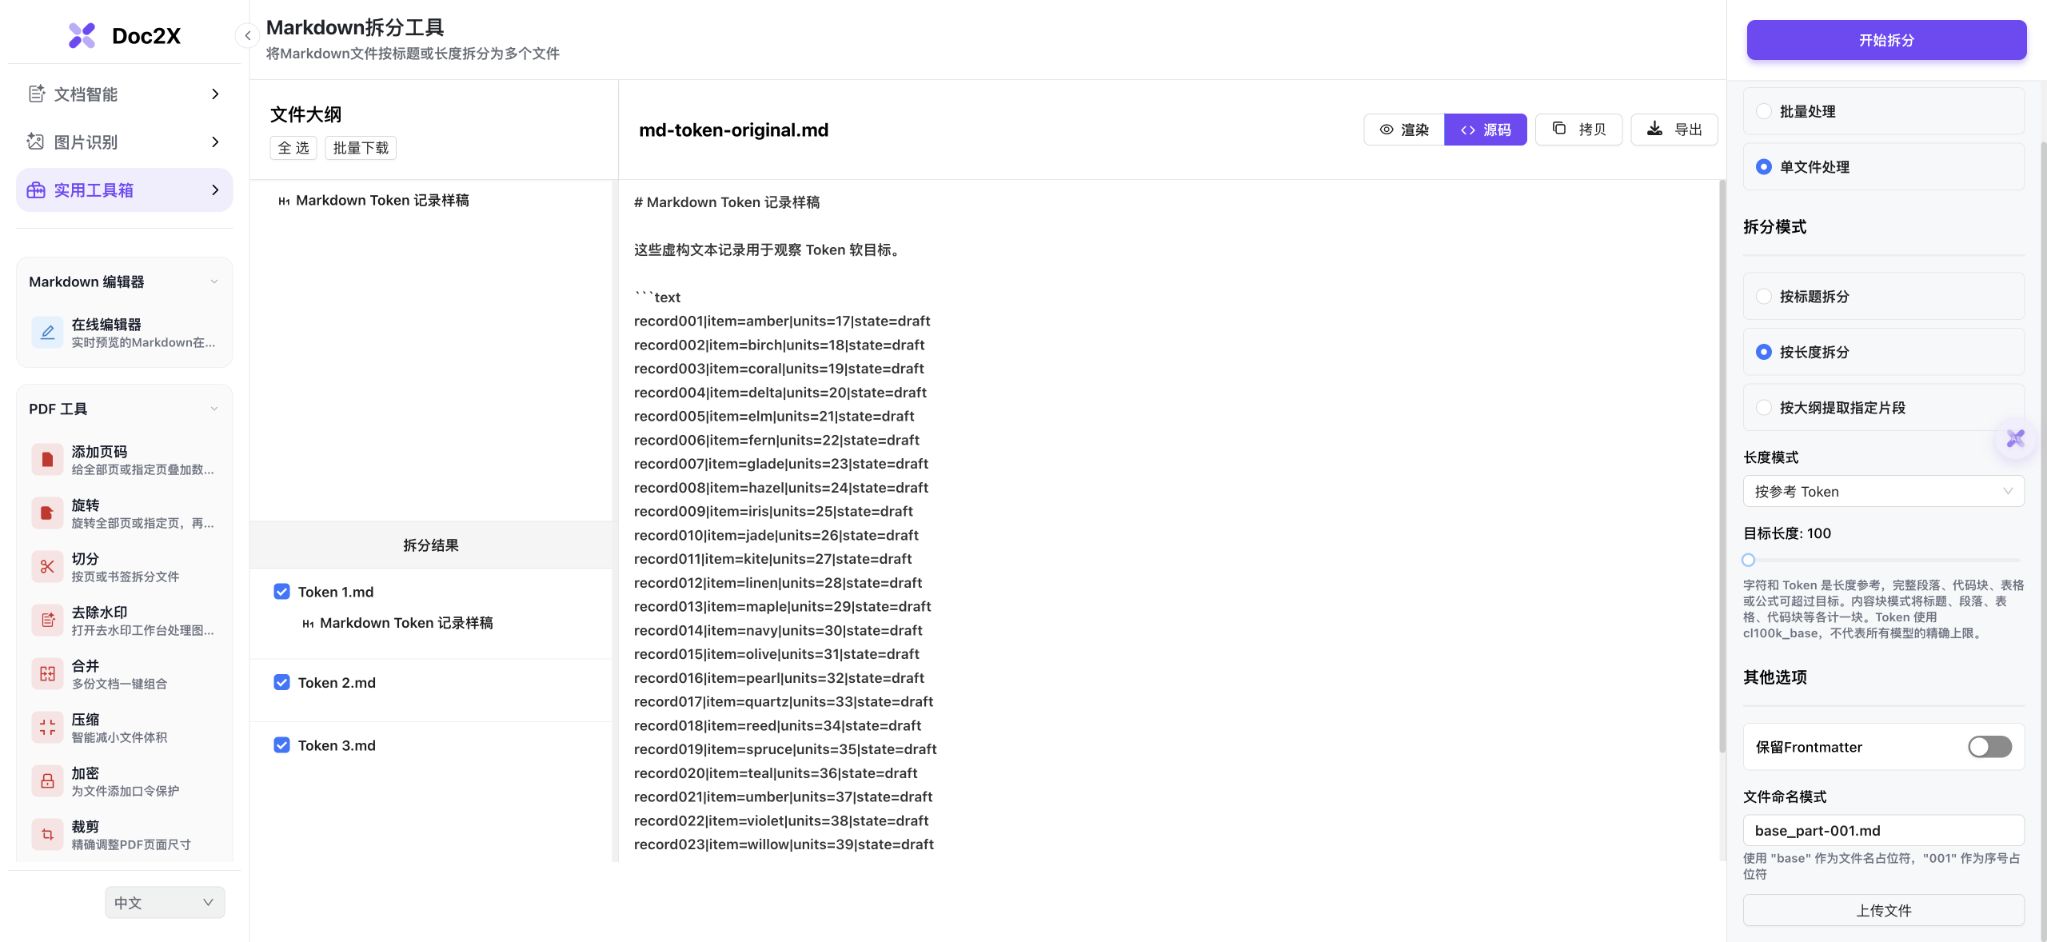
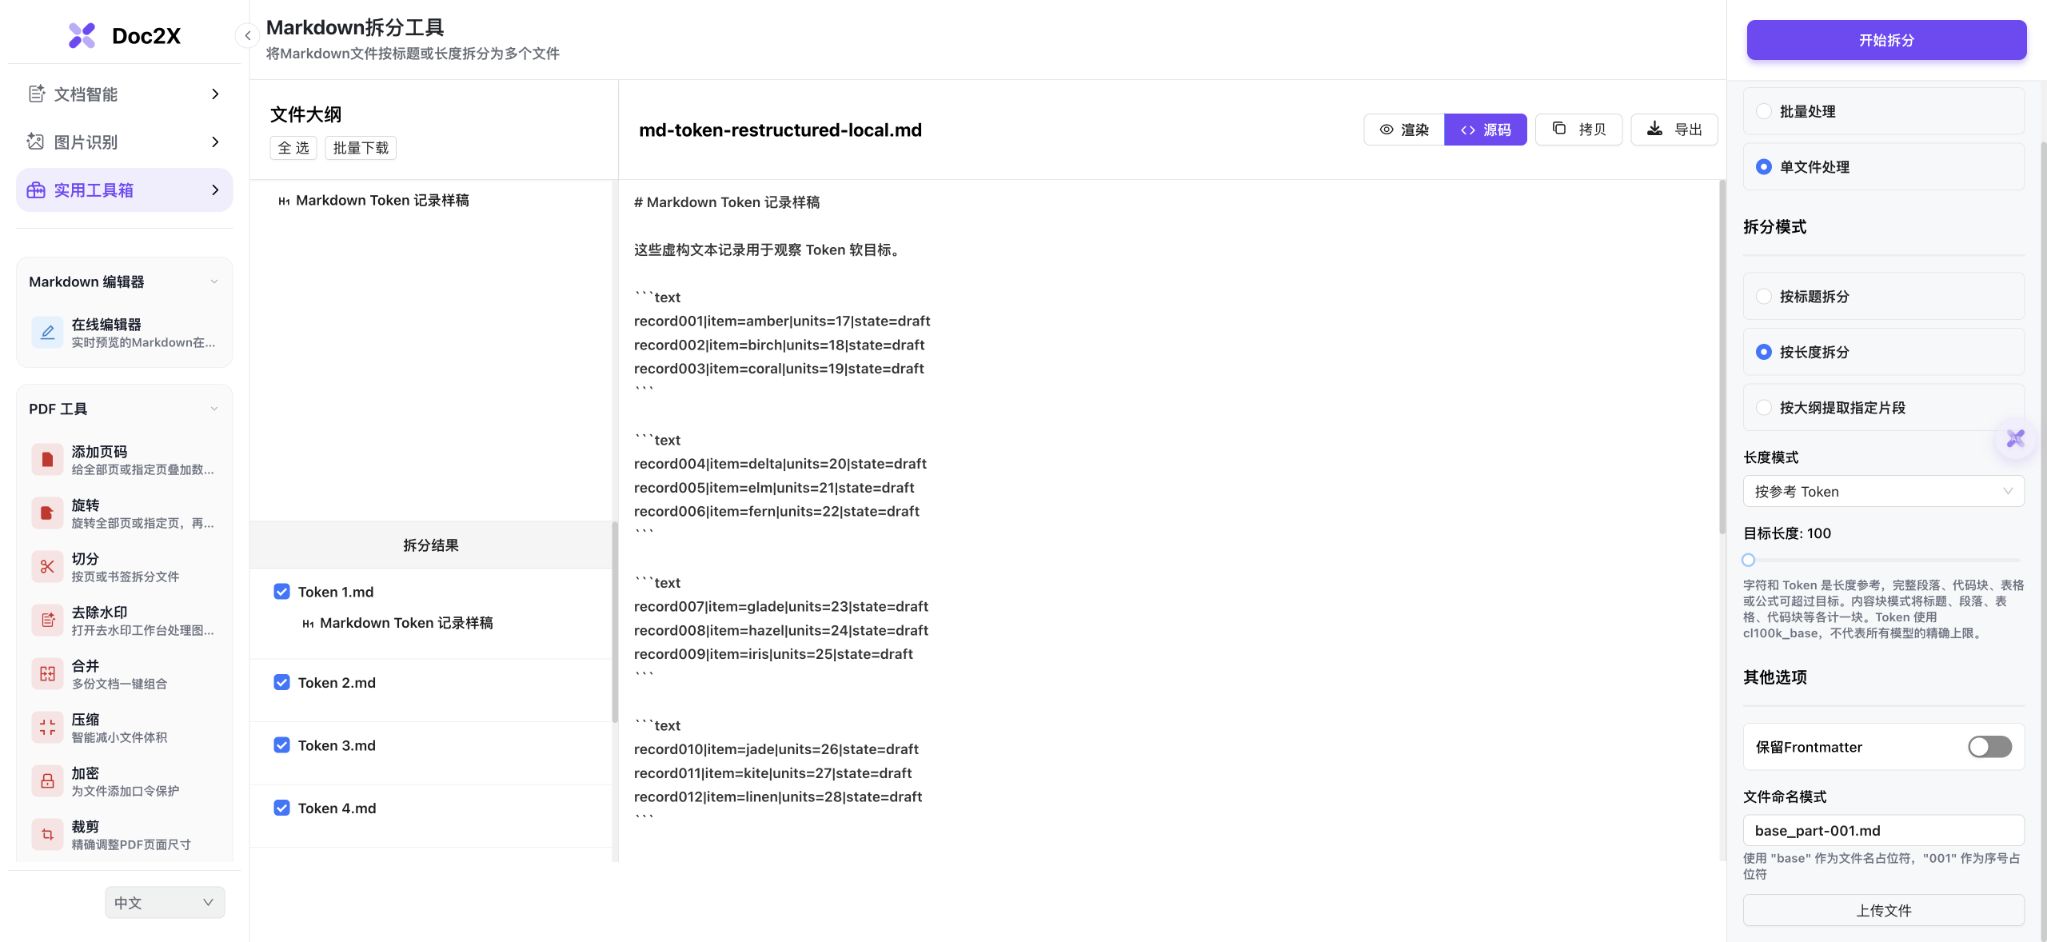
2026年10月20日,将同一组24条自编虚构记录分别放在一个完整text围栏与本地手工整理的8个围栏中,以相同参考Token目标100、Frontmatter关闭,在已上线工具各拆分一次,并各下载一份原生ZIP。第一轮3份中有一份为377参考Token;人工副本第二轮8份为50–82。逐片数字来自下载后的本地完整MD计数,截图只展示实际界面。
| 输入与实际ZIP | 本地逐片参考Token | 本次核对 |
|---|---|---|
| 原稿:1个text围栏,1,176字节、427参考Token;实际3份MD | 30、377、20 | 中间377的围栏保持完整;3份按序连接与原稿字节一致 |
| 本地人工副本:8个围栏,1,267字节、462参考Token;实际8份MD | 82、50、51、51、53、52、52、71 | 24条记录文字与顺序保持;8份按序连接与人工副本字节一致 |
只看第3/4条记录之间:人工副本新增闭合和开启围栏
原稿中的连续摘录:
record003|item=coral|units=19|state=draft
record004|item=delta|units=20|state=draft

本地人工副本中的连续摘录:
record003|item=coral|units=19|state=draft
```

```text
record004|item=delta|units=20|state=draft- 两份输入分别选入工具,设参考Token100并关闭Frontmatter,点击开始拆分后全选、批量下载。
- 原稿只有1个完整text围栏,包含24条虚构记录。第一轮实际3份,长围栏所在文件为377参考Token;每份MD的围栏均完整,没有为目标100从块中间切断。
- 人工副本在每3条记录处手工闭合、重新开启围栏并加空行,形成8个围栏。副本与原稿不同字节,总Token也不同;24条记录的原文字节与顺序保持。上方只摘录第3/4条记录边界,不是完整文件,也不单独计算摘录Token。这是事先本地整理,不是工具自动修复。
- 两轮原生MD分别按顺序连接,与各自对应输入逐字节一致。不能据此说人工副本与原稿本身字节相同。
- 逐片计数使用每份完整MD,包括围栏、前后文字与换行。两份原生ZIP保持未修改;CSV是本地核对表,JSON是本地来源与范围说明,均不是产品原生导出。
- 人工副本8份在本例均未超过100,不能推广成任何原稿、分词器或模型的硬上限保证。真实程序、表格和公式是否适合手工分块,应按其含义另行判断。
第一幅截图可见3份结果,第二幅只可见前4份;8份总数以产品结果及实际ZIP为准,截图不证明逐片Token数。记录是自编虚构文本,不是可执行代码。新增围栏使输入从427增至462参考Token;本次只验证这两份输入。其他模型还需重新计数,并留出提示词、请求包装与回答空间。
同名卡片不等于来源齐全:原生下载与重命名对照
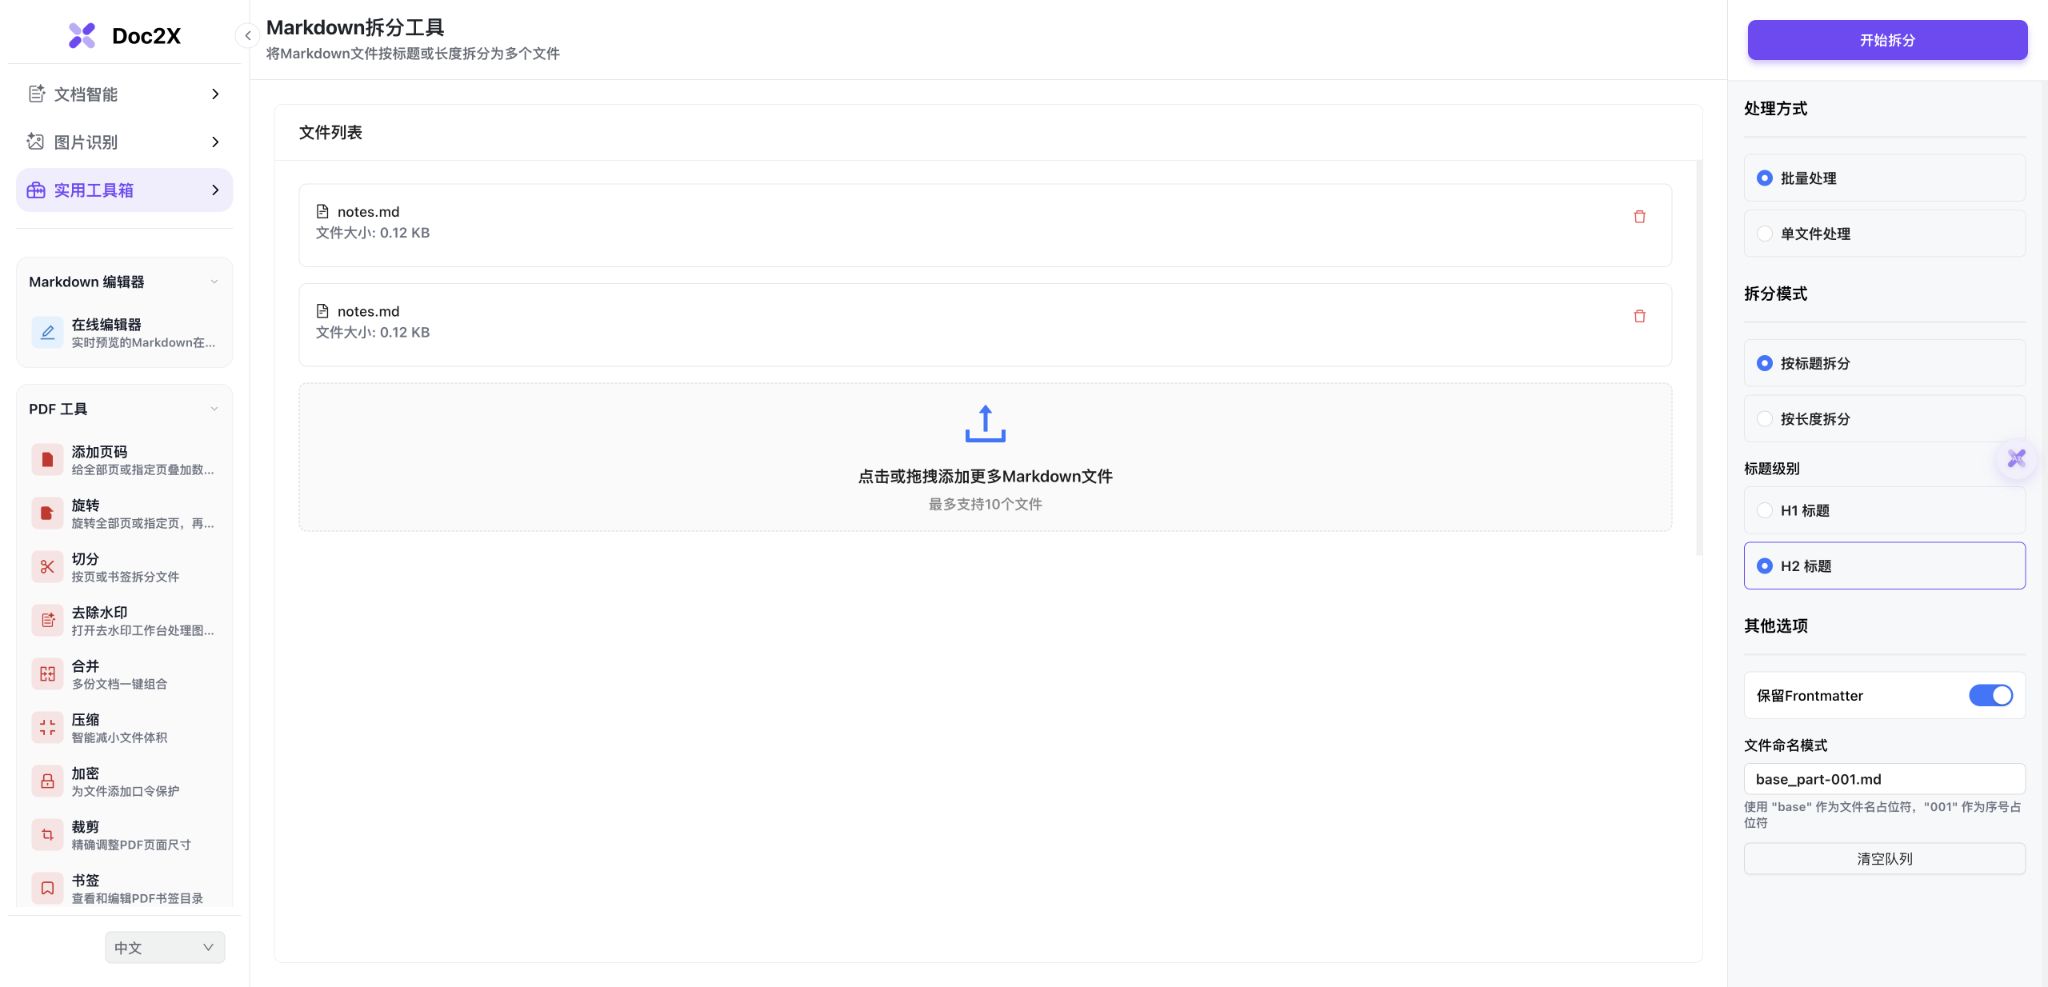
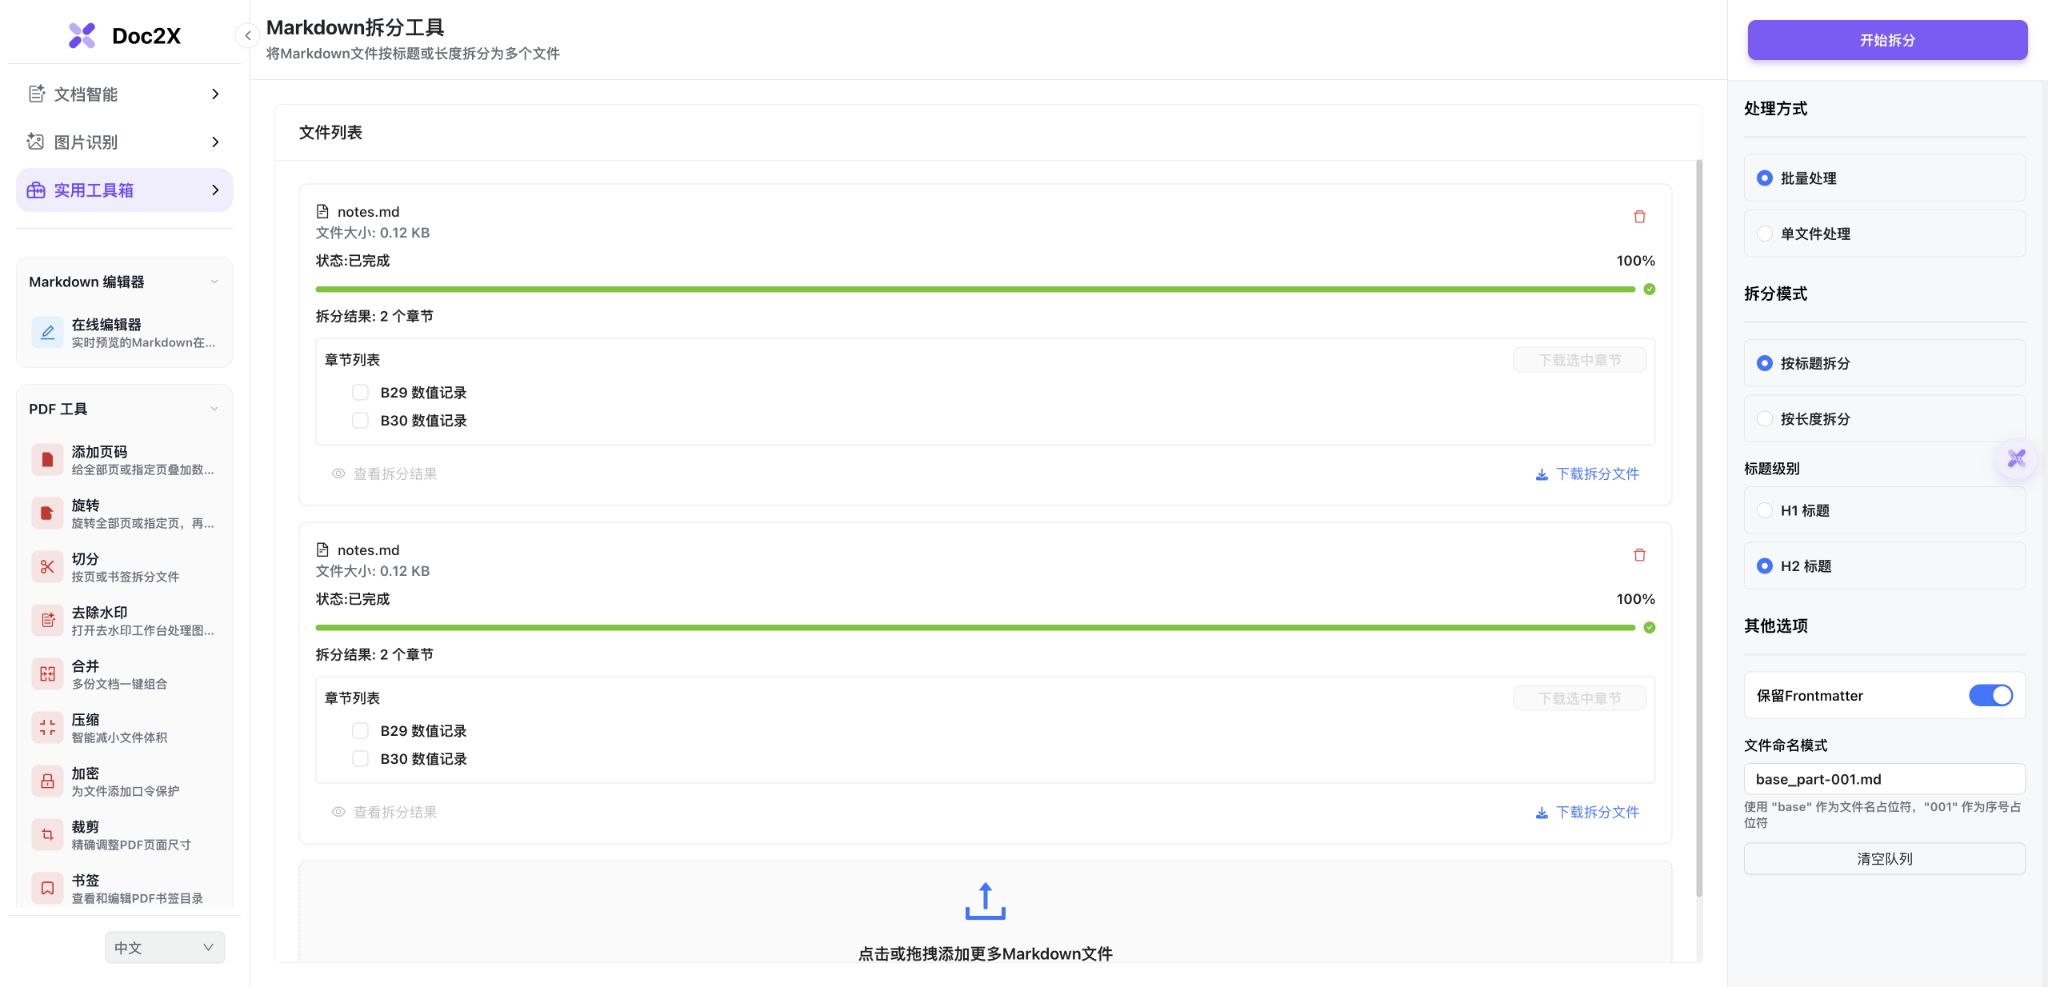
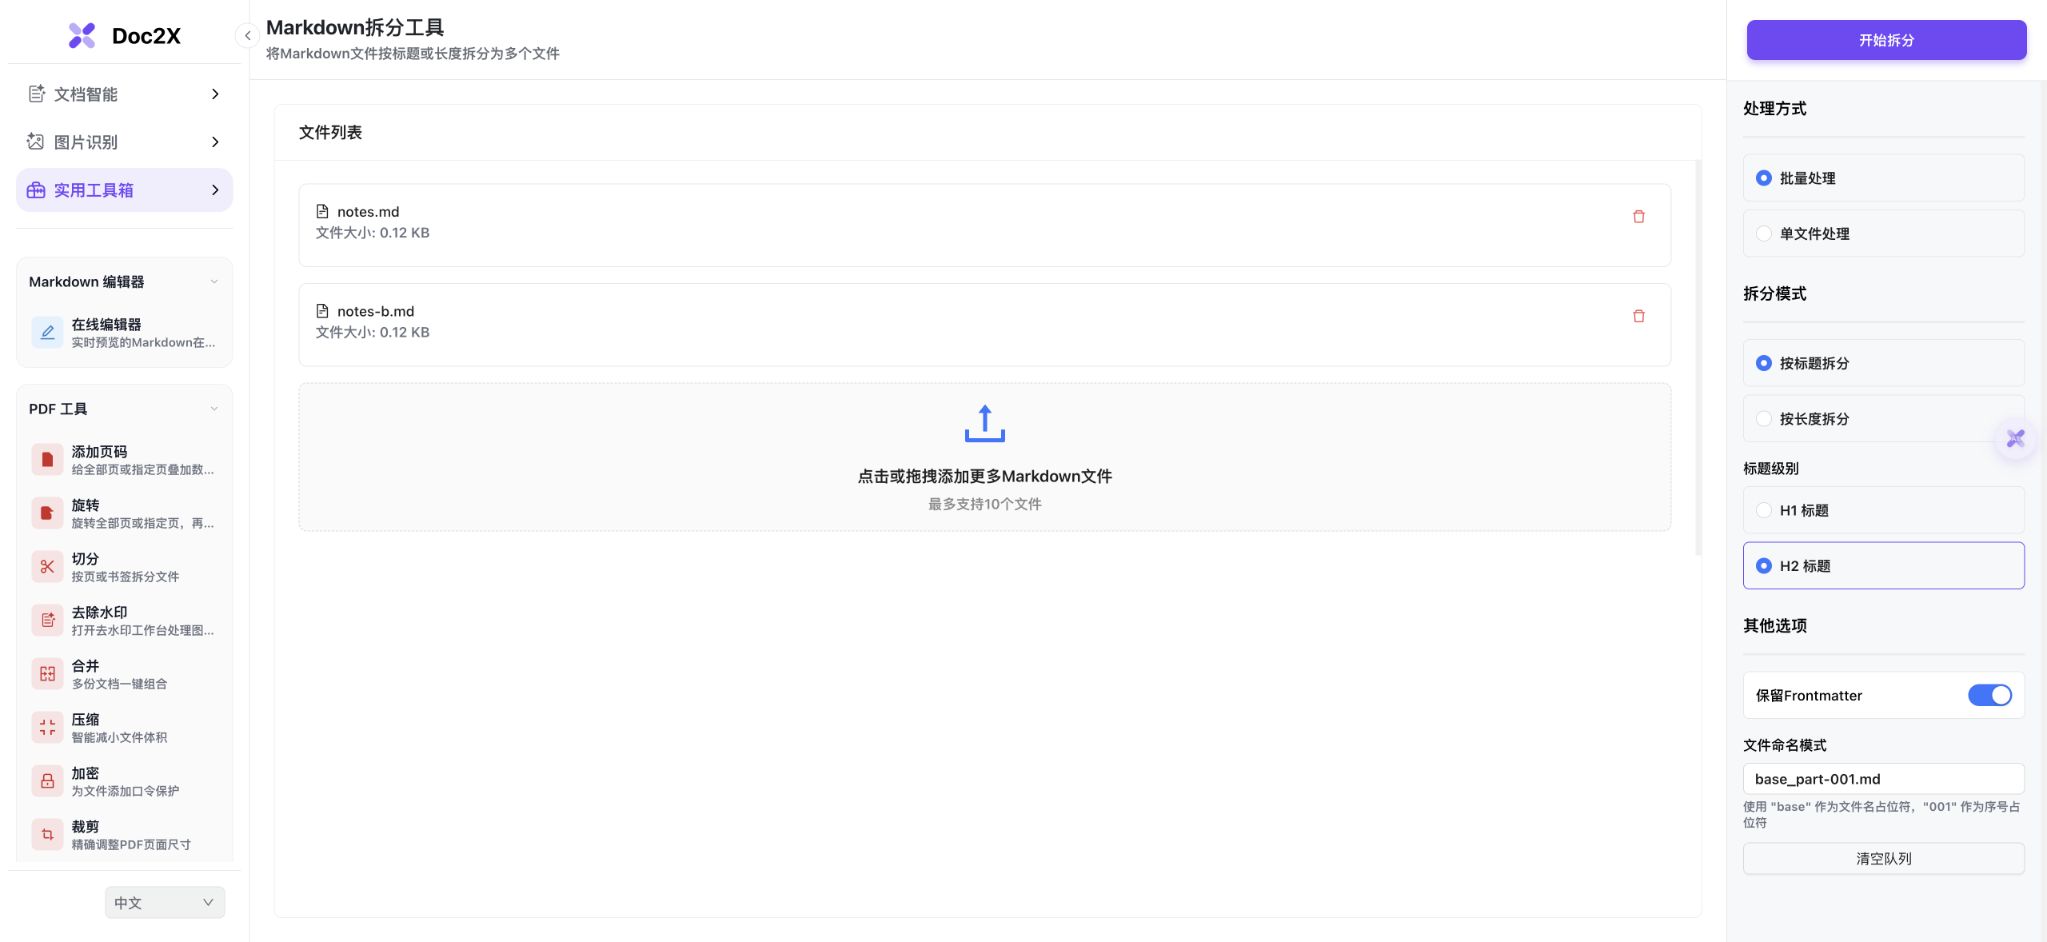
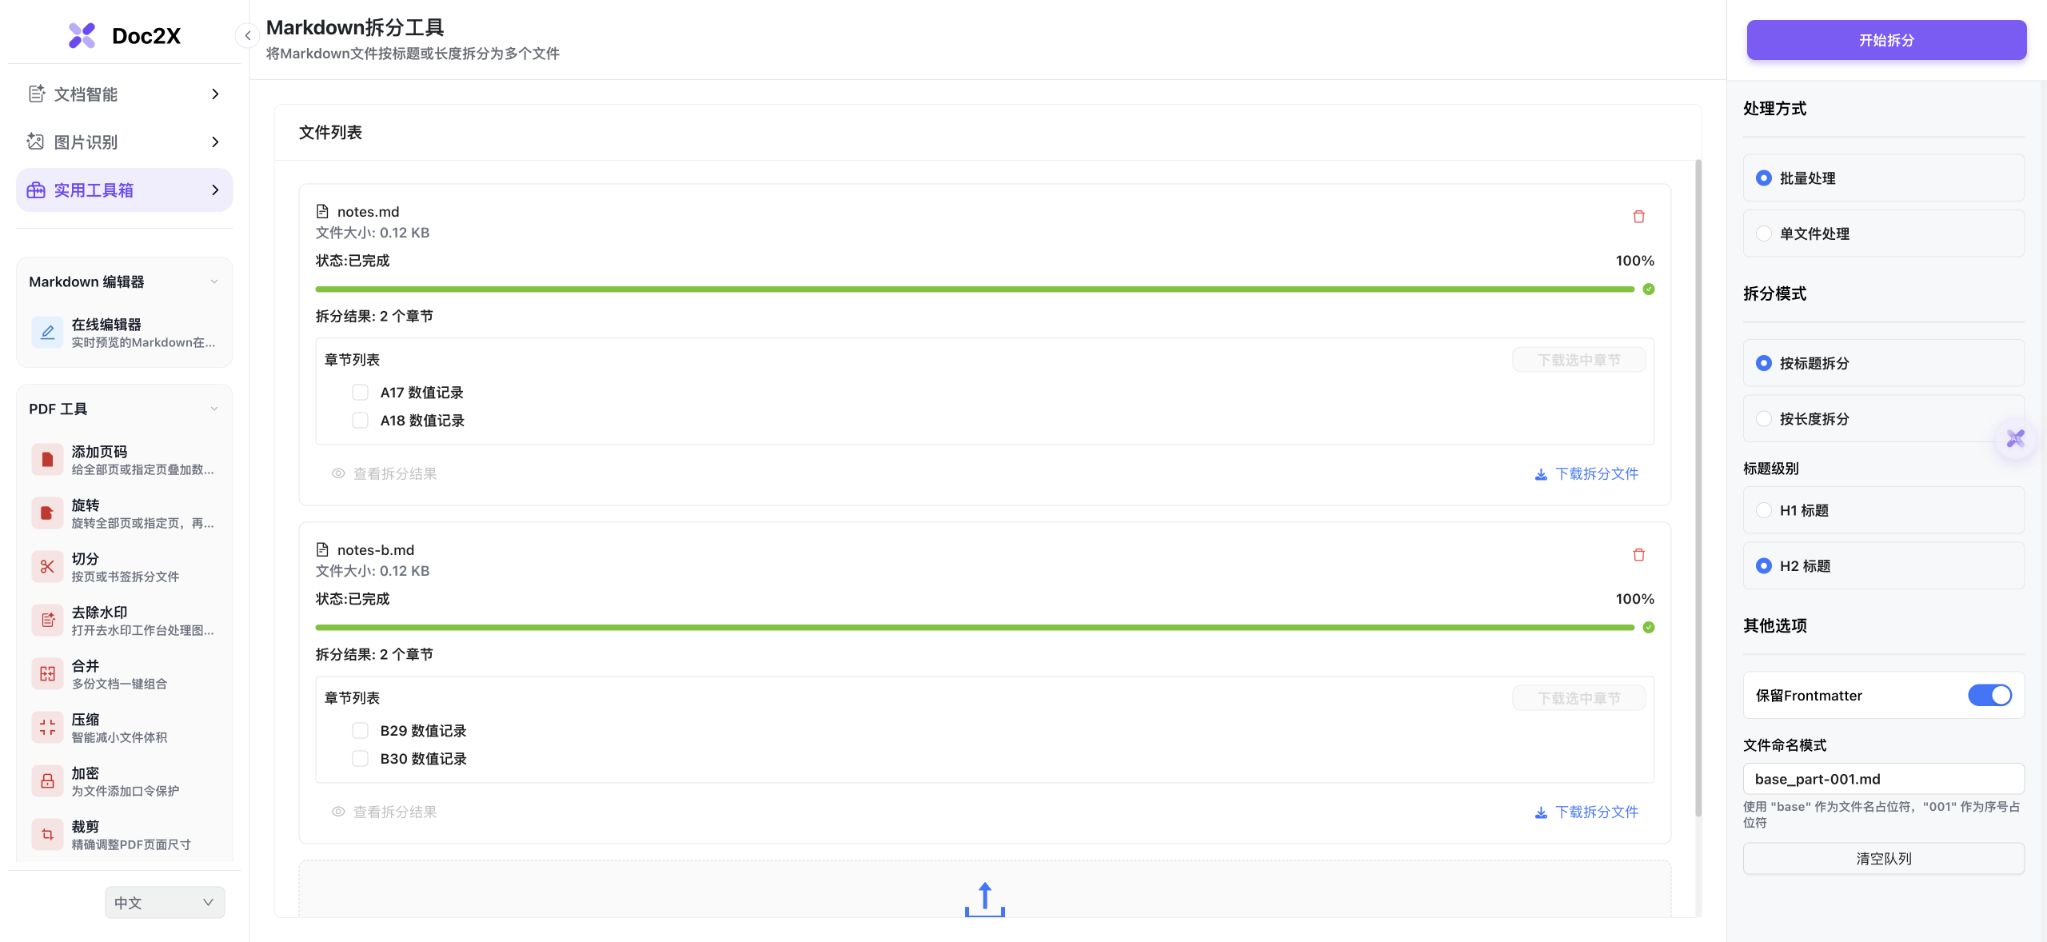
2026年10月20日,将两份正文不同但都叫notes.md的自编文件放入批量H2拆分。两张完成卡均显示B29、B30,分别下载的两份ZIP也完全相同,A的章节未出现在这两份结果里。随后保留A,将B复制为内容字节相同、仅改名notes-b.md的对照;在同样参数下重新处理,两个实际ZIP分别匹配A与B。
 查看原图 ↗
 查看原图 ↗
 查看原图 ↗
 查看原图 ↗
| 输入与运行 | 实际界面 | 原生下载核对 |
|---|---|---|
| 同名轮:A与B都叫notes.md | 两张完成卡都列B29、B30 | 两个366字节ZIP完全相同,各含2份MD,按序连接均匹配B;A17、A18未出现 |
| 改名对照:A为notes.md,B副本为notes-b.md | 卡1列A17、A18;卡2列B29、B30 | 366与374字节ZIP各含2份MD,分别按序连接匹配A及B副本 |
| B与改名副本 | 仅文件名改变,内容均124字节 | 字节相同;改名对照没有编辑或修复正文 |
两轮实际下载中的来源标记,不用卡片数量代替核对
同名轮两份ZIP:
卡1 → B29、B30
卡2 → B29、B30
A17、A18在这两份下载中均未出现。

仅改名对照:
notes.md   → A17、A18
notes-b.md → B29、B30- 保留两份实际原稿,先核对它们虽然同名,正文却分别有A17、A18与B29、B30标记。每份都含两个真实H2章节,没有YAML文件头。
- 两轮都用批量处理、按H2标题拆分、保留Frontmatter开启和相同命名模式。每轮只选入两份并开始一次,再分别点两张结果卡下载,共取得4份原生ZIP。
- 同名轮的两个实际ZIP字节完全相同,按序连接的正文都是B;A标记未出现。两次收到文件不能据此算作两份不同来源已保留。
- 改名对照只把B复制为notes-b.md,内容字节与B完全相同;第二轮实际ZIP分别匹配A和B副本。保留原稿后做的重命名准备,不是工具自动修复,也不能从缺少来源的下载中恢复原文。
- 解压后按来源、章节首尾、数值与顺序核对。原生ZIP保持下载字节,CSV和JSON是本地核对及范围说明;旧Token目标样例仍作为另一组实测保留。
只验证本次两份自编MD及B的等字节改名副本,两轮实际下载按来源分别核对。本轮没有修复产品,也不把重命名说成已缺失正文的恢复方法;其他文件、命名规则和批量情形需另验。
按材料结构选择拆分规则
| 你的目标 | 选择 | 下载后检查 |
|---|---|---|
| 每个二级标题独立成章 | H2 标题 | 第一份前言、H3 小节与每章末尾 |
| 只保留某一章 | 单文件处理 → 按大纲提取 | 是否只含选中章节;是否需要原文文件头 |
| 控制阅读片段的大致长度 | 按字符或参考 Token | 完整代码、表格、公式可能超过目标 |
| 每份保留一定数量的内容块 | 按内容块 | 标题、段落、表格、代码块等分别计数 |
H1、H2 与代码里的标题怎样区分
例如文稿用 # 课程笔记作总标题,## 第一章、## 第二章作章节,选择 H2 后按二级标题分章。第一份仍包含总标题前的前言;### 小节随章节保留。加粗的章节名不等于标题,代码围栏中演示的 ## 也不会成为新章节。先在源码里确认结构,再检查结果数量。
前言与 YAML 文件头分别保留
标题前的正文留在第一份结果。开启保留 Frontmatter 时,原始 YAML 文件头只进入第一份输出,关闭后移除文件头而保留正文前言。用大纲或勾选结果提取后一章时,可以把原文文件头带入第一份选中输出;直接导出则保存当前预览的分片内容。
ZIP、单个 MD 与文件名分别核对
批量处理里的下载拆分文件取得全部结果 ZIP;下载选中章节取得一份组合 MD。单文件处理里,勾选结果后批量下载 ZIP,或点选一份结果再导出当前预览。命名模式中 base 代表原文件名,001 代表序号;下载后解压,核对文件数量、排序与每份首尾。
按长度拆分,允许完整内容块超过目标
字符与参考 Token 用于设置大致长度。若一个代码块、表格、多行公式或段落本身已超过目标,会完整保留。按内容块则把标题、段落、表格、代码块等各计一块。参考 Token 使用 cl100k_base;送入其他模型前,应按目标模型重新计数,并留出提示词与回答空间。
图片与跨章引用要随文件一起整理
分章会保留 images/chart.png 这类路径,但不会自动下载原图或把图片收进 ZIP。解压后,把原图片放在相对路径对应的位置。脚注或引用的定义位于另一章时,需把所需定义一并带入;原稿中的跨章链接也应在目标编辑器逐个核对。
链接或脚注留在别章,下载后逐章检查
新增同源实测说明:两章接回去与原稿字节相同,第一章独立解释仍缺引用定义。关联指南提供原生ZIP和明确标注的本地修复副本,也区分本工具分段预览的作用域限制。
目标100仍会超出,先检查完整代码块
参考Token目标决定如何组合完整内容块,不会把一个过长的代码块强行截成100个Token。本例24条虚构记录放在同一text围栏中,下载后该片为377参考Token。我们保留原稿,在本地副本每3条记录处手工闭合、重新开启围栏并加空行,再按相同目标拆分;8份实际MD的本地参考计数为50–82。副本增加91字节,输入总数从427变为462参考Token,记录文字与顺序保持;这不是工具自动修复。需要更短时,先按内容意义整理可独立阅读的边界,再核对每份完整下载文件。送往其他模型前,应按目标模型计数,并留出提示词、请求包装和回答空间。
同名文件批量拆分,下载后按正文核对来源
两个结果卡片、两次下载,不等于两份来源都已分别保留。操作前先保存原稿,给来源清楚且有区别的文件名;处理后分别下载,核对章节首尾标记和原文,不只看文件名、结果卡数量或完成提示。重命名对照只改文件名,不改正文,也不代表工具自动修复或能恢复已经缺失的原文。
详细操作教程
按标题、长度或大纲提取片段,核对命名与打包结果。
遇到这些情况
- 结果数量与预期不符
- 检查选中的 H1/H2 是否与源码一致;加粗文字和代码块内的 # 不作为章节标题。
- 修改参数后旧结果消失
- 按新规则重新点击开始拆分,再下载对应结果。
- 某份超过目标 Token 或字符数
- 检查是否包含较长的完整内容块。需要更短时,在保留含义与结构的前提下手工整理原稿后再拆。
- 分片中的图片或脚注失效
- 补齐对应图片目录与必要的引用定义,并在目标编辑器检查链接。
常见问题
MD 分割就是添加 --- 分隔线吗?
分隔线通常只改变文档中的显示分隔。要取得多个 MD 文件,需要选择拆分规则并下载结果;本工具不把任意分隔线当作自定义切点。
拆分会把代码中的 ## 当成标题吗?
代码围栏中的标题写法保留在代码内,不作为章节边界。可用本页包含假标题的真实样稿检查。
拆分 ZIP 会带上图片吗?
不会自动收集图片。它保存拆分后的 Markdown 文本,图片引用仍依赖原资源;验证包中的配图是单独附上的输入资源。
分块后就能直接成为完整知识库吗?
分块只是准备语料的一步。还需保留来源、检查章节上下文、使用目标模型计数,并在自己的系统中建立索引与检索流程。
可以直接拆 PDF 吗?
本工具处理 Markdown。按 PDF 页码分割请使用 PDF 切分;需要按正文标题整理时,先把 PDF 解析为 MD,再核对结构。
Markdown参考Token目标100为什么仍超过100?
100是组合完整内容块时的参考目标。本例原稿拆为3份,完整文件的本地参考计数为30、377、20;中间的长text围栏包含全部24条记录,工具将它完整保留。应检查实际下载内容,不能把目标参数当作每片100的硬性保证。
MD按Token拆分会截断代码块吗?
本次原生下载保留完整围栏,没有为了凑100从长块中间截开;长块本身为377参考Token。对于必须保持为一体的程序、表格或公式,不应为了数字机械插入切点。本例围栏里是虚构文本记录,不是可执行程序。
Markdown长代码块怎样手工拆成小块?
保留原稿,在可独立阅读的语义边界上手工闭合并重新开启围栏,再把本地副本重新选入工具。本例每3条虚构记录分成一个text围栏,共8个,记录文字与顺序未改;实际8片为82、50、51、51、53、52、52、71参考Token。这是人工整理后的本样例结果,不是自动修复或任意输入的100硬上限。
Markdown拆分后怎样核对每片Token?
下载ZIP后逐份计算实际MD的完整内容,包括围栏、首尾与换行。本页用与工具一致的@dqbd/tiktoken 1.0.22、cl100k_base及encoding.encode(text).length进行本地核对,CSV是本地记录,不是产品原生导出。不同模型和请求包装可能改变总量,使用前还应按目标模型重新核对。
Markdown批量拆分同名文件会覆盖结果吗?
本轮同名对照中,两份输入都叫notes.md,两张结果卡都显示B29、B30;分别下载的两个ZIP也完全相同,内容都匹配B,A17、A18未出现在这两份下载里。这个具体结果不能推广为所有批量文件;不要只凭卡片完成状态确认来源齐全。
MD批量拆分只显示一份结果怎么办?
先保留实际输入与已经下载的文件,分别核对来源标记、章节标题和全文。结果卡数量不是原文覆盖证明;需要重试时,在原稿副本中使用不同文件名,并再次核对最终下载内容。本例两张卡仍各能下载,但同名轮的两份实际内容都属于B;先核对正文来源。
Markdown拆分多个文件怎样核对来源?
给每份原稿保留可追踪的来源标记或清楚的文件名,处理后逐份检查下载ZIP里的成员、章节首尾与全文。相同文件名或相同输出名都不能替代内容核对;已保存原稿是确认来源的依据。
MD拆分前重命名怎样保留原文对照?
保留原始文件,另复制一份只改文件名;记录新旧文件名与内容字节的对应关系,再放入同一参数的批量流程。本例重命名B的对照内容必须与原B一致,不能把顺手改写正文当作只改名字的实测。
内容核对:2026-10-20 · 功能条件与配额以当前产品界面为准