
本页内容
按书页边界处理,再检查实际成品
- 打开扫描增强,登录并查看当前额度,添加照片。导入会自动处理当前页,先检查结果是否框住整本书。
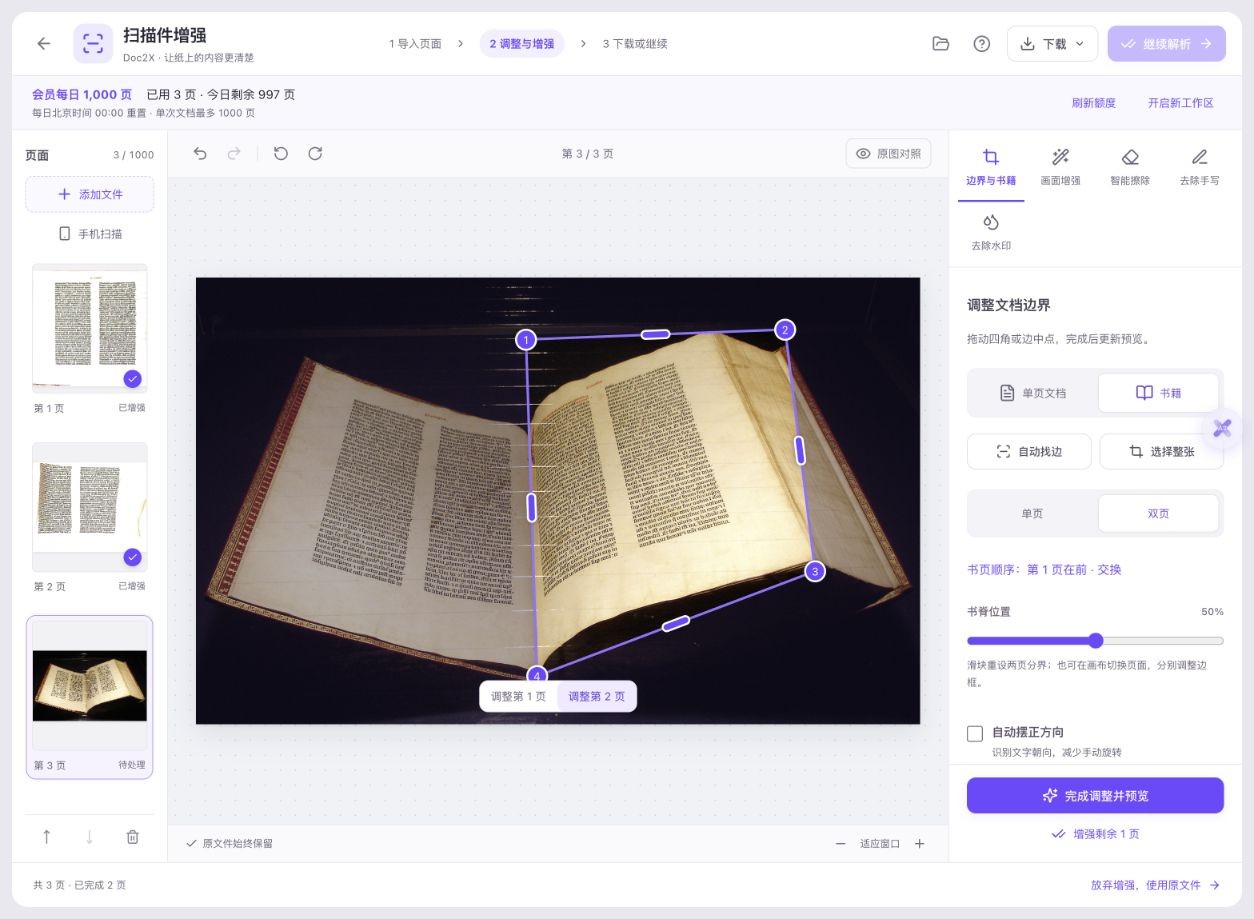
- 切到边界与书籍,选择书籍与双页。若原来的检测只包含一页,先选择整张,再建立双页范围。
- 按书脊检查分界,切换调整第1页与第2页,分别移动四角。四角直线可能切过弯曲纸面的上缘,宁可先留多一些背景。
- 按材料选择曲面矫正、滤镜与方向。本例保持智能增强与曲面选项开启,关闭自动摆正方向;界面提示没有发现明显纸面曲线。
- 完成调整并预览,分别查看两页。核对首行、页眉、末行、书脊小字、左右顺序与反光,发现裁掉内容时回到原图调整。
- 下载 PDF 或全部图片 ZIP,再打开实际文件检查。需要可编辑文字时继续解析,增强结果本身不等于 OCR 完成。
本例未运行 OCR 或翻译。照片经过玻璃拍摄,反光与曲面都影响结果,不能据此保证任意书页完全拉平。
同一张真实书籍照片:先找回被裁掉的标题
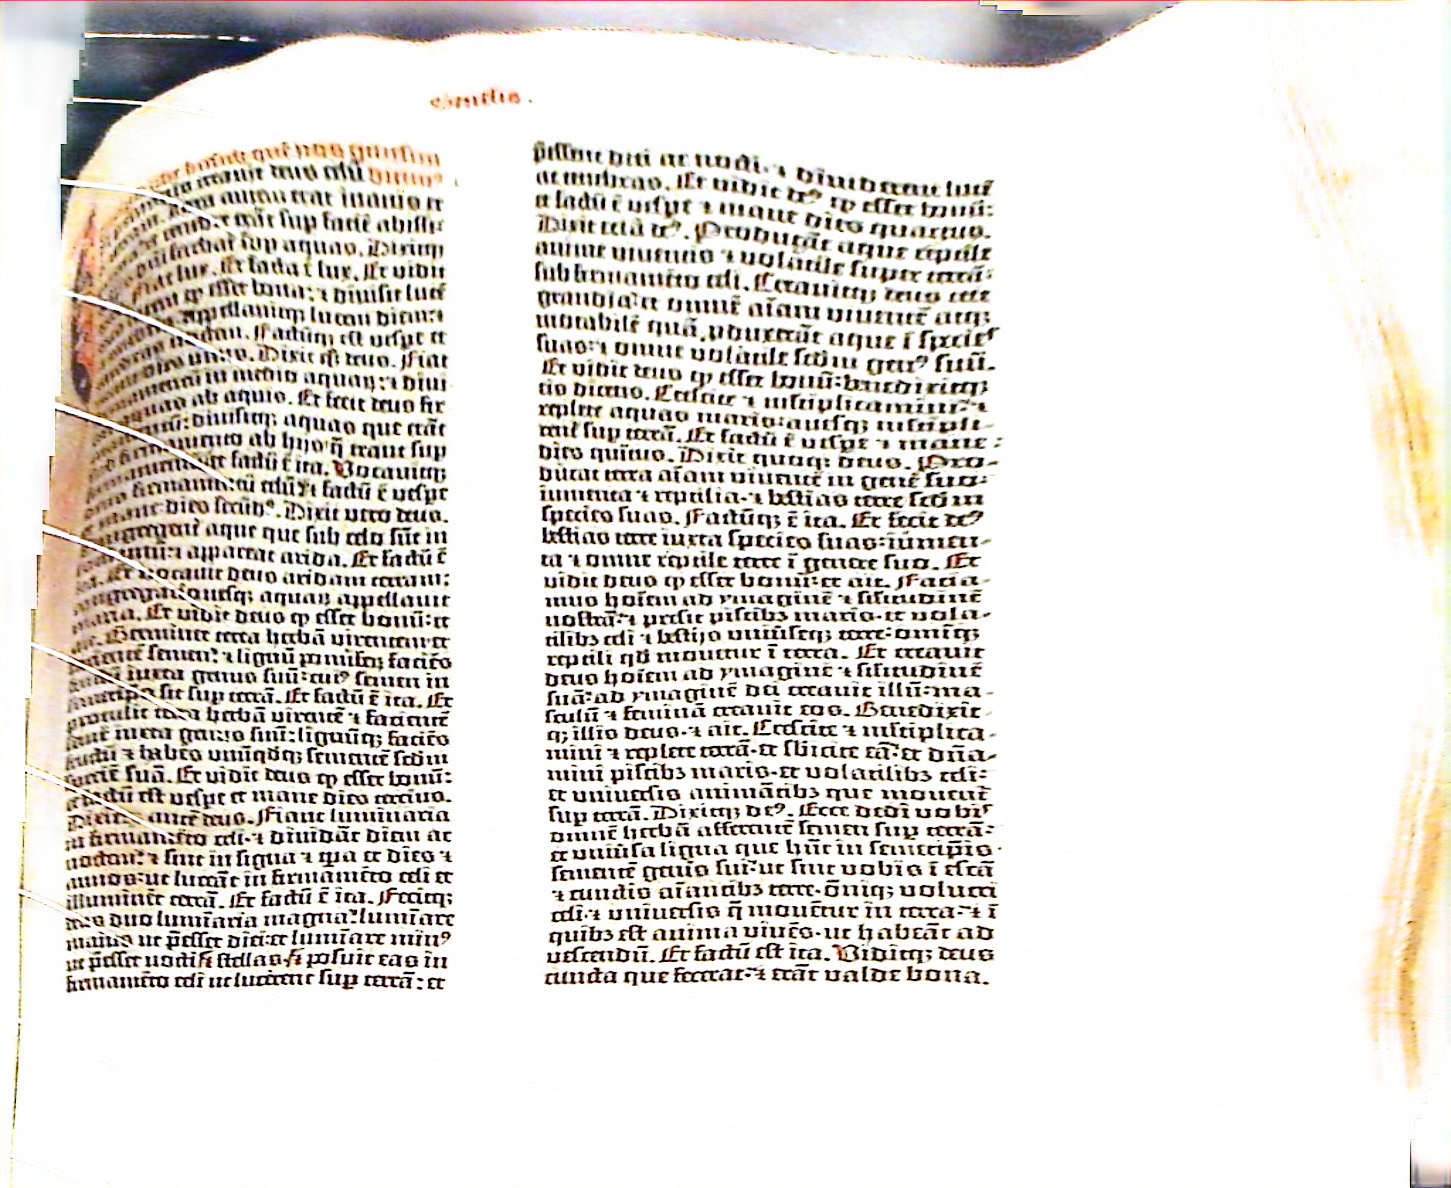
2026-10-14,在当前扫描工作台上传一张公开授权的古籍双页照片,进行两轮手动拆页与增强。首轮右页的直线上缘切过弯曲纸面;第二轮从原图重新放宽边界,标题重新出现。以下图片均保留实际下载字节。
| 下载页序 | 对应页面 | 像素宽 × 高 |
|---|---|---|
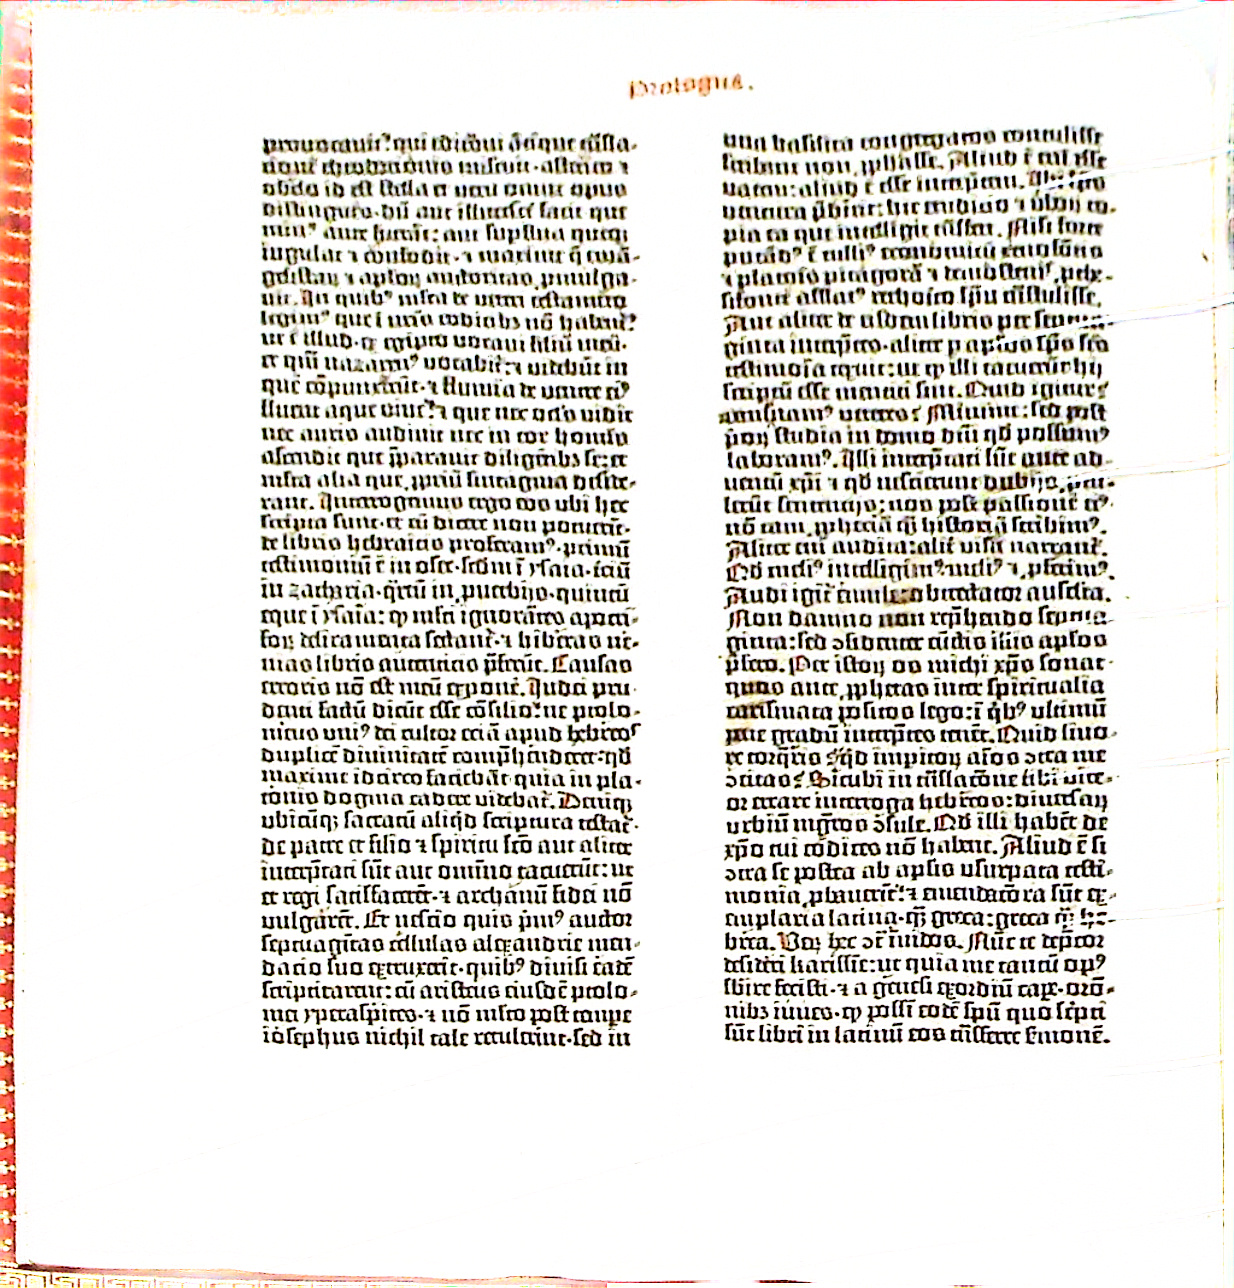
| 1 | 首轮左页 | 1190 × 1208 |
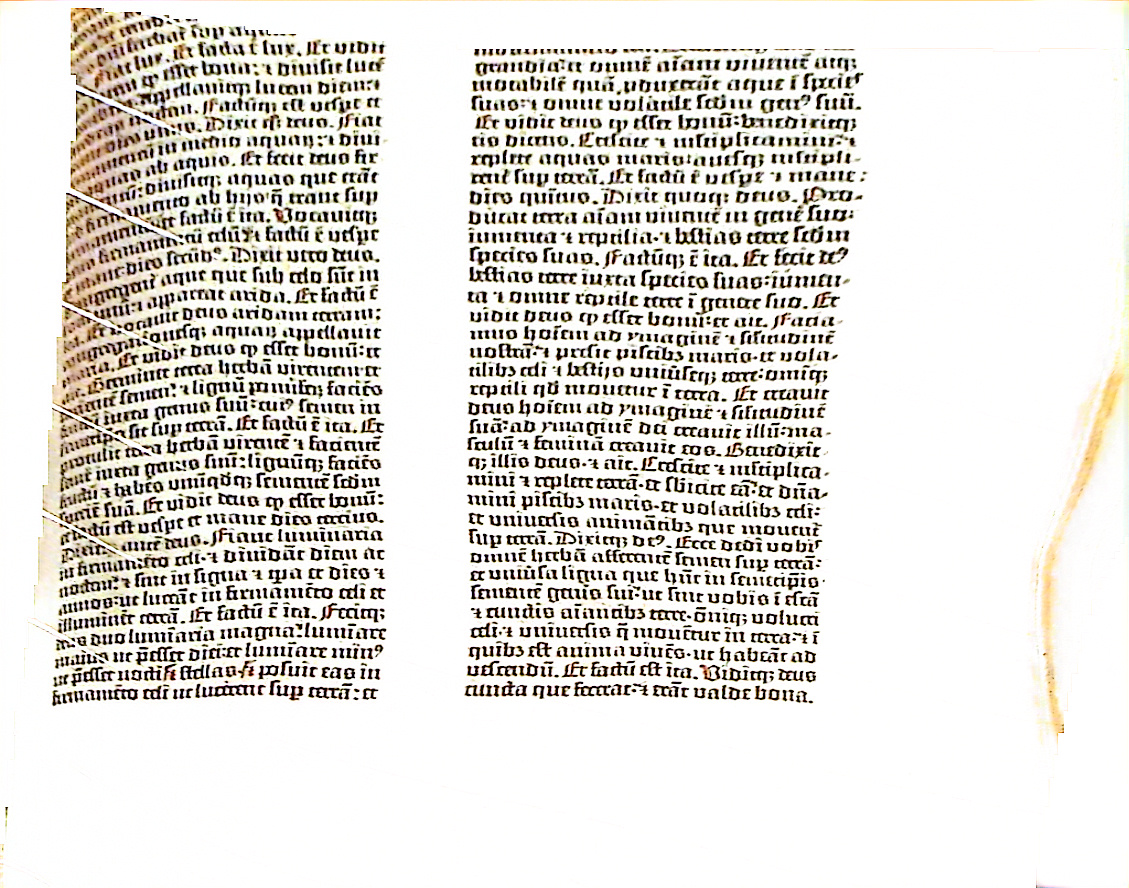
| 2 | 首轮右页:顶部裁切 | 1129 × 888 |
| 3 | 第二轮左页 | 1234 × 1288 |
| 4 | 第二轮右页:放宽上缘 | 1451 × 1188 |
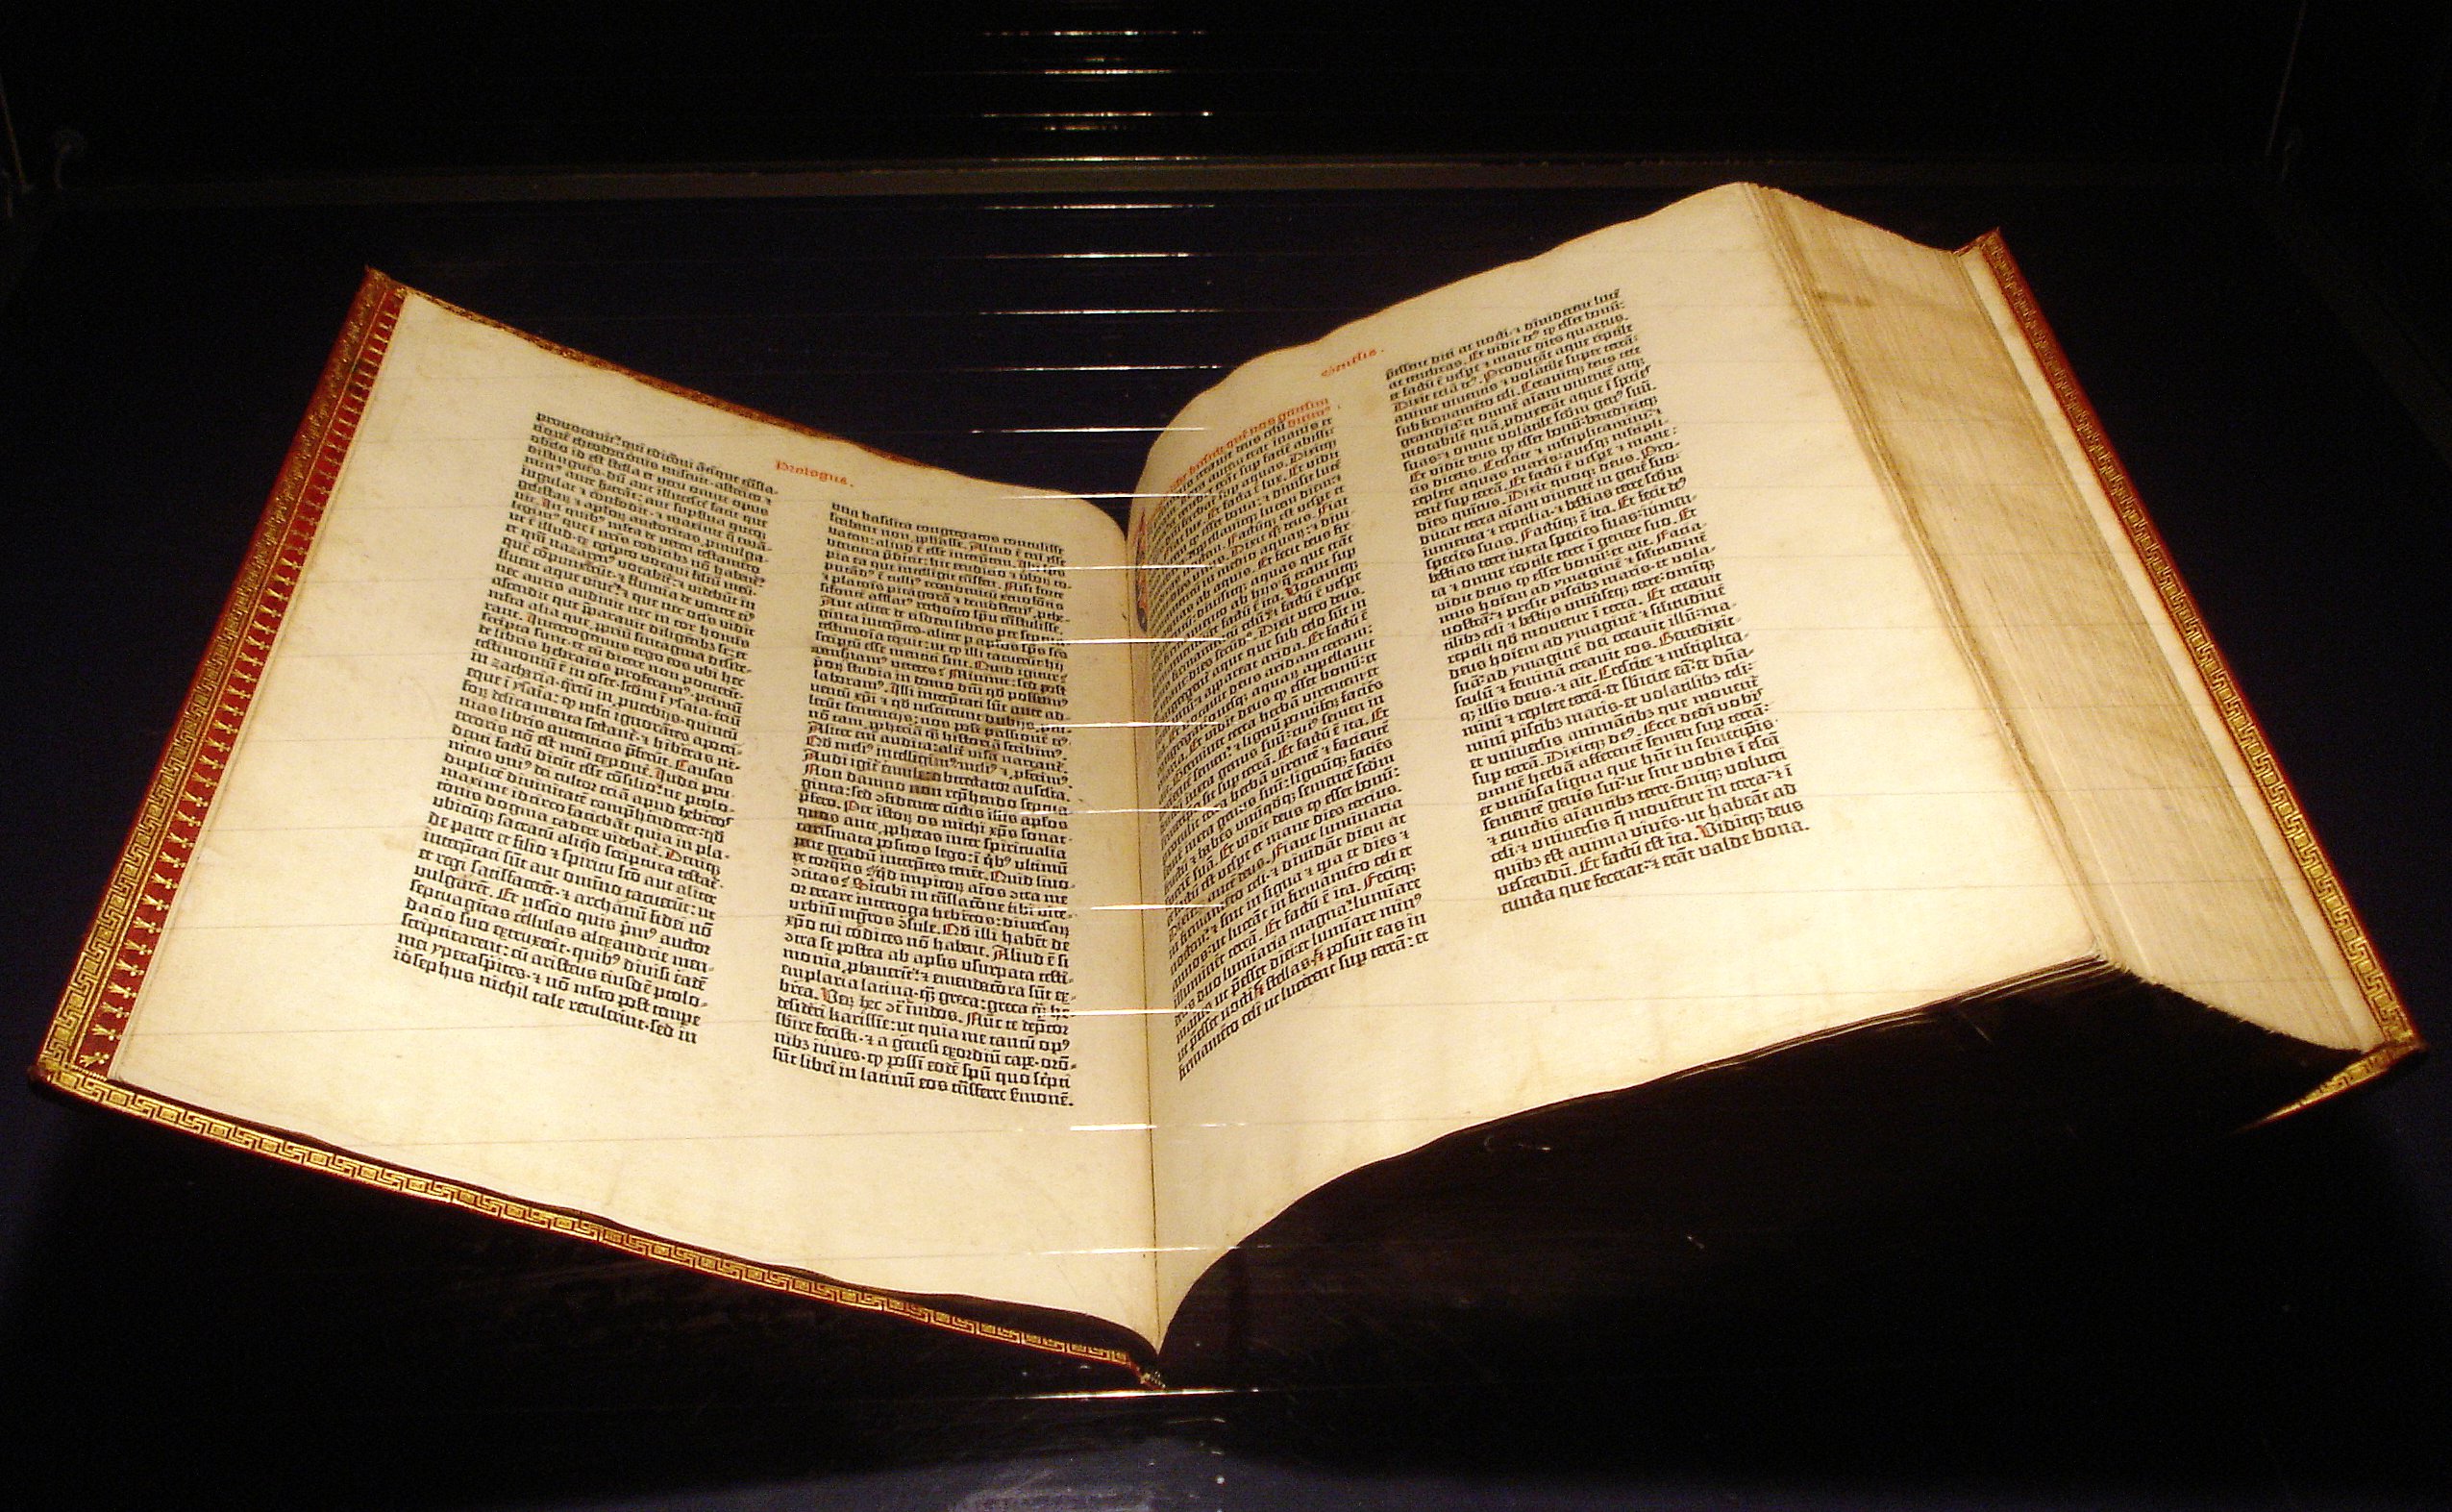
- 原图是 2551 × 1573 的真实照片。首次自动找边只框住左页,切换书籍双页后,必须分别检查两个选区。
- 首轮右页标题有裁切。重新导入原图、选择整张并放宽右页上缘后,标题重新进入下载范围,但带入了一部分黑色背景。
- 第二轮两页仍有反光、字形变形与局部弯曲。此例证明了拆页和边界调整的作用,没有证明每个字符都完整或曲面已经完全恢复。
- 原生 PDF 共四页,分别内嵌 ZIP 中对应 JPG 的相同字节,且没有文字层。前两页是首轮,后两页是第二轮,不是四张不同原稿。
照片:Antonio Zugaldia,2007 年,Gutenberg Bible Mainz Copy,CC BY 2.0。原图未经改写;本页成品为该照片经 Doc2X 裁边、拆页与增强后的衍生图,截图包含同一照片。 本例保持曲面选项开启,但检测提示未发现明显纸面曲线;不能把四角裁边后的结果归因于成功的曲面重建。没有改写成品、补画文字或发起 OCR。核对包由本地整理,原生 PDF 与 ZIP 另行提供。
先了解这几件事
打开扫描增强,选择“边界与书籍 → 书籍 → 双页”,按真实书脊检查分界,再切换两页分别调整边框。曲面矫正用于适合的弯曲页面;若提示未发现明显纸面曲线,仍需核对四角结果。先保留完整文字,再追求背景整洁,不能只看“已增强”。
- 双页拆分
- 一张左右展开的书籍照片,可以按两页边界生成独立页面。
- 边界与曲面
- 四角调整决定保留范围;曲面选项开启不代表每张照片都检测到了曲线。
- 本次结果
- 两轮各两页,下载保留为四页 PDF 与四张 JPG,便于对照。
- 继续识别
- 增强先得到页面图像;要复制文字、搜索或编辑 Word,需另行解析。
在画布切换两页,分别检查四个边角
右页上方是弯曲轮廓,四角连成的直线不能自动贴合每一处曲线。第二轮把上缘放宽,先保留标题,再查看生成结果。
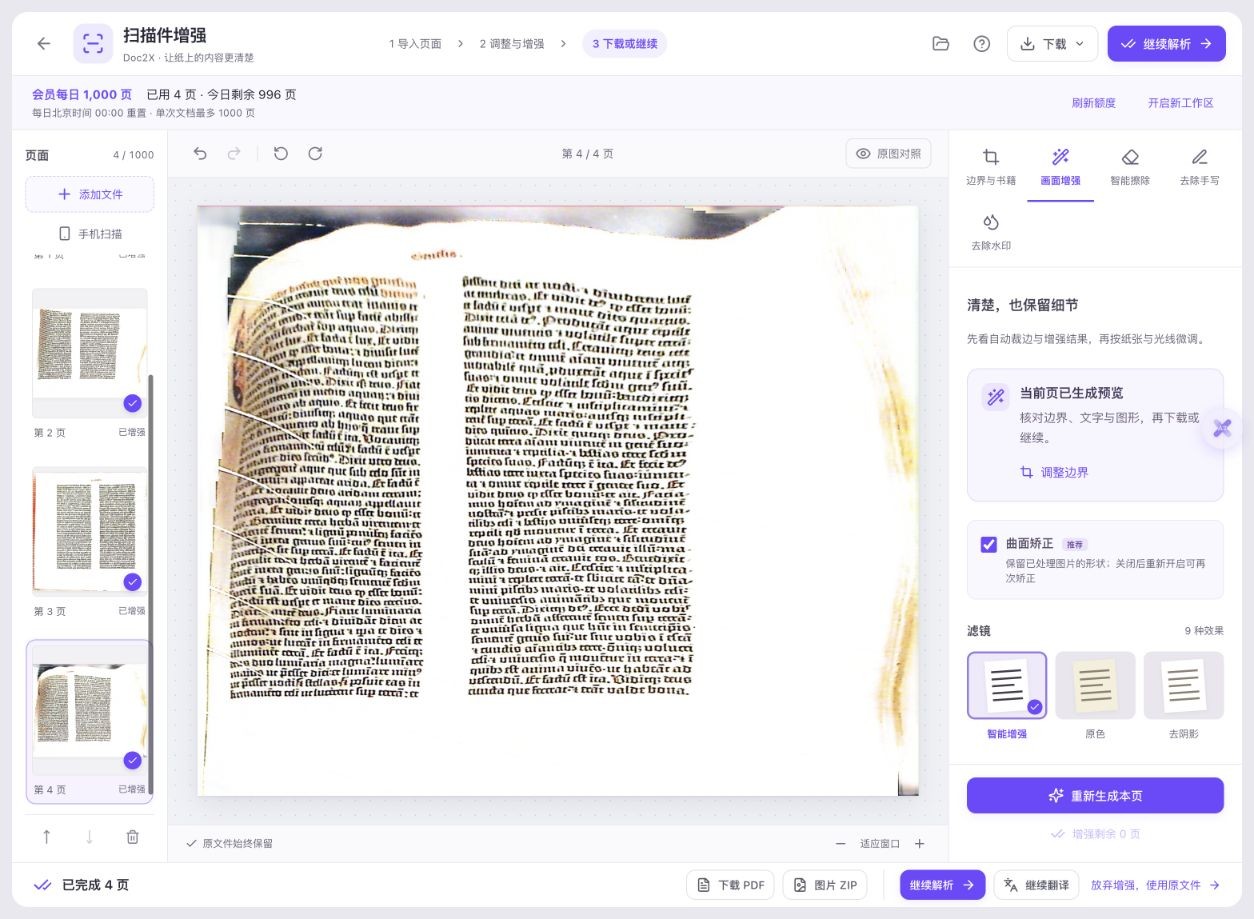
- 书脊滑块显示50%不代表手动边框仍严格在图像中线;分别核对画布里的两页实际范围。
- 本次关闭自动摆正方向,保留当前文字朝向;双页生成后的缩略图顺序与下载页序分别检查。
照片:Antonio Zugaldia,2007 年,Gutenberg Bible Mainz Copy,CC BY 2.0。原图未经改写;本页成品为该照片经 Doc2X 裁边、拆页与增强后的衍生图,截图包含同一照片。 截图来自实际操作,只转换为 JPEG 以便展示。
先判断需要修正什么
| 现象 | 先处理 | 核对重点 |
|---|---|---|
| 一张照片含左右两页 | 书籍 → 双页,检查书脊与两页边框 | 左右顺序、标题与靠书脊的文字 |
| 普通平面纸张倾斜 | 单页四角调整 | 完整四边与文字方向 |
| 书脊附近弯曲 | 检查曲面选项与检测提示 | 不要把开启选项当作完全展平 |
| 玻璃反光遮住文字 | 优先寻找无反光原图或重拍 | 增强不能保证恢复被遮挡文字 |
| 下载后不能复制文字 | 继续解析并核对文字结果 | 图片 PDF 与可搜索 PDF 不同 |
自动找边之后,仍要看是不是整张书页
本例自动检测优先框住了左页。直接切到双页时,分界仍在原范围内;第二轮先选择整张再设置书籍双页,随后分别调整左右页。不要把按钮名称当作已经正确识别书脊的保证。
沿着弯曲上缘裁得太紧,可能切掉标题
右页上缘不是一条直线。首轮四角选区虽然靠近纸面,直线却穿过标题附近;第二轮放宽后标题重新可见。保留背景与裁掉内容是不同取舍,先确保必要内容进入输出。
曲面矫正与四角矫正各自检查
曲面矫正尝试处理适合的书页弯曲;检测不到曲线时,界面允许继续四角矫正。本例出现了该提示,不能只因成品更像矩形,就宣称完成了曲面拉平。检查文字基线、字符形状与靠近书脊的区域。
亮度改善不会消除所有反光
本例智能增强让背景更白,但玻璃形成的横向亮线仍存在,部分字形仍有变化。严重失焦、反光或遮挡应优先换清晰原稿或重拍,不用生成细节替代原本的文字。
从原图重新检查,比继续裁成品更可靠
首轮已缺失的顶部不能靠在成品上扩大选区找回。本次重新导入原图做第二轮,并保留前两页用于对照;实际下载四页依次为首轮左/右、第二轮左/右。处理自己的材料时,也应保留原文件。
书页增强完成后,再决定是否 OCR
当前 PDF 保存的是四张页面图像,没有文字层。只需保存画面可下载使用;需要复制、搜索、翻译或编辑 Word 时,再继续解析,并按古籍字形、语言与拍摄质量核对识别结果。
遇到这些情况
- 右页标题缺了一部分
- 回到原始照片检查上缘,不只盯四个角;弯曲边缘可能被四角直线切过。
- 开启双页后,两个框都落在左页
- 核对初始检测范围,必要时先选择整张,再切换两页分别调整。
- 曲面选项开着,但仍弯曲
- 查看检测提示和实际结果;本例没有发现明确曲线,不把开关状态当效果保证。
- 生成后左右页顺序不符合原书
- 生成前检查书页顺序,下载后再次按标题与页码核对;本例没有验证所有阅读方向的自动判断。
常见问题
一张书本照片可以拆成两页吗?
在书籍模式选择双页并核对两页边框。本例同一照片每轮实际生成两页 JPG,最终保留两轮共四页供对照。
书本扫描图片能保证完全拉平吗?
不能用本例作这种保证。本次曲面检测没有发现明显曲线,结果仍有弯曲与反光;需要根据实际书页判断,必要时调整拍摄条件。
曲面矫正开着,为什么还要调边界?
选区决定哪些内容进入输出,曲面选项不能挽回被选区裁掉的标题。两项都要对照原图检查。
下载的增强 PDF 可以直接搜索文字吗?
本例没有文字层,只有页面图片。搜索和复制需要另行识别,并检查实际文字结果。
内容核对:2026-10-14 · 功能条件与配额以当前产品界面为准