
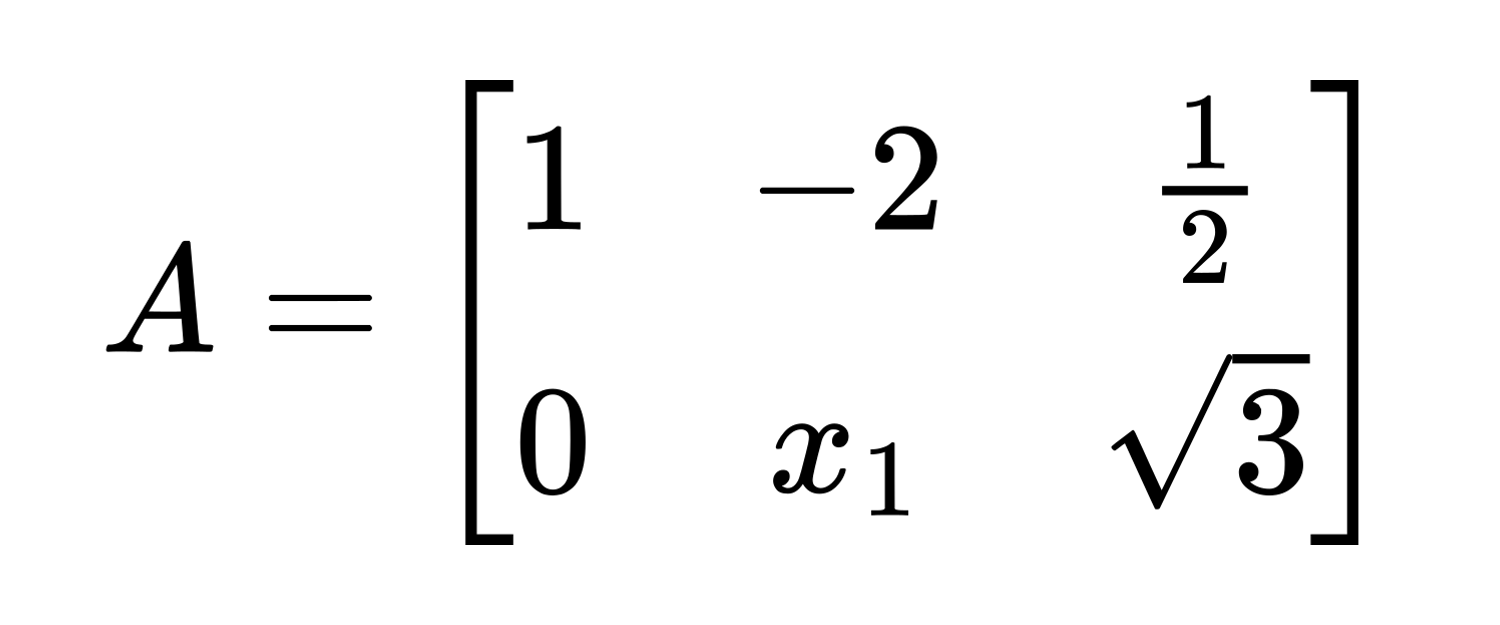
本页内容
矩阵公式识别后,按行核对再导出
- 保留原图,确认方括号、每行元素和上下标没有被裁掉。本例有两行三列,包含负号、分式、下标和根号。
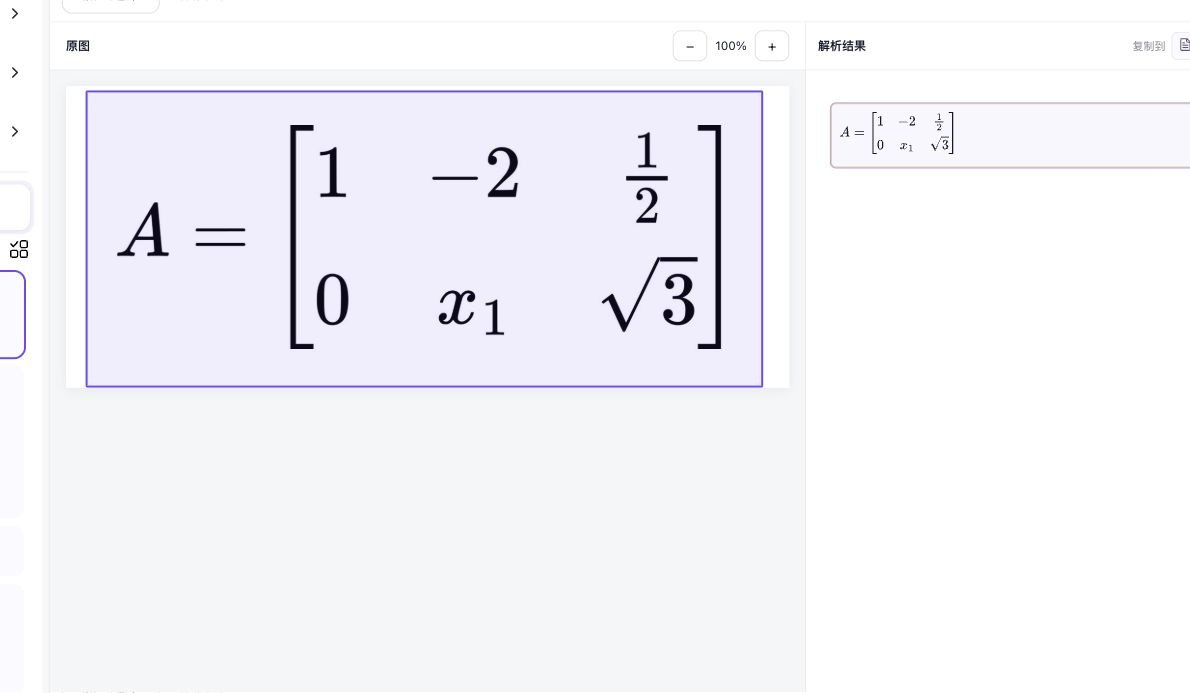
- 进入图片公式识别,选择PNG,在图片识别选项确认开始解析。本例只识别一次,没有扫描增强、切换模型或人工改写结果。
- 先数行列,再从左到右逐格对照原图。本例依次核对1、-2、1/2、0、x下标1和根号3,不能只看是否生成了一个括号。
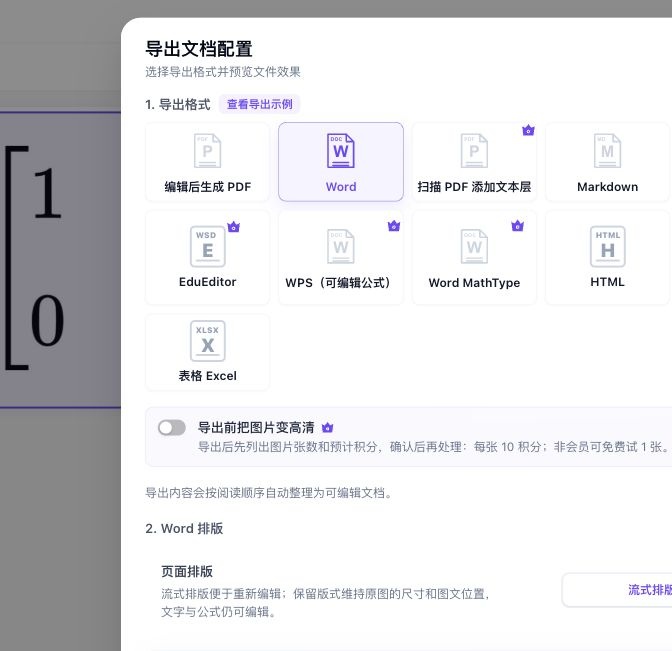
- 点击导出文档,选择需要的LaTeX或Word。本例Word使用流式排版,另从同一识别结果导出LaTeX ZIP,没有重新识别。
- 检查实际文件。解压LaTeX后核对matrix环境的行和元素;在Word打开成品,查看两行三列、分式、下标与根号。本例未测试矩阵单元格编辑或整份TeX编译。
本例是清晰自编数字公式,不代表手写、实拍或模糊图片的准确率。数学矩阵与普通数据表格分别处理。
同一个2×3矩阵:原图、识别结果与两种实际文件
2026年10月16日,用本地MathJax排版的自编公式PNG上传识别一次,模型显示doc2x,未人工改写。随后从同一结果分别下载Word与LaTeX ZIP,核对文件结构,并实际用Microsoft Word for Mac打开DOCX。
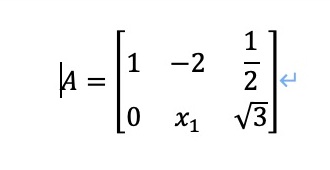
| 原图位置 | 应有内容 | 本次文件核对 |
|---|---|---|
| 第1行第1列 | 1 | TeX与Word矩阵第一格为1 |
| 第1行第2列 | -2 | 负号与2在同一格 |
| 第1行第3列 | 1/2 | Word为分式结构,TeX为frac |
| 第2行第1列 | 0 | 第二行第一格为0 |
| 第2行第2列 | x下标1 | Word保留下标结构 |
| 第2行第3列 | 根号3 | Word保留根式结构 |
实际识别段落原文,未人工改写
\( A = \left\lbrack \begin{matrix} 1 & - 2 & \frac{1}{2} \\ 0 & {x}_1 & \sqrt{3} \end{matrix}\right\rbrack \)- 输入PNG为36,424字节,识别段落保持版本0。原图参考源码用于制作输入,与实际识别段落、实际导出TeX分别提供。
- 原LaTeX ZIP为978字节,包含一个TeX和空images目录。TeX的matrix环境为两行,每行三个元素,没有靠本地补行或补列修正。
- 实际Word为12,697字节,含一个Office数学对象、一个两行三列矩阵;右上为分式,中下为下标,右下为根式,没有将矩阵作为嵌入图片。
- Microsoft Word for Mac实际打开一页,六个元素与结构显示正确;查看后未编辑或保存。普通文本提取中的12、x1不能单独代替分式与下标结构核对。
单个清晰自编图的流程示例,不是手写、实拍或模型准确率测试。已核对实际下载文件及Word显示,未验证剪贴板内容、矩阵编辑、WPS、MathType或整份TeX编译。截图仅裁剪或转JPEG,未重绘;核对ZIP由本地整理,原生LaTeX ZIP另行提供。
先了解这几件事
矩阵图片转LaTeX或Word,不只看符号是否像原图,还要检查二维行列关系。先上传完整矩阵图,按行逐格核对,再导出需要的格式。本例两行三列和六个元素均保留;实际Word中是原生数学矩阵,分式、下标与根号仍有对应结构,LaTeX文件也保留同样的元素顺序。
- 原图
- 自编清晰数字PNG,1500×625,2行3列。
- 识别
- 界面模型为doc2x,版本0,未手动修改。
- LaTeX
- 实际978字节ZIP,含1,369字节TeX。
- Word
- 实际12,697字节DOCX,含1个原生矩阵。
矩阵识别后,先判断要核对什么
| 观察或用途 | 检查内容 | 本例结论 |
|---|---|---|
| 矩阵看起来像原图 | 先数行和列,再看各格顺序 | 两行三列、六格对应 |
| 负号、分式或下标相近 | 检查符号归属与数学层次 | 负2、1/2、x下标1分别保留 |
| 提取Word文本出现12或x1 | 回到公式结构和实际显示 | 本例仍为分式与下标,不是只剩普通文字 |
| 要继续写LaTeX工程 | 区分数学片段与完整导言区 | 原TeX含fontspec等环境要求,未测试编译 |
| 需要Excel单元格 | 先判断结果是公式还是表格 | 本例为数学矩阵,未导出Excel表格 |
矩阵识别行列,先看二维位置
本例六个元素的次序相同,还要确认它们分成两行、每行三格。尤其是零、负号和分式相邻时,不能只按拼接出来的字符判断;逐行对照原图与实际成品。
矩阵负号、分式与下标分别核对
第一行第二格为负2,第三格才是二分之一;第二行中间为x下标1,右边为根号3。本次TeX与Word结构均保留这些关系,不由此推断所有复杂矩阵、手写或模糊图也会相同。
分式提取成12,不等于Word显示错误
纯文本提取会按顺序拼接分子与分母,也可能把下标接在变量后。本例提取能看到12、x1,但文件内分别有分式与下标对象,Word实际显示仍为1/2和下标。结构、字符与视觉结果应结合检查。
矩阵图片转Word,确认得到的是哪种对象
本次DOCX有原生数学矩阵,没有嵌入矩阵图片,也不是普通Word表格。已打开核对显示,但未尝试修改单元格;需要在特定Word、WPS或MathType中继续编辑时,仍要用自己的环境试验。
LaTeX矩阵片段与完整文稿分开使用
本次实际导出TeX含文档类、字体和宏包配置;它与只复制一条数学片段不同。已有工程可先核对实际识别段落和数学定界,再按自己的导言处理。这里没有把内容核对写成整份TeX已通过编译。
数学矩阵与表格识别不是同一结果
矩阵保留的是数学表达与二维排列;数据表需要表头、行列与可计算单元格。本例导出的Word是数学对象,LaTeX也是matrix环境,不把它描述成已经取得Excel工作表。
常见问题
矩阵图片怎么转LaTeX?
上传完整矩阵图片,识别后核对行列与元素,再导出LaTeX。本例实际ZIP和解出的TeX均可下载,matrix环境保持两行三列。
矩阵截图转Word,结果还是图片吗?
本次实际DOCX不是嵌入矩阵图片,而是一个Office数学对象中的两行三列矩阵。Word打开显示已核对,后续编辑兼容性还需在自己的软件中测试。
矩阵识别后怎么检查有没有少一列?
先数原图行列,再按行逐格比对。需要文件时也检查实际TeX或Word;本例两行各有三个元素,分式、下标和根号分别落在原位置。
矩阵分式从Word提取成12,是识别错了吗?
不一定。本例纯文本拼接出现12,但Word文件里是分式对象,实际显示为二分之一。先检查数学结构与Word显示,不只依据普通文本提取。
这份TeX可以直接保证在Overleaf编译吗?
不能这样保证。原导出含fontspec和字体配置,本轮核对了矩阵内容,没有验证整份文稿编译。请按自己的引擎、字体与宏包环境检查。
这个例子能说明手写矩阵的准确率吗?
不能。输入是清晰、自编的数字公式PNG,没有手写、反光、倾斜或模糊。自己的图片应先用代表样例验证,并对照原式逐格复核。
内容核对:2026-10-16 · 功能条件与配额以当前产品界面为准