
本页内容
Word 批量提取图片,先在副本中操作
- 保留原DOCX,复制一份放到新的空目录。旧DOC先在原办公软件另存为DOCX并打开核对,单改后缀不转换格式。
- 把副本的完整扩展名.docx改为.zip,用能读取ZIP的解压工具打开,选择独立的输出目录;不要覆盖唯一原稿。
- 进入解包后的word/media目录,检查其中的文件。本例是rId21.png和rId25.png;别根据名字猜图号或正文顺序。
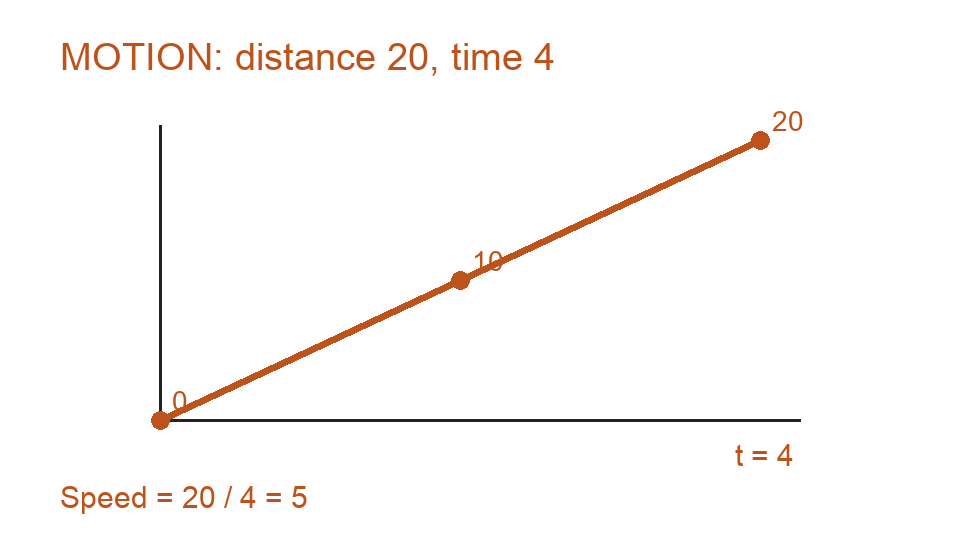
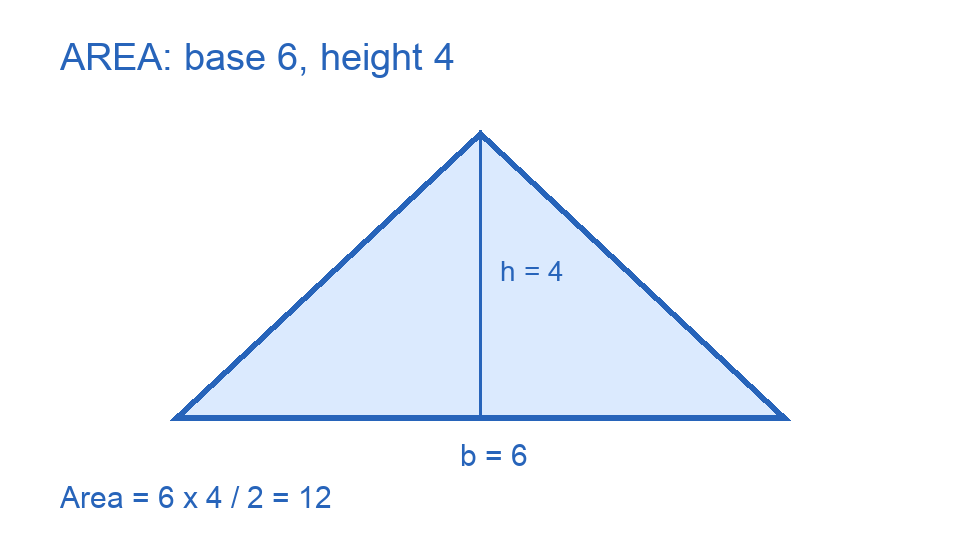
- 打开图片,核对实际像素、图内标题、数字和四边。本例两张PNG都是960×540,分别是蓝色三角形与橙色折线。
- 按用途保存:只要嵌入图片就保留这些文件;需要图注、Word页面样子或图片文字时,分别走页面导出或识别流程。
本页介绍本地解包方法,不是新上线的Doc2X原图提取器。本例已核对两张PNG,其他文档按自己的内容检查。
同一个 DOCX,本地取出两张字节一致的 PNG
源文件是2026-10-16实际导出的自编Word讲义。2026-10-17复制为ZIP,用macOS自带ditto解包到独立目录,核对两张PNG与DOCX内成员完全相同。下面显示的是这些内嵌图片,不是新OCR结果或整个Word页面的截图。
| 操作 | 实际范围 | 本例核对 |
|---|---|---|
| DOCX本地解包 | 文档内嵌图片文件 | 两张960×540 PNG,字节与包内成员相同 |
| Word整页转图片 | 正文、图注与图片合成页面像素 | 另见整页JPG/PNG指南,不当作提取内嵌图 |
| 经PDF解析导出MD图片 | 识别出的图片区域,文字可能另成正文 | 此前实际JPG为851×469和1014×526,橙图底行截断 |
本例解包目录中的图片位置
word/
  media/
    rId21.png
rId25.png- DOCX与改名ZIP副本的哈希完全相同,改扩展名没有改变内容;随后本地解包读取word/media。
- 两张提取PNG与DOCX内同名成员逐字节一致,蓝图和橙图也与此前公开的原PNG一致。
- 文档XML中两条内嵌图片关系分别指向这两个文件;本例没有外链图片,不据此保证任意DOCX都只有这些类型。
- 图内标题与橙图Speed底行在原PNG中可见;此前OCR图块的边界差异另作对照,未把本地原图替换进产品原包。
本例真实执行的是macOS命令行解压和文件级核验,没有声称完成Finder或Windows资源管理器点击实测。解包不会把Word裁切、叠加形状、正文图注自动合成到PNG;没有测试旧DOC、加密文件、外链、矢量或组合图形。核对包由本地整理,包含原稿、提取PNG与此前实际MD图块包,来源分别注明。
先了解这几件事
Word 批量提取图片时,先保留 DOCX 原稿,复制一份改为 ZIP 后解包,查看 word/media。本例从一份 DOCX 取出两张960×540 PNG,字节与包内成员一致,无需先做OCR。这里的原图仅指文档当前保存的图片;要整页外观用页面导出,要提取图中文字再做识别,三种任务不要混用。
- 本地方法
- DOCX副本按ZIP解包;本例用macOS自带解压命令核验,没有产品上传。
- 实际文件
- 47,856字节DOCX内有两张960×540 PNG,18,153和19,401字节。
- “原图”范围
- 指当前DOCX内嵌图片,不保证恢复更早的相机原片或已丢失细节。
- 后续识别
- 图片文字识别是另一项任务,不是取出已有图片的必要步骤。
先按你要保留的内容选择
| 目标 | 选择 | 仍需核对 |
|---|---|---|
| 取得DOCX当前内嵌图片文件 | 在副本中按ZIP解包,查看word/media | 文件格式、像素、内容与正文对应关系 |
| 保留Word里裁切、图注与整页外观 | 在办公软件或已核对的PDF中做页面导出 | 边界、页码、图注;不是原文件字节提取 |
| 识别图片里的文字、公式或表格 | 使用清晰原图进行相应识别 | 识别错字、数学结构、图块与正文关系 |
| 找回文档压缩前更高分辨率原片 | 寻找原始素材或备份 | 解包不能恢复DOCX中没有保存的信息 |
Word 图片怎么保存原图?先看 DOCX 内保存了什么
DOCX是由多个部件组成的文档包。本例word/media里有两张PNG,直接取出可以保留这些成员的原字节;这不等于恢复用户更早插入前的相机原片。文档若曾压缩、替换或缩小图片,应另找原始素材。
Word 批量提取图片后,文件名不一定是图号
本例rId21.png是蓝色三角形,rId25.png是橙色折线。其他文稿可能含页眉图标、重复引用或更多媒体,不能把文件名排序直接当作正文图1、图2顺序。需要归属时,结合文稿页面或图片关系逐项核对。
Word 中裁切过的图片,解包后范围可能不同
内嵌图像文件和页面上显示的裁切、大小、旋转及叠加对象不是同一层。本例核验原图文件字节,没有测试这些显示变换。希望保存看到的整个组合或连同图注时,使用页面导出并检查外观;不要把截取页面称为原图逐字节提取。
Word 图片提取后变小,先确认用了哪条流程
本地解包本例仍是960×540 PNG;同一Word之前经PDF页面识别导出的JPG尺寸与范围不同,橙图底行还被截断。若手里拿到的是OCR图片块,应回到DOCX或原图核对;更换后缀不会找回缺少的范围。
为什么 word/media 里没有预期的全部内容?
正文、表格和公式对象不一定是位图文件,外链图片也可能不内嵌。本页只验证含两张PNG的DOCX,没有保证所有图形、矢量、组合对象或受保护文件都能按相同步骤得到相同结果。保留原稿,按对象类型和原办公软件能力继续处理。
相关官方说明
遇到这些情况
- 改成ZIP后打不开
- 先确认是真正的DOCX副本,并使用能读取ZIP的工具。旧DOC改后缀不转换内容;保留原稿,在原办公软件确认格式。
- 图片与Word里看到的裁切不一样
- 先区分内嵌文件与页面显示效果。需要看到的整页或组合图时,使用页面导出并核对。
- 提取出了图标,找不到正文顺序
- 检查图的内容和文稿位置,不用文件名猜图号;页眉或重复引用也应分别辨认。
- 提取后仍不够清晰
- 查看文档实际保存的像素。解包保持本例嵌入字节,不能补回此前已丢失的分辨率。
常见问题
Word 怎么批量提取图片?
对DOCX保留原稿并复制一份,副本改ZIP后解包,查看word/media。本例取出两张PNG并核对字节,无需先上传或OCR。
DOCX 改 ZIP 会破坏原 Word 吗?
本例只在副本操作,改名后文件字节不变;保留原DOCX并解包到独立目录,避免误改唯一原稿。
提取出来的就是最高分辨率原图吗?
只保证是DOCX当前保存的图片。本例两张PNG与成员字节一致,不能恢复文档未保存的更高分辨率或此前原片。
Word 转 JPG 和提取图片是一回事吗?
不是同一任务。整页JPG把页面变成像素,DOCX解包取出内嵌文件;图注和Word显示效果需要分别处理。
旧 DOC 可以直接改 ZIP 提取吗?
本页未验证旧DOC。先在原办公软件另存DOCX并打开核对,改扩展名不能转换旧格式。
这是 Doc2X 新增的上传提图工具吗?
不是。本页提供本地方法与自编文件核验;需要读取图中文字或公式时,再使用对应识别入口。
内容核对:2026-10-17 · 功能条件与配额以当前产品界面为准