
本页内容
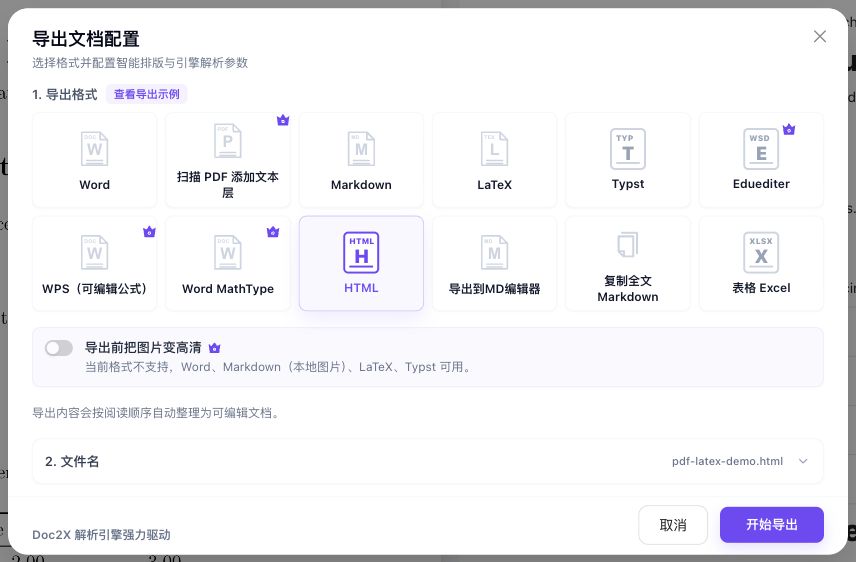
先核对解析内容,再选择 HTML
- 上传自己的 PDF,先检查解析中的标题顺序、表格数据与图注。
- 打开导出配置,选择 HTML;检查当前格式与图片选项,不沿用其他任务的旧选择。
- 下载 .html 后用浏览器重新打开,对照原 PDF 核对正文、数学和图片。
- 需要保存离线副本或迁移网站时,先检查图片是外部地址、相对路径还是内嵌数据,再处理资源并测试目标环境。
入口打开文档上传页;完成解析后需在导出配置手动选择 HTML。本例未开启图片高清。
同一份 PDF 与实际 HTML,下载后逐项核对
2026年10月11日,在既有解析结果中选择 HTML 并完成下载。右图是这个原生文件联网打开的完整浏览器截图,未改写导出正文、样式或公式;下方提供原文件及单独标明的内嵌图片副本。
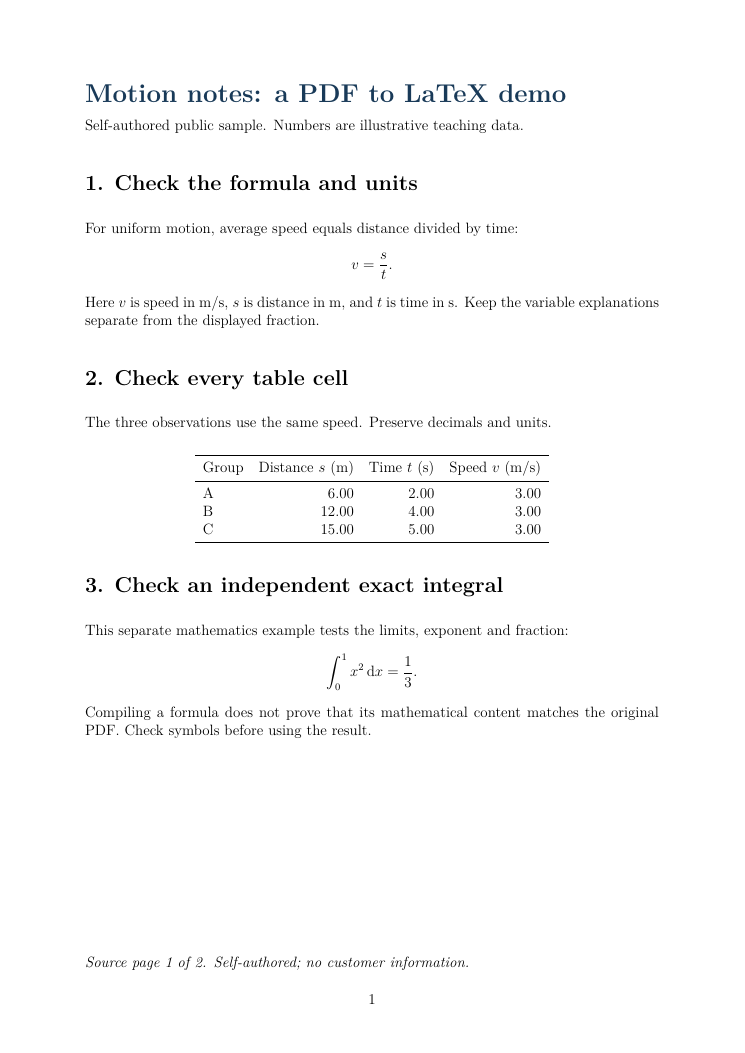
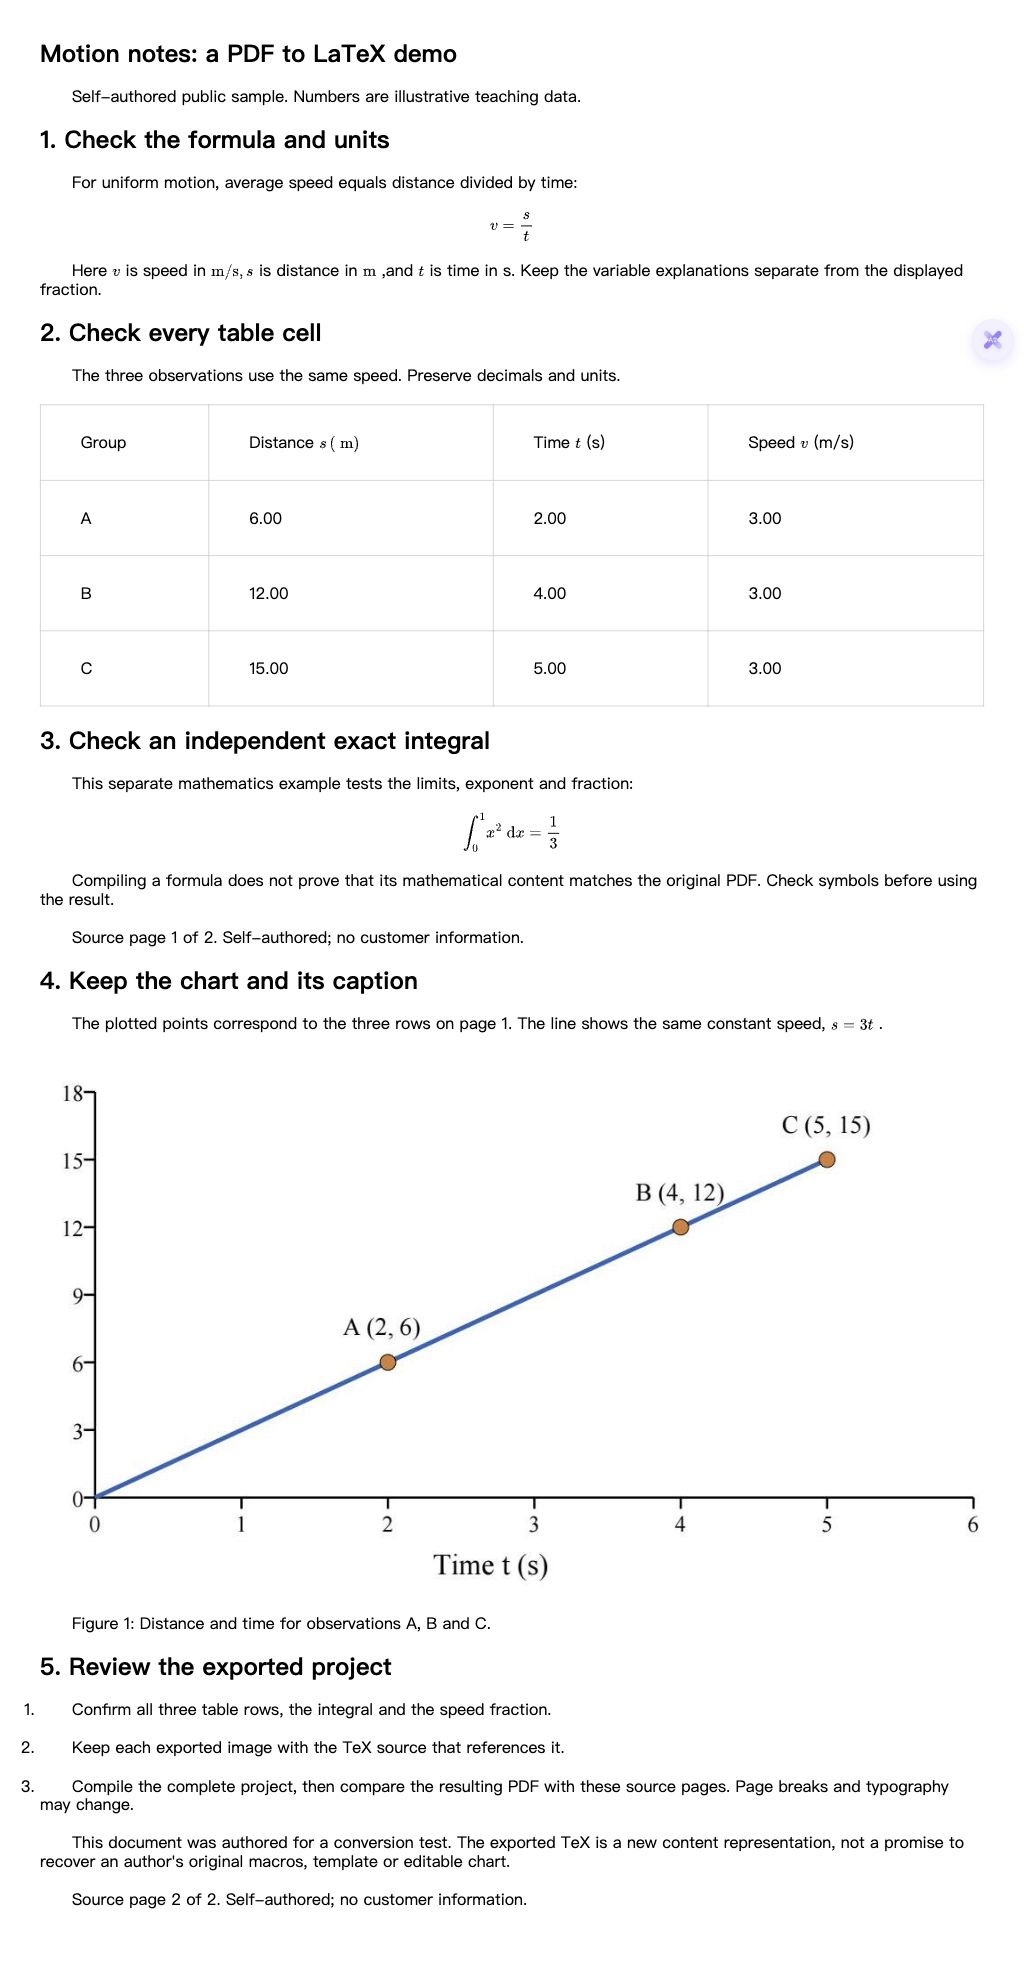
- 三行数据仍为 A:6.00 / 2.00 / 3.00,B:12.00 / 4.00 / 3.00,C:15.00 / 5.00 / 3.00。
- 本例包含两个独立公式和八处行内数学,HTML 中同时有 SVG 显示与 MathML;这里只核对该文件,不推断任意浏览器的复制效果。
- 原 HTML 为 33,916 字节;内嵌图片副本为 70,448 字节,只改了一处 img src,使用同一份 27,456 字节 JPG。
- 在实测 312 CSS 像素宽度,内嵌副本仍有横向溢出。图片带入文件与窄屏排版需要分别处理。
- 原 PDF 图表顶部的距离单位说明在识别结果中已遗漏,两份 HTML 都未补写。让图片成功加载不会补回识别漏行;请对照原 PDF 检查坐标轴、单位和图注。
本例复用此前自编的两页 LaTeX 演示稿及其已完成的解析,原文标题仍为 “Motion notes: a PDF to LaTeX demo”;本次只导出 HTML,没有重新上传或 OCR。只有一个样例,不代表所有 PDF 的转换效果。 核对包为本地整理的 ZIP,包含原 PDF、原 HTML、内嵌副本、JPG 与检查说明;不是产品一次导出的 ZIP。
先了解这几件事
PDF 解析完成后,在导出配置选择 HTML,下载 .html 文件并重新打开检查。本例正文、三行数据表和十处数学表达均可在浏览器查看,但唯一图片仍引用外部 HTTPS 地址;保存一个 HTML 文件不等于图片已全部带入,也不等于已发布网站。
- 实际交付
- 本次原生下载为一个 33,916 字节的 .html 文件。
- 内容结构
- 本例有六个 h2 标题、一张三行数据表和十处数学表达。
- 图片资源
- 原文件引用一张外部 JPG;附有仅内嵌该原图的后处理副本。
- 排版边界
- 连续流显示,原 PDF 分页改变;窄屏仍需调整样式。
一个 HTML 文件里,图片未必在里面
本次实际下载的 HTML 包含正文和内联数学显示,但图像 src 指向外部地址。联网时能看到图,不代表把文件复制到另一台电脑后还能加载。先检查资源形式,再决定是否保存原图并改用相对路径或内嵌数据。
公式、表格与标题分别验收
对照原稿检查分式的分母、积分上下限、单位以及表格小数。本例标题均为 h2,发布到自己的文档站时可按页面结构整理主标题;浏览器显示正常不能代替内容核对。
需要离线阅读时,先处理资源
本页内嵌副本只把同一张 JPG 写入 data URL,文件随之变大。该操作没有修复 OCR、重排表格或修改页面样式;原生 HTML 始终单独保留,便于比较。
手机阅读与网页发布还需整理
本例窄屏有横向溢出,可在自己的副本中为宽表格设置滚动、限制图片宽度,再测试实际屏幕。公开发布另需网页托管、地址、导航与元信息;下载 HTML 不会自动得到公共分享链接。
同源手机阅读副本:保留表格内容,单独横向滚动
2026-10-13 在原有内嵌图片副本上追加阅读样式与表格容器。312、390和1280像素实测没有整页横向溢出,表格末列可用键盘滚动查看;原表格、10处数学标记和图片字节保持不变。它是另存的本地阅读副本,未改写本页原生导出。
相关官方说明
详细操作教程
按目标软件选择文件格式,检查高级选项与下载结果。
遇到这些情况
- 文字与公式都在,只有图片不见了
- 先查 img src 与浏览器网络请求。本例仅拦截外部图片地址就能复现;恢复访问后原文件重新显示图片。
- 图片显示了,但图表单位缺失
- 对照原 PDF 检查识别内容。本例原图顶部说明已遗漏,嵌入相同图片字节不会补回。
- 两页 PDF 变成长网页
- 本例是连续流内容。需要固定原页外观时保留 PDF;网页宽度和分页不等于原 PDF。
常见问题
PDF 转 HTML 下载的是 ZIP 吗?
本例原生下载是 .html 文件。下方 ZIP 是为方便核对而本地整理的包,与产品原生交付分开标明。
导出的 HTML 可以直接离线看吗?
要检查具体文件。本例数学与正文在 HTML 中,图片仍为外部引用;附带的内嵌副本仅针对这张图作本地后处理,不代表产品已默认嵌入所有资源。
PDF 转网页会自动生成公开链接吗?
本页流程得到 HTML 文件。公开网址、托管与访问权限需要另行设置。
HTML 会保留 PDF 每页的外观吗?
本例没有保留固定分页,字体、间距与页面组织也有变化。可查看两份文件逐项比较。
HTML 导出可用公开 API 吗?
这里验证的是网页版。当前公开解析导出接口的 to 参数支持 md、tex、docx;不能直接把网页中的 HTML 选项作为 API 参数。
内容核对:2026-10-13 · 功能条件与配额以当前产品界面为准