
本页内容
先验五处清晰度,再决定重拍、增强或识别
- 打开相机保存的原文件,保留未处理原件。按相同缩放看中央与四角的相近字号,分别检查字形、数字、小数点、正负号和单位;聊天缩略图与被压缩的截图不适合代替原件验收。
- 如果四角已经不可辨,优先重新拍摄或索取清晰来源。让纸面尽量平整,镜头与纸面平行;适当退远,给整页留出完整边界,再按需要裁切,避免为了铺满画面而贴得过近。
- 使用均匀光线并稳住机身,拍摄前后都看四角;保留相机原始分辨率,避免用数码变焦放大画面。具体设备的对焦距离与设置依说明确认,不由这张图片诊断某个镜头坏了。
- 字形仍可辨但有阴影、歪斜或对比不足时,可在扫描增强比较处理前后;边界更齐或背景更白,仍不能代替小字与细线核对。原字无法辨认时不要根据增强生成的细节猜原文。
- 需要可复制或编辑文字时,上传已检查的图像做OCR。回到原图逐处查中央和四角,按稳定位置或标记核对完整句、数字、单位及遗漏;有疑问保留记录,回到清晰来源再修正。
本例两份合成PNG实际完成识别,并各导出一次原生Markdown。两版都遗漏源页脚,模拟稿另有标签与算式错误;没有手机拍摄、物理重拍、镜头诊断或增强前后准确率测试。
中央除号正确,四角却变成加号:不能只验中间一处
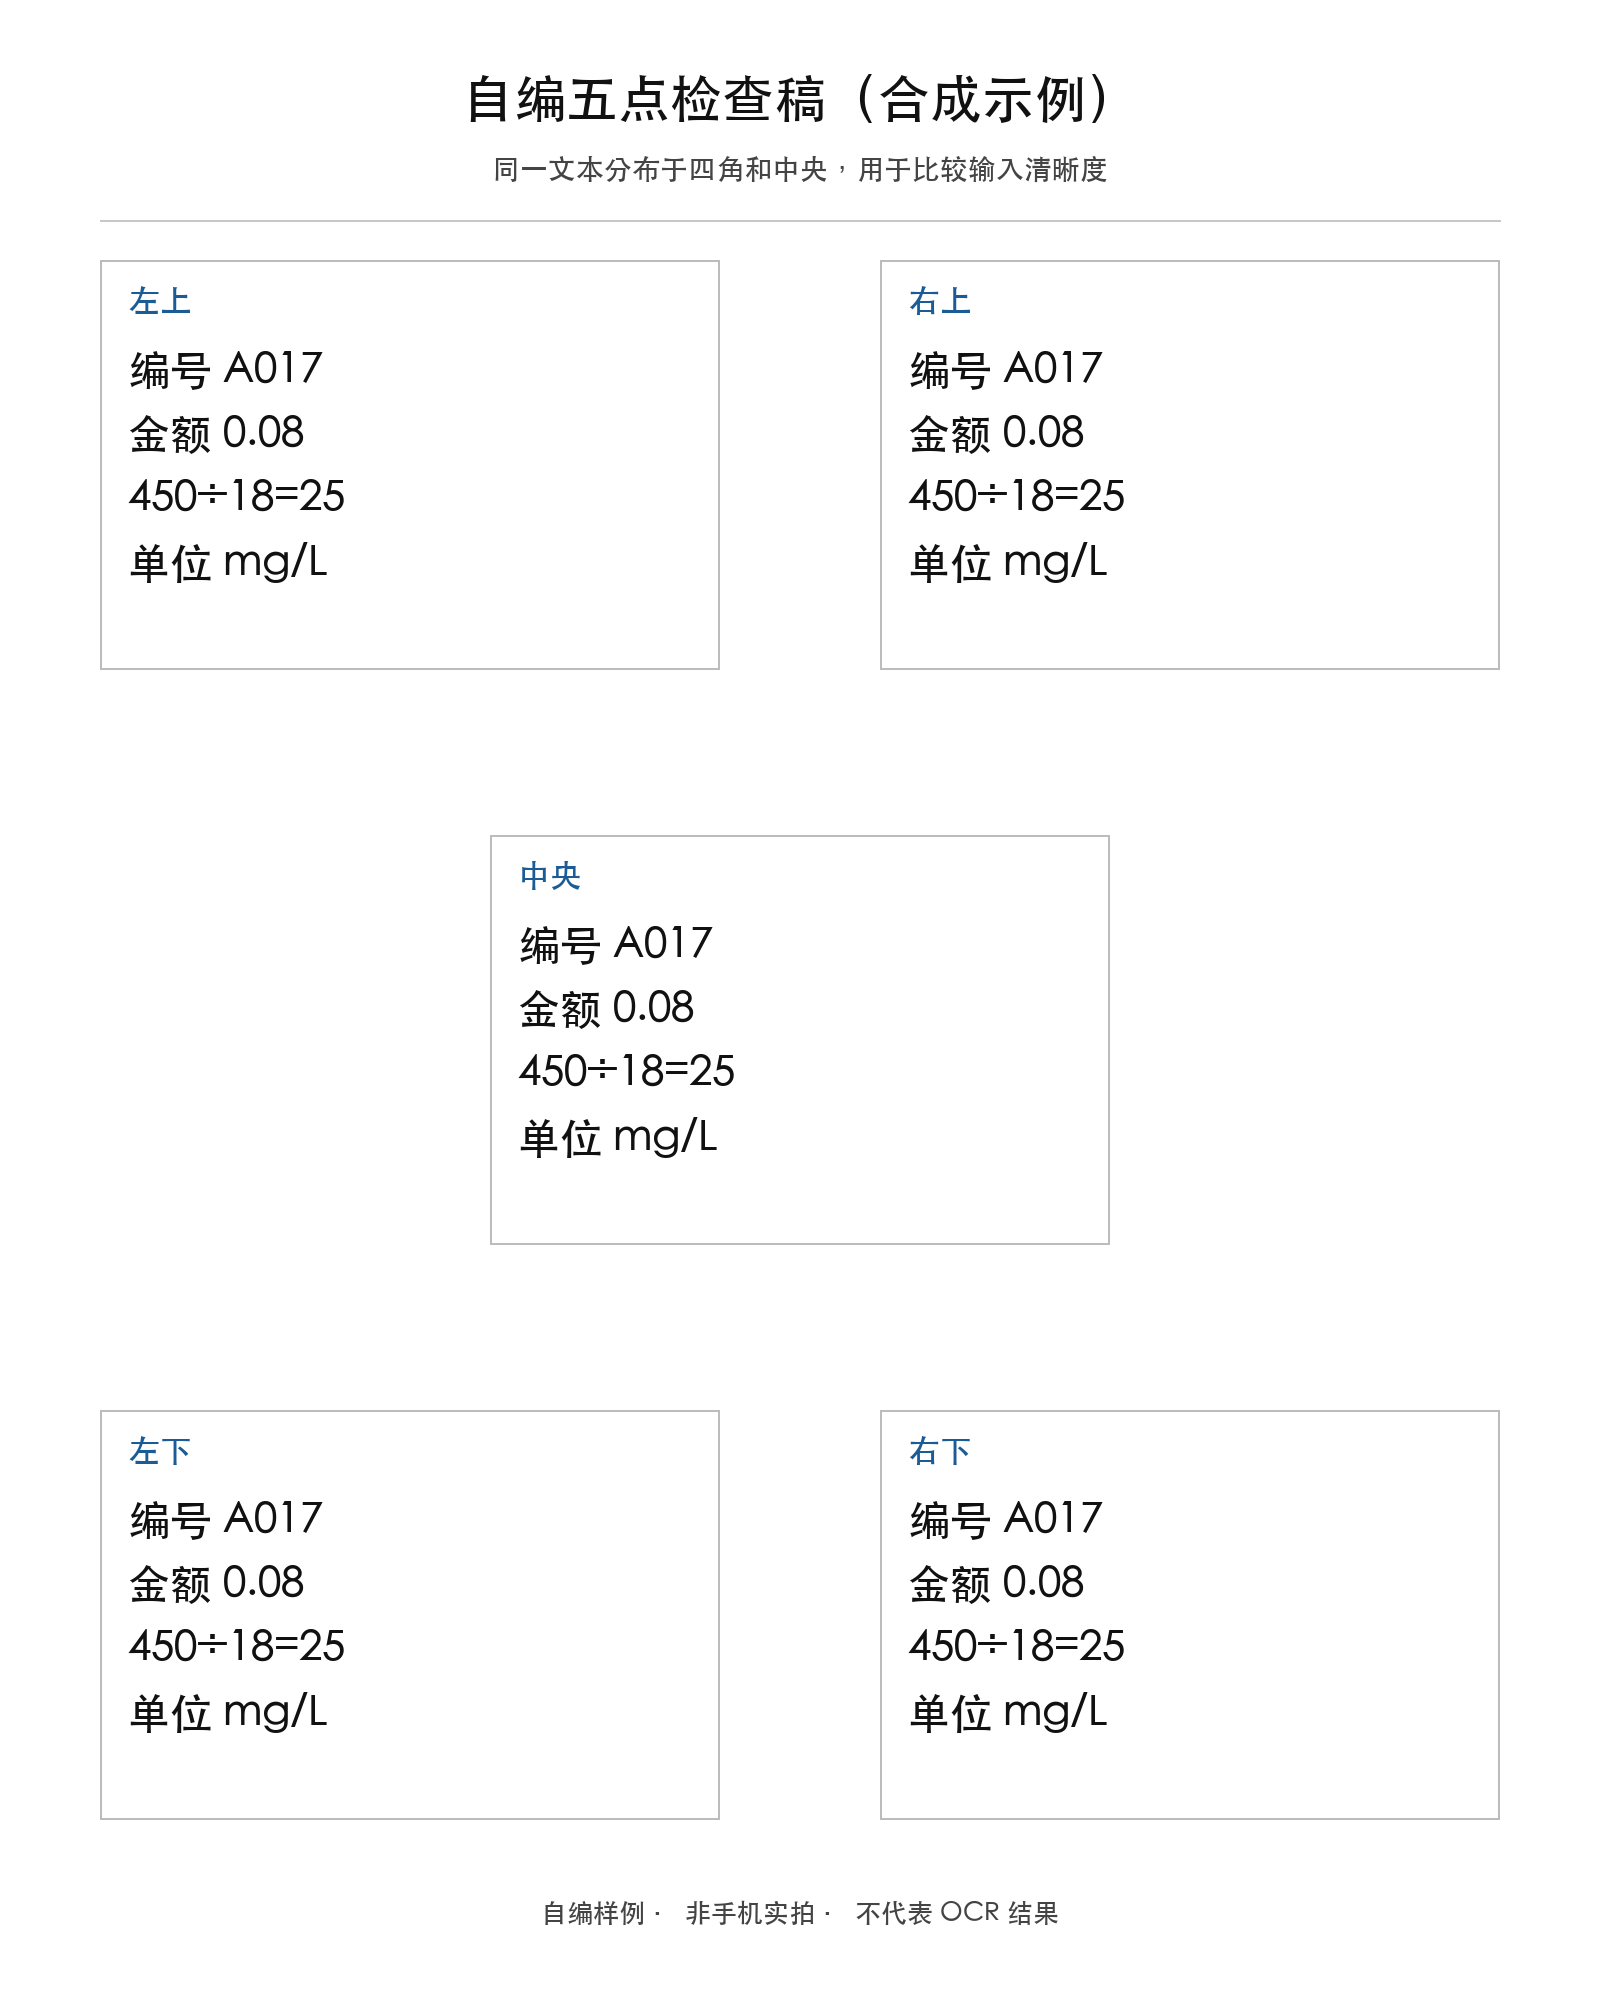
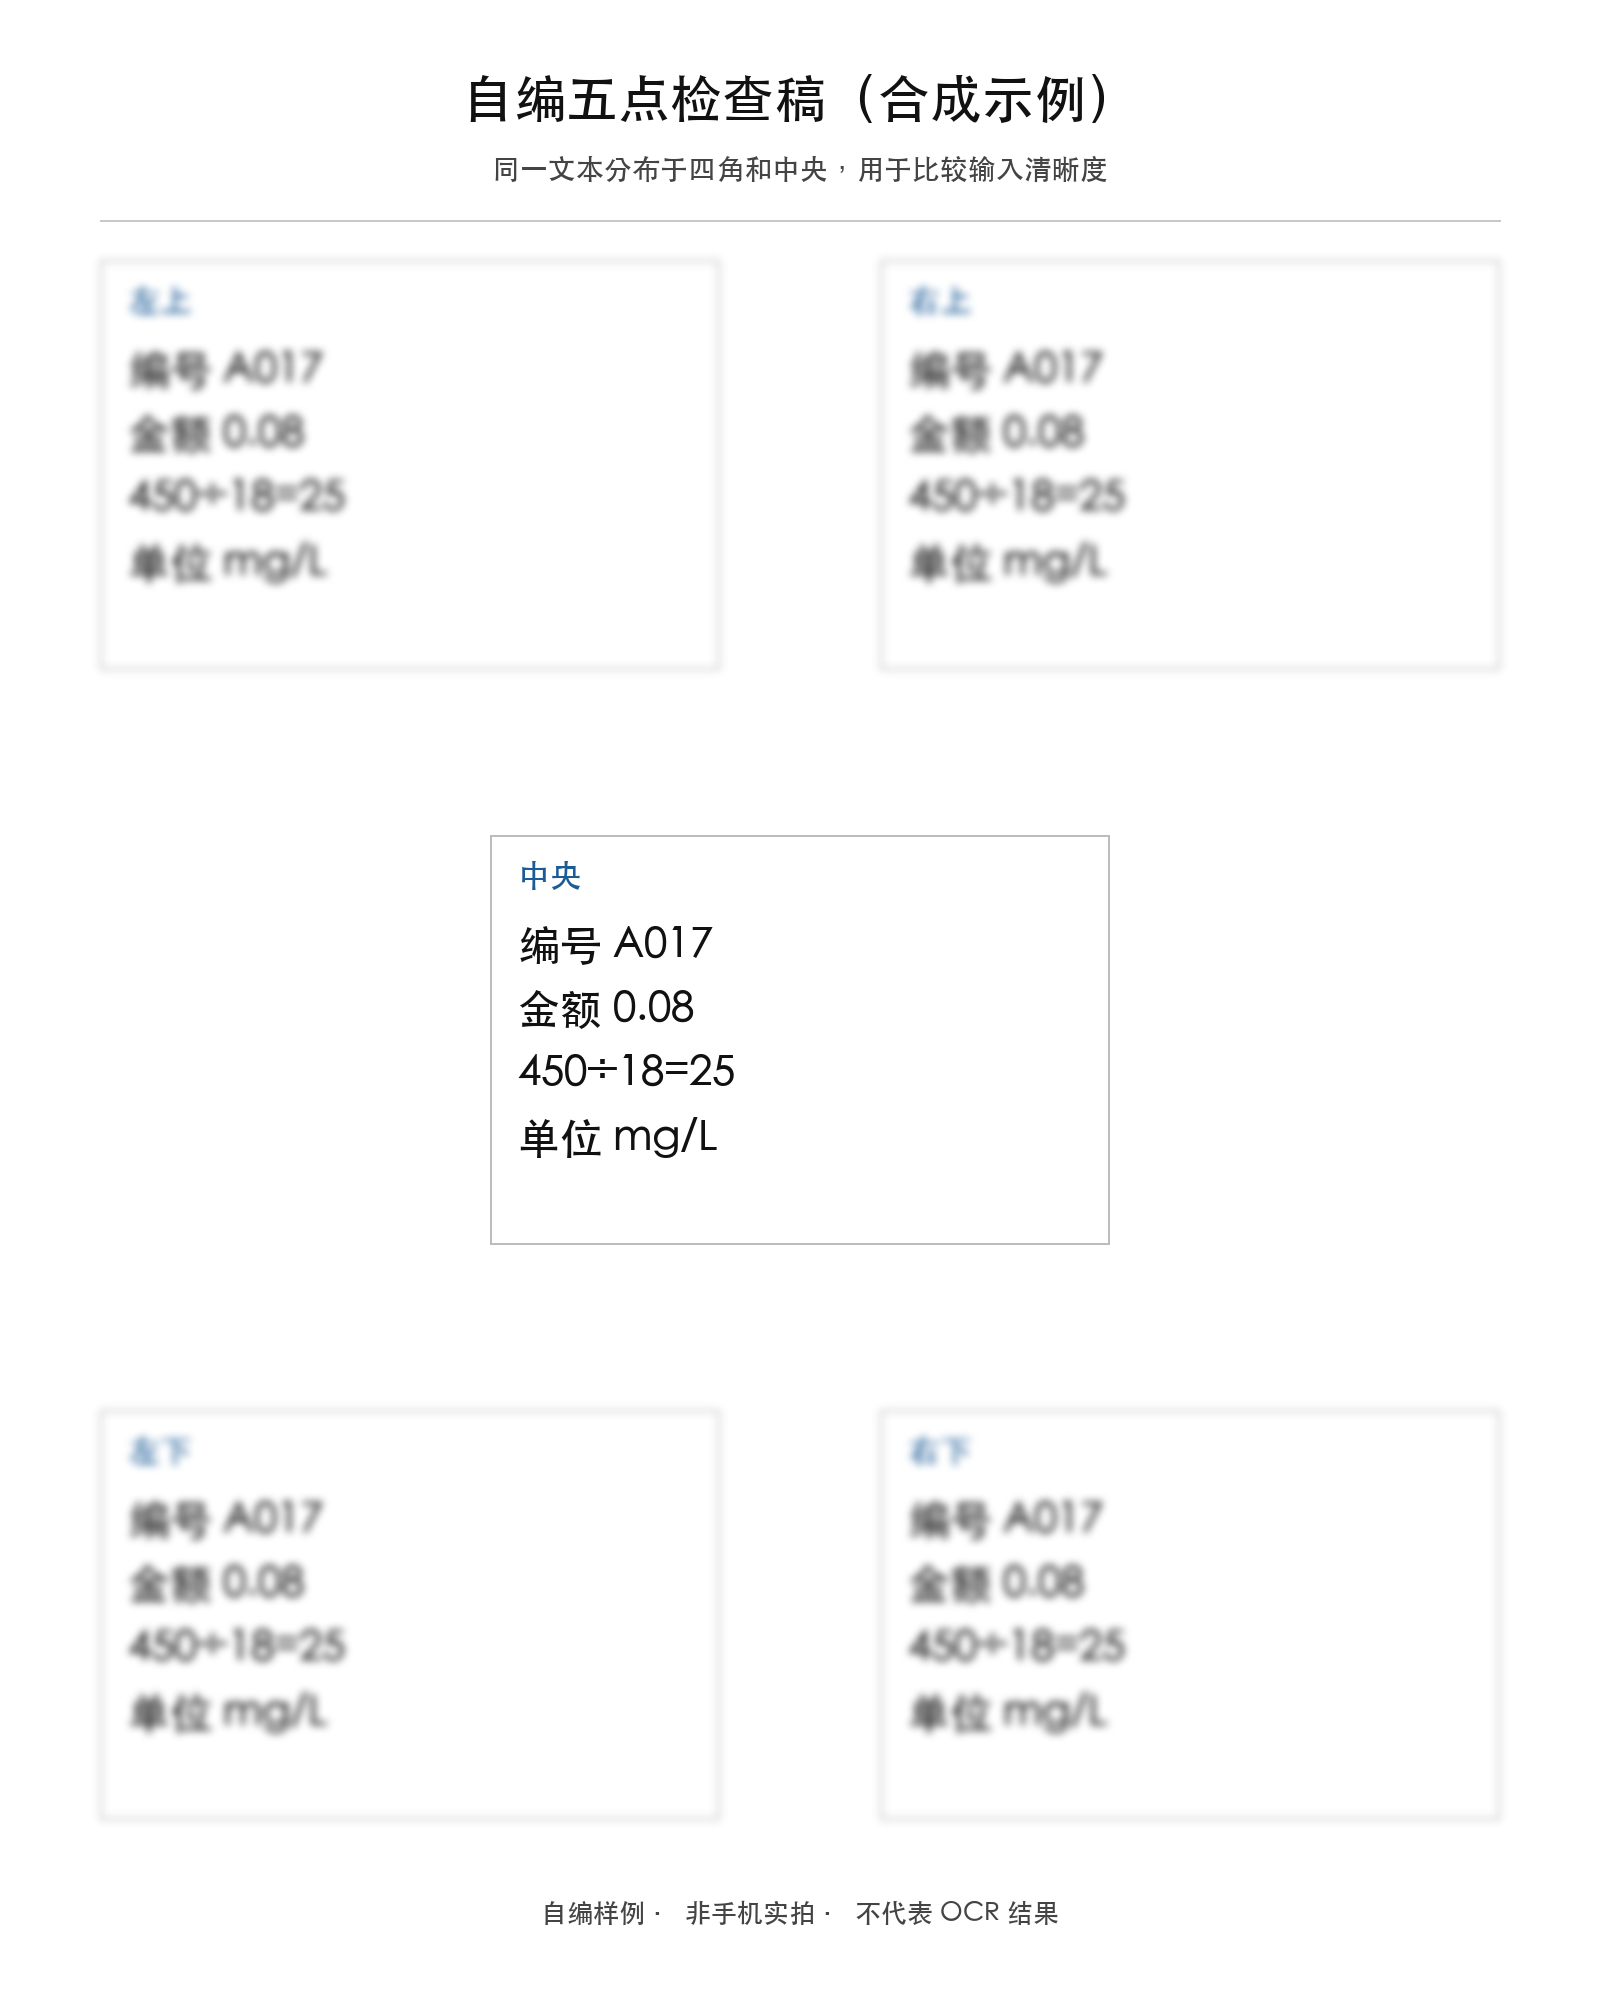
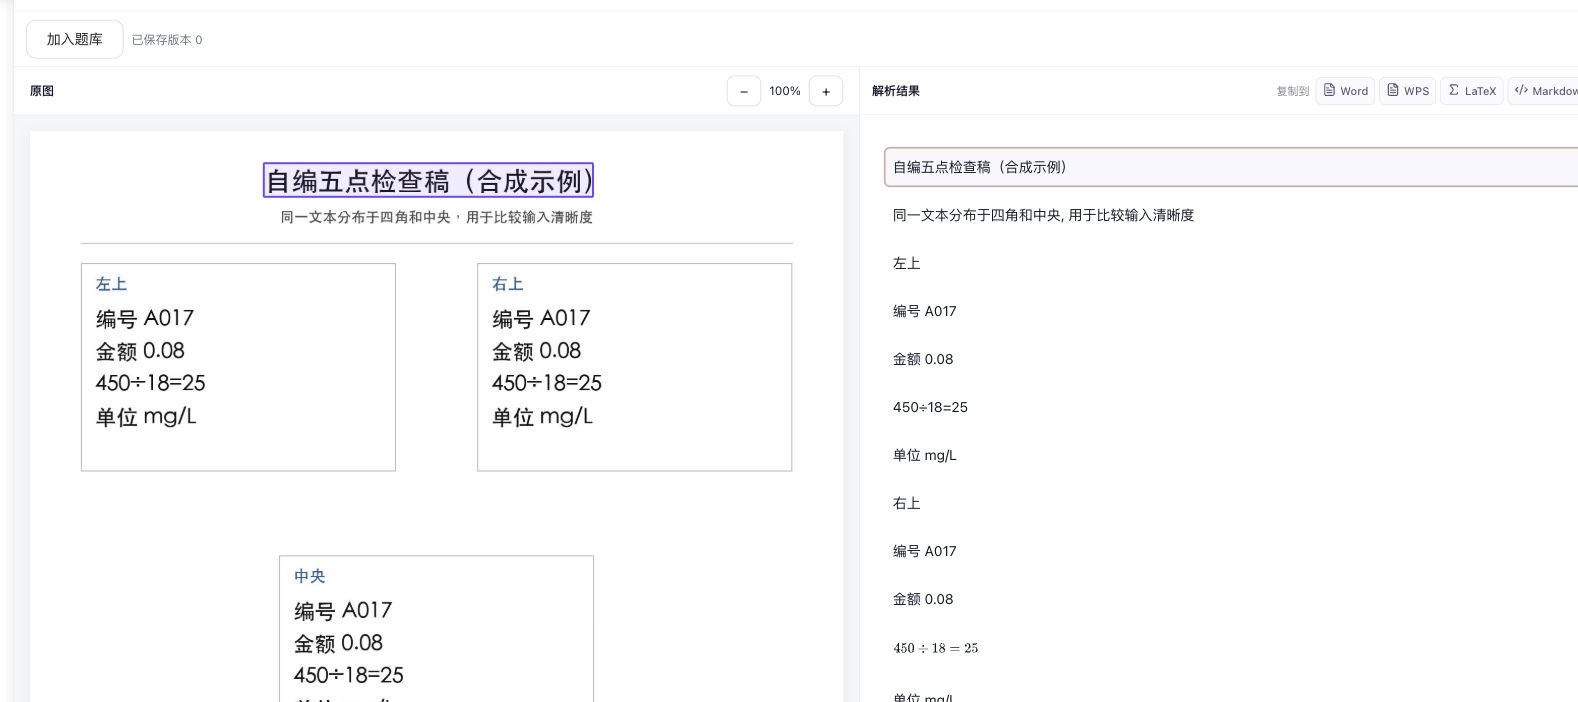
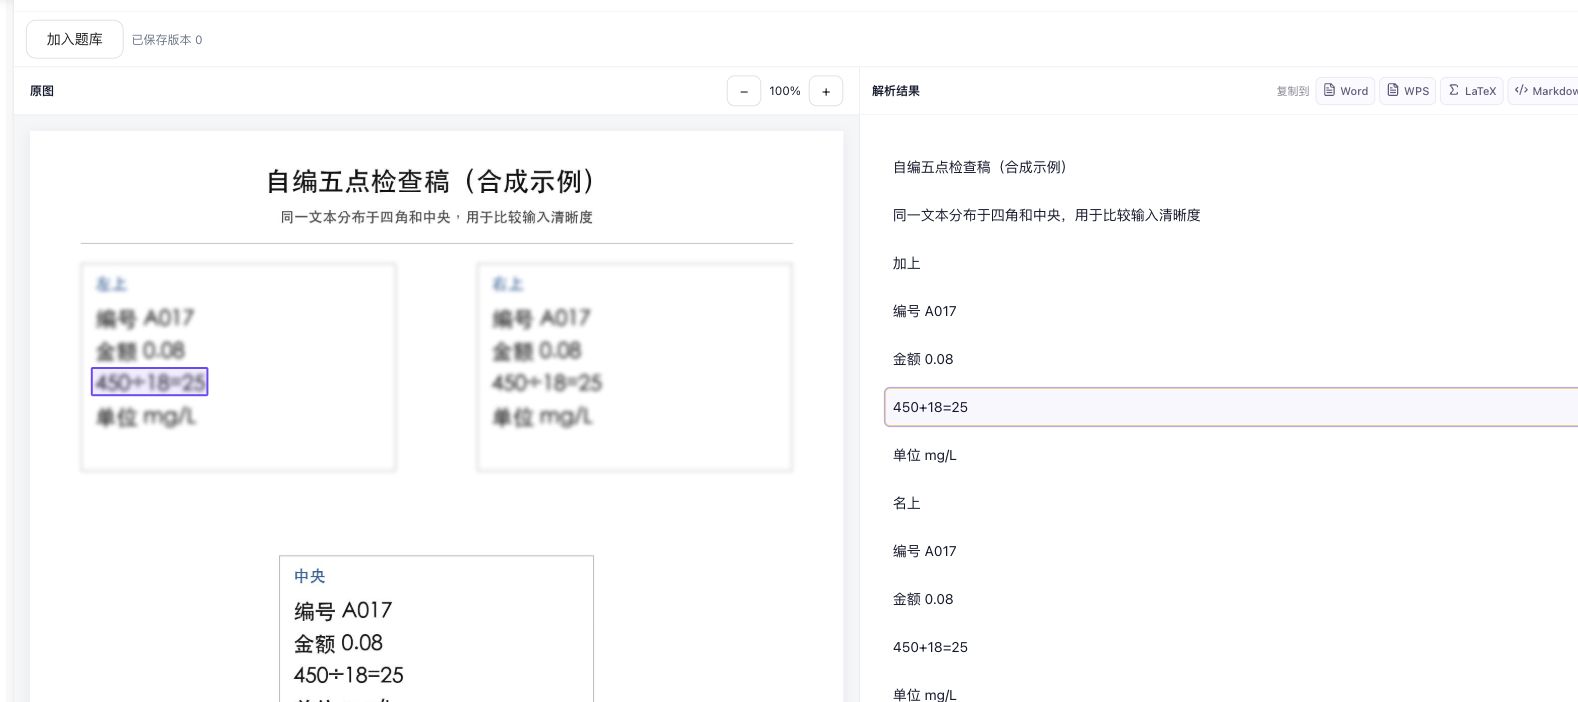
2026年10月20日,将两份自编1600×2000 PNG分别做真实图片识别,并各下载一份原生Markdown ZIP。两图五处同字号核心内容相同,副本仅模拟四角模糊;清晰稿的20个指定字段语义匹配,模拟稿16个匹配,四角算式均把÷识为+,中央仍为÷。这是指定字段的对照,不能当全文准确率。
 查看原图 ↗
 查看原图 ↗
 查看原图 ↗
 查看原图 ↗
| 源位置 | 清晰稿算式(语义规范化) | 模拟稿实际算式 | 编号/金额/单位(两版) |
|---|---|---|---|
| 左上 | 450÷18=25 | 450+18=25 | A017/0.08/mg/L |
| 右上 | 450÷18=25 | 450+18=25 | A017/0.08/mg/L |
| 中央 | 450÷18=25 | 450÷18=25 | A017/0.08/mg/L |
| 左下 | 450÷18=25 | 450+18=25 | A017/0.08/mg/L |
| 右下 | 450÷18=25 | 450+18=25 | A017/0.08/mg/L |
- 每图仅选择五处×四字段=20项:编号、金额、算式、单位。清晰稿20项语义匹配;模拟稿16项匹配,4个四角算式把除号识为加号。它们不是全页正确率,位置标签与页脚不在这20项内。
- 清晰稿右上与中央的算式在原生Markdown使用数学定界符、数字花括号和\div;对照时仅规范化为450÷18=25,没有把加号改回除号,也没有改写原生文件。
- 模拟稿的左上、右上、左下、右下标签分别成为“加上”“名上”“在下”“名下”;中央标签仍为“中央”。不能把位置标签错误藏进20项字段匹配数。
- 两份原生Markdown各有27段,均未包含源图页脚“自编样例 · 非手机实拍 · 不代表 OCR 结果”;标题另带Markdown二级标题标记并使用半角括号。清晰稿也不能称为全文无误。
- 清晰稿原生ZIP412字节、内含未改写Markdown438字节;模拟稿ZIP385字节、内含Markdown397字节。两个ZIP各只有一个MD;下载原包与提取原文均保留原字节,没有补尾换行。
- 两张结果截图仅展示原图、结果上部及左上定位;完整五点对照来自原生Markdown与40行本地逐项CSV,不把截图当作全部检查点或模型信息证明。
两图均为自编合成稿,副本仅在四角mask内应用GaussianBlur(radius=4),中央与mask外像素不变;不是手机实拍、真实镜头失焦、物理重拍或质量基准。两份原生结果都遗漏页脚,模拟稿另有四个位置标签错误和四个算式错误。仅核对本次五处指定字段,不证明真实手机病因、全部文档准确率或增强恢复效果。本轮未执行扫描增强、AI图像增强、编辑保存或剪贴板复制;页面建议与本次实际操作分别理解。
先了解这几件事
手机拍照文件中间清楚、四周模糊时,先打开相机原文件,用相同缩放检查中央、左上、右上、左下、右下五处的相近字号。四角已经看不清原字,优先重拍或索取清晰原稿:让纸面平整,镜头尽量与纸面平行,适当退远,保留足够原始分辨率,避免数码变焦;光线均匀并稳住机身。只是阴影或对比不足且字形仍可辨时,再比较扫描增强。需要OCR时继续逐处核对文字、数字与单位,不能凭中间一段通顺就认定整页完整。
- 检查位置
- 中央与四角按相同缩放、相近字号检查;不要只看缩略图或只选中央。
- 先重拍的情况
- 原文件边缘的数字、单位或字形已无法辨认;增强和OCR都不能保证恢复真实原字。
- 样张来源
- 自编清晰PNG与仅四角模糊的模拟副本,不是手机实拍,也不是镜头或相机故障诊断。
- 本次指定字段
- 五处各4字段;清晰稿20项语义匹配,模拟稿16项匹配,四角除号均变加号;不等于全文正确。
中间可读后,还要决定四角如何处理
| 原文件看到什么 | 先做什么 | 继续处理后仍要核对 |
|---|---|---|
| 中央清楚,边缘数字或单位已不可辨 | 重拍,或索取原电子稿与清晰来源 | 五处字形、完整边界;不要猜被模糊掉的值 |
| 文字可辨,但纸面歪斜或有阴影 | 保留原图,比较扫描增强 | 正文、浅字、细线与边缘有没有丢失 |
| 五处都能读,需要复制或编辑 | 继续OCR并逐处对照 | 数字、单位、遗漏与输出格式 |
| 只希望插图更适合展示 | 先查看图片高清化的范围与当前报价 | 生成式处理可能改文字或细节,不能当恢复原文依据 |
手机拍照文件边缘模糊,先用同一标准看五处
把中央与四角的小字放在同一检查标准下:相同缩放、相近字号,并看具体字形与数字。只把中央放大、四角仍看缩略图,容易漏掉边缘问题。本页自编样张把同一核心句放在五处,是演示对照方法,不是用一个中央清晰区域代表整页。
中间清楚四周模糊,不由一张照片判断手机病因
先调整可复查的拍摄条件:保持纸面平整、镜头与纸面平行,适当退远并保留完整边界;再检查均匀光线、机身稳定和原图分辨率。不同设备、纸面起伏与拍摄距离可能影响结果,单张照片不能确定具体镜头、硬件故障或唯一原因。
拍照文档四角文字看不清,优先找回清晰来源
原图里已经分不开的字形、数字或小数点,不宜只靠增强后看起来更锐就确认。能重拍时先重拍,能找到原电子稿时优先使用来源。扫描增强更适合对照边界、阴影和画面效果;图片高清化属于另一流程,其生成式细节仍需核验。
模糊照片OCR前怎么检查,识别后还要回到五处
先看原图,确认五处的目标内容是否可辨,再识别。结果段落完整、语言通顺或显示完成,不能证明每个边角都正确。按位置核对同一句中的数值、符号和单位;若结果改变或漏掉某处,不把它默认为源稿本来如此。
相关官方说明
遇到这些情况
- 中央一段正确,就准备交付整页
- 补查四角、页脚与边注的相近字号;每处数字和单位都对照原文件。
- 增强后像是某个数字,但原图认不出
- 回到清晰来源确认;不能把生成的细节当作原字已经恢复。
- 退远后整页仍太小,靠数码变焦放大
- 保留高分辨率原图,按设备能力重新构图;不要用放大的预览代替实际像素检查。
- OCR语句流畅,却与边角原文不一致
- 记录对应位置与差异,保留原件,依据能辨认的来源校对;必要时重拍后再识别。
常见问题
清晰稿20个指定字段匹配,说明全文正确吗?
不能。20项只含五处编号、金额、算式与单位,不含位置标签和页脚。两份原生Markdown都遗漏源图免责声明,标题括号样式也有差异;模拟稿四个位置标签另有错误。
手机拍照文件中间清楚四周模糊怎么办?
先在相机原文件按相同缩放看中央与四角的相近字号。四角原字已不可辨时优先重拍或找清晰原稿:纸面平整、镜头平行、适当退远、均匀光线并稳住机身;不能据此诊断具体手机病因。
手机拍照文件边缘模糊,扫描增强能恢复原字吗?
不能保证。原字可辨而有阴影或对比不足时,可以保留原图比较增强效果;原字已糊到无法区分时,应先重拍或找来源,不能凭更锐的细节确认原文。
拍照文档四角文字看不清,为什么不能只检查中间?
中央可读不能代表边缘也可读。四角可能包含页码、注释、金额与单位;用相同缩放和相近字号逐处查具体字形,识别后也逐处对应。
模糊照片OCR前怎么检查?
先保留原文件,检查中央与四角的字形、数字、符号和单位。需要识别时对照每处的完整内容;任务完成或语句流畅,都不能单独证明整页准确。
本页样张是手机实拍吗?
不是。两份输入是自编清晰PNG和仅四角区域模糊的模拟副本。真实产品识别记录只对应这两份输入,没有拍摄设备、镜头或真实手机照片测试。
内容核对:2026-10-20 · 功能条件与配额以当前产品界面为准