
本页内容
先选具体结果,再核对真实文件数
- 打开全部历史,进入多选文件模式,勾选需要的解析或翻译子记录。
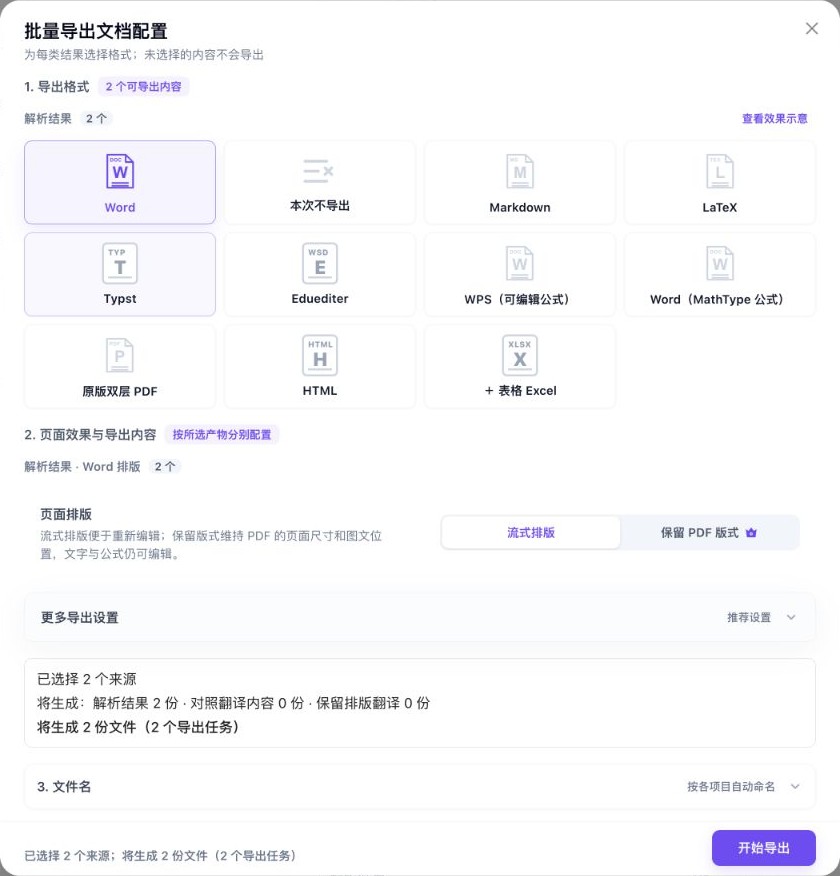
- 点击批量导出,按结果类别选择格式;本例选择解析结果 → Word → 流式排版。
- 核对来源数量、文件名规则和预计文件数。本次不导出时不会生成对应内容。
- 点击开始导出,在全局任务浮窗查看每一项状态,保持页面打开。
- 到浏览器下载记录和保存目录核对每份文件;缺失项单独记录,先保留已有成功文件。
- 打开实际文件,比较来源标题、内容范围、表格和单位。若持续缺失,保留时间、任务状态和提示再排查,避免无界重试。
需要登录查看自己的历史。导出期间保持页面打开,保留完成与缺失清单;不要把这一步当作重新解析。
两个来源、两个完成标记,实际文件仍要逐份核对
从已有的两份 Cedar 自编 PDF 解析记录勾选结果,选择 Word 与流式排版。配置显示将生成两份文件;初次队列两项均显示完成,但下载目录只观察到 A 的 DOCX。本例保留这个不完整结果。
| 字段 | DOCX 中的文字 |
|---|---|
| Observation period | 7 days |
| Number of trays | 6 |
| Number of seedlings | 18 |
| Daily water total | 450 mL/day |
| Temperature | Not recorded |
- 本轮没有上传、重新解析或新建翻译。输入是此前已成功解析的两份自编虚构资料,A、B 原 PDF 已公开。
- 初次选择两个解析结果,配置预计两个 Word 导出任务。队列中的两个项目都出现完成图标,但下载目录只观察到 cedar-notes-a.docx。
- A 的实际 DOCX 为 13,062 字节,包含一张五行两列原生表格;7 days、6、18、450 mL/day 和 Not recorded 可与原稿对照。
- 随后只对缺失的 B 做了一次单项重导,并从 B 的已有结果详情再导出一次,仍未观察到 B 文件。没有把这两次尝试记为恢复成功,也没有重复导出 A。
这里只验证本次网页历史导出及 A 文件内容,不是客户端批量解析实测。B 未落盘的具体原因尚未确认,没有修改浏览器下载权限。外层 ZIP 为本地整理的核对包,包含两份原稿、唯一取得的 A 成品及观察记录,不是产品自动打包的批量 ZIP;没有补造 B 成品。
先了解这几件事
已有成功解析记录时,可进入全部历史的多选文件模式,勾选需要的解析或翻译结果,再按类别选择导出格式。开始前核对预计文件数,完成后逐份检查保存目录。本例两项队列均显示完成,但仅拿到 A 文件,所以不能仅凭完成图标认定整批已下载。
- 起点
- 登录后的云端历史;选择已有解析结果,不重新上传。
- 本例配置
- 两个解析来源,Word、流式排版,预计两份文件。
- 实际观察
- 只有 A 的 13,062 字节 DOCX 被确认取得;B 未确认。
- 文件组织
- 本例为各来源单独导出,不能期待自动合成一份 Word 或统一 ZIP。
把三个完成状态分别确认
| 检查位置 | 能确认什么 | 还需核对 |
|---|---|---|
| 导出配置 | 选了哪些结果与格式、预计几份文件 | 未选内容不会自动包含 |
| 任务队列 | 当前项目的处理状态 | 完成图标不代替磁盘文件检查 |
| 浏览器与保存目录 | 是否实际收到每份文件 | 文件名、时间、大小和内容是否匹配 |
| 打开成品 | 文字、表格和其他输出是否可用 | 下载成功不等于所有内容正确 |
选来源与选结果是两步
同一来源可能有解析、对照翻译或保版翻译等子记录。勾选项目之前先确认自己需要哪种结果,随后在配置中为相应类别选格式;不要把一个来源默认理解为所有结果都会下载。
用预计文件数检查配置
本例未选格式时预计零份,选择 Word 后预计两份。来源数与导出文件数不是永远一比一,还可能受选中结果类别和附加输出影响,应读取当前配置摘要。
两个完成标记不是两个已保存文件的证据
本轮初次任务均出现完成图标,但保存目录只找到 A。B 的单项与详情导出也没有确认落盘;我们保留事实,不把原因直接归为浏览器权限、网络或服务故障。
缺失时先核对下载记录与位置
查看浏览器下载列表、保存路径、时间和同名后缀,再检查是否有未完成或被取消的下载。浏览器可能还有自己的提示,应按实际提示处理;不要为此删除账户记录或重新解析整批文件。
导出文件和本地永久存储不同
取得一个 DOCX 是导出结果,不会自动建立客户端永久存档。长期保存还需按本地存储流程保留原件与必要资源,云端临时记录的可用期限另行确认。
相关官方说明
详细操作教程
选择具体解析或翻译结果,配置格式并核对实际文件。
遇到这些情况
- 开始导出不可用或预计零份
- 先为已选结果类别选择格式,不要只勾选来源而保留本次不导出。
- 任务完成,目录只有一份
- 逐项核对下载记录、实际保存位置和文件名,保留已取得文件;本例未确认 B 的根因。
- 重导仍无文件
- 停止反复点击,保留尝试时间、当前提示和缺失项信息,继续检查现有任务与下载状态。
- 下载的文档与来源不符
- 打开文件核对标题和内容,不只依靠相似文件名判断。
常见问题
批量导出会重新 OCR 两份原稿吗?
这次从已有解析结果导出,没有重新上传或解析。失效记录是否能继续导出应以当前错误提示为准。
是否把两份 PDF 合并成一个 Word?
本例预计每个来源分别生成 Word,并非合并为一个文件。需要合并应使用相应独立流程。
页面显示成功,是否就能关闭浏览器?
先确认所需文件实际到达保存目录并能打开。队列图标与文件落盘应分别检查。
本次缺失的 B 最后恢复了吗?
没有。单项重导和详情导出后都未观察到 B 文件,原因尚未确认;核对包只提供实际取得的 A。
所有文件自动打成一个 ZIP 吗?
本例队列按文件导出,未验证自动统一 ZIP。页面的核对 ZIP 是本地整理的证据包。
内容核对:2026-10-12 · 功能条件与配额以当前产品界面为准